月別アーカイブ: 2026年10月

「VulnOps:AI時代の脆弱性管理」を公開しました!

本書「VulnOps:AI時代の脆弱性管理」は、CSA本部が公開している「VulnOps: Vulnerability Management in the Age of AI」の日本語版で、リサーチノートです。

資料はこちらからダウンロードしてください。

AIによる脆弱性の自動発見でCVEの登録件数が急増する一方、米国のNVDは2026年4月に情報付与(エンリッチメント)の対象を一部に限定し、公表から悪用までの時間も数時間単位にまで縮まっています。本書は、定期スキャンと四半期ごとのパッチ適用を軸とする従来の脆弱性管理はもはや通用しないと指摘し、脆弱性への対応を絶え間ない流れとして回し続ける運用手法「VulnOps」を提唱しています。そのうえで、継続的な発見、リスクベースの優先順位付け、修正の自動化など6つの基本原則と、組織が最初に取り組むべき3つの施策を示しています。

本書の背景には、Anthropicの「Claude Mythos Preview」をはじめとする高性能なAIモデルが、未知の脆弱性を大量に発見できるようになったことがあります。これを受けてCSAは、SANS、OWASPなどと共同で2026年4月に「The AI Vulnerability Storm: Building a Mythos-ready Security Program」を公表し、AIによる脆弱性発見の時代に備えた「Mythosレディー」なセキュリティプログラムの構築を呼びかけました。「Mythosレディー」ではその柱の一つとして、VulnOpsを組織の恒常的な機能として立ち上げることを求めています。本書は、そのVulnOpsとは何か、なぜ必要なのかを掘り下げています。

また、VulnOps、CTEMの実装について、以下のブログを公開していますので、合わせてご覧ください。

「Mythosレディ」とは何か(続編-3)~ VulnOps と CTEM を実装する実施例

以上

PHP2Shell(PHP騒動)をMythosレディの観点から読み解く ~ 3層モデルによる評価、国内外の対応比較と今後の推奨

2026年10月24日
AIWGメンバー 諸角昌宏

本ブログは、CSAジャパンとしての正式な見解ではなく、あくまで筆者の個人的な意見としてまとめたものである。しかしながら、この問題はクラウドセキュリティに関わる人に幅広く関係することとして、このCSAジャパン・ブログに掲載させていただく。皆さんの屈託のないご意見をいただければ幸いである。

エグゼクティブサマリー

  • 何が起きたか:PHP本体に、認証なしで任意コード実行(RCE)に至る可能性がある2件の重大な脆弱性(CVE-2026-109618/109619、通称PHP2Shell、CVSS v4.0で9.2)が見つかった。PHP 5.4以降、修正版より前のバージョンが影響を受ける。本脆弱性はPHP本体のリクエスト処理に起因するため、アプリケーション側の認証・入力検証だけでは根本的に解消できない[1][23]。
  • AIの役割:Calif(OpenAIの「Patch the Planet」の中でGPT-5.6 Solを使用)、OpenAI、Wizが、それぞれAIを使って独立に発見した。欠陥自体は10年以上前からあった。Wizは、AIによる分析が脆弱性の理解や、実際に動作する攻撃コードの作成・標的ごとの調整を支援したと説明している[1][2][3]。
  • 防御側の窓は開いたが、早く閉じた:発見から公開まで約2か月半あったが、10月20日に情報がリークし、公開の4日前(10月17日)から悪用の試みが観測されていた。公開から1日足らずで、攻撃の試みは数百万件規模に達した[10][11]。
  • 国内外で予防停止が広がった:欧州では、複数の政府機関や公共サービスが予防的にサイトを停止した[17][18]。日本でも首相と国家サイバー統括室が深夜に呼びかけ、省庁・自治体・銀行・交通まで停止が広がり、停止告知は502件を超えた。このうち285件は、調査対象のX上で再開告知を確認できなかったものであり、実際の停止継続件数とは一致しない可能性がある[26][30]。
  • 被害:2026年10月23日時点で、確認した公開情報の範囲では、PHP2Shellを原因とする被害を公表した国内組織は確認できなかった。CISAのKEV(悪用が確認された脆弱性の一覧)にも未登録である[12][31]。
  • 3層からの示唆:止める範囲と戻す速さには、第1層(資産管理・EOL管理)の成熟度が大きく影響したと考えられる。今回は、防御側のAIを活用した脆弱性発見と協調開示によって、修正準備の時間を確保できた事例である。ただし、攻撃側より防御側が常に先行できることを示すものではない。次は「攻撃側のAIが先に見つける」前提で、第2層(侵害前提の封じ込め)と第3層(VulnOps・CTEM)を同時に育てる必要がある。

1. Mythosレディの3層モデル

「Mythos」は、Anthropicが2026年4月に発表したAIモデル「Claude Mythos Preview」に由来する。このモデルが、脆弱性の発見から攻撃コードの作成までを機械の速度で行えることを示したことを受け、CSA・SANS・OWASPなどが2026年4月に緊急公開した文書「AI脆弱性の嵐(AI Vulnerability Storm):『Mythosレディ』なセキュリティプログラムの構築」[36]が、「Mythosレディ」という言葉を広めた。同文書は言葉を明示的には定義していないが、AIによる脆弱性発見の急増に備えて、今すぐ取り組むべき対策を示している。

以前のブログ「Mythosレディとは何か」[33]は、同文書を踏まえ、これを「機械速度の攻撃が常態化した世界において、組織が生存できる状態を継続的に維持すること」と定義している。特定のAIモデルへの対抗策ではなく、その背後にある構造的なリスクに継続的に適応し続けられる組織の状態である。PHP2Shellでも、発見に使われたのはMythosではなく、他社のAIモデルだった[1][3]。

同シリーズでは、Mythosレディの目的を「コントロール可能な状態」、すなわち攻撃を100%防ぐことは不可能でも、影響を封じ込め、迅速に回復し、次の攻撃に備えられる状態を維持することに置いている[33][37]。そして、それを実現する道筋として、基本的なセキュリティ対策、ゼロトラスト、VulnOps・Agentic Control Planeの3層を定義している[37]。本書でも、この枠組みに沿ってPHP2Shellを評価する。

層主な内容役割
第1層
基本的なセキュリティ対策
資産管理、パッチ適用、ログ収集と保全、バックアップと復旧手順、インシデント対応手順他の層が機能するための土台。守る対象が分からなければ何も守れない
第2層
ゼロトラスト
守るべき資産(プロテクトサーフェス)ごとに「信頼せず、常に検証する」設計。最小権限、セグメンテーション、継続的な監視侵入される前提で、被害を封じ込め、攻撃者の難易度を構造的に上げる
第3層
VulnOps・CTEM・Agentic Control Plane
悪用される前に脆弱性を見つけ、事業への影響で優先順位を付けて直し続ける運用。AIを防御側にも組み込み、AIエージェントを統制する攻撃側と同じ速度で動き、誰が見つけた脆弱性でも、攻撃者より先に塞ぐ

なお、3層モデルは続編[37]で定義したもので、基本対策の重要性は第1回[33]、第3層のVulnOpsとCTEMの具体的な実装は続編-2[34]で詳しく論じている。この3層は「順番に完成させる」のではなく「同時に育てる」。第1層のログ基盤が第2層の継続的検証を支え、第2層の守るべき資産の定義が第3層の優先順位を決め、第3層で見つかった脆弱性が第1層のパッチ適用と第2層のポリシーに反映される。この循環が回っている状態がMythosレディである[37]。

2. PHP2Shellの概要

2.1 何が起きたか

  • 規模:PHP 5.4以降、修正版より前のバージョンが、2件のCVEの少なくとも一方の影響を受ける。影響を受けるCVEはバージョンによって異なる。PHPは世界のWebサイトの約70%で使われ、WordPress、Drupal、MediaWikiなどの土台になっている[1]。
  • 性質:本脆弱性はPHP本体のリクエスト処理に起因するため、アプリケーション側の認証・入力検証だけでは根本的に解消できない。攻撃の成立条件やリスクは、PHPの実行方式(mod_php、PHP-FPMなど)や構成も踏まえて評価する必要がある[1][23]。
  • 影響:認証なしで任意コード実行(RCE)に至る可能性があるほか、他のリクエストのパスワード、トークン、APIキーを含むプロセスメモリを読み出せる可能性がある[1]。
  • 修正:PHP 8.5.12、8.4.27、8.3.36、8.2.35で修正。PHPの開発チームによる更新の対象外だったが、7.4・8.0・8.1には例外的なソースのバックポートが公開された[23]。

「PHP本体に起因する」ことの何が問題か

通常の脆弱性はアプリ(WordPressやEC-CUBE、自社開発のシステムなど)のコードの中にあり、アプリ側の対策で守ることができる。PHP2Shellは、PHP本体がリクエストを受け取って処理する段階に原因がある。このため、次の問題が生じる。

  1. アプリ側の対策だけでは防げない:入力チェック、ログイン認証、フレームワークのセキュリティ機能は、アプリのコードが動いて初めて効く。PHP2Shellは、構成によってはアプリのコードが動く前に成立し、PHPの開発チームは、セキュリティアドバイザリで、Apacheのmod_phpでそれを実証したと説明している[23]。アプリをどれだけ堅牢に作っても、それだけでは根本的な解決にならない[1]。
  2. アプリを最新にしても防げない:WordPressやEC-CUBE、プラグインを最新にしても、サーバのPHPが古いままでは防げない[31]。「CMSは最新だから大丈夫」という判断が通用しない。
  3. 直す責任がアプリの担当者の手を離れる:修正はPHP本体の更新でしか行えず、担当はサーバの管理者、レンタルサーバー事業者、委託先になる[31]。アプリの担当者やサイトの所有者が自分で直せない場合が多く、日本で「止める」以外の選択肢を持てなかった組織が多かった一因でもある。
  4. 見つけにくい:PHP本体の処理で起きるため、アプリのログにはほとんど手がかりが残らない可能性がある[1]。異常なリクエストやメモリ上限エラー、PHPのワーカーの異常終了など、サーバやプロセスの単位で見張る必要がある。
  5. 影響範囲が「PHPを使うものすべて」になる:特定のアプリの欠陥ではないため、PHPで動くものはアプリの種類を問わずすべて対象になる。PHPは他のソフトや機器に同梱されていることも多く、自社がPHPを使っていると認識していない場所まで影響が及ぶ[16]。

これを3層との関係でみると次のようになる。資産の把握をアプリやCMSの単位で止めず、その下で動く言語処理系やライブラリの単位まで持つ必要がある(第1層)。アプリの防御を越えられる前提で、サーバ上の権限やデータを最小化して被害を封じ込める(第2層)。検知もアプリのログだけに頼らず、サーバやプロセスの振る舞いで行う(第3層)。

2.2 発見から公開までの経緯

発見者は複数いる。最初に見つけたのはOpenAIの取り組みに参加していたCalif(8月1日)で、OpenAI自身とWizもそれぞれ独立に同じ問題にたどり着いた[2][3]。

日付(2026年)出来事
7月30日Califが監査を開始[2]
8月1日Califの説明による発見日[2]
8月11日Califの研究者が無条件のRCEを報告。同日、OpenAIも同じ根本原因を独自に報告[2][5]
8月14〜15日CalifがRCEのPoCをPHPに共有し、PHPが確認[2]
8月19日Wizが独自に発見(Wiz Atlas、Gemini 4 Argon、GPT-5.6 Solを使用)[1]
8月24日WizがPHPに報告[1]
9月18日OpenAIが追加の攻撃経路を報告[2]
9月21日PHPが報告を受理し、協調した修正の開発に着手[1]
10月17日最初の悪用の試みをAmazonが観測(公開の4日前)[10]
10月20日脆弱性の存在とCVE番号がオンラインでリーク[7][14]
10月21日予定を1日前倒しして修正版を公開(日本時間22時台。予定は23時)[7][26]
10月23日PHPが、21日の修正版では直らない別のセッション処理の欠陥(CVE-2026-115560)を公表[12](詳細は3.3)

OpenAIは、こうした最先端のAIが攻撃者より先に脆弱性を見つけたことで、PHPの開発チームやセキュリティ事業者が、公開前に修正と防御策を準備できる期間(「Defender’s Window」=防御側の窓)が生まれたと説明している[3][32]。Cloudflareは公開の9時間前に防御ルールを展開するなど、業界横断の準備が行われた[14]。

2.3 AIが変えたこと

  • 欠陥は10年以上前からあり、2024年の監査でも見つかっていたが、悪用できることは示されていなかった[2]。
  • Wizは、AIによる分析が脆弱性の理解や、実際に動作する攻撃コードの作成・標的ごとの調整を支援したと説明している。複数の欠陥をつなぎ、標的ごとのメモリ配置に合わせて調整する作業を、AIの支援で数時間のうちに行えたという。Wizによれば、1人の研究者が1週間で、以前なら一流チームが数か月かかる作業を終えた[1]。
  • Wizは、AIによって攻撃コードの作成と標的ごとの調整の手間が下がり、複雑さはもはや防壁にならない可能性があり、「実際に悪用可能」の定義が変わると指摘している[1]。これを踏まえると、これまでの「人間が現実的な手間で攻撃コードを作れるか」という判断に加えて、「欠陥が存在し、外部から届くか」を重く見る必要があると考えられる。「悪用は困難」として後回しにされてきた脆弱性も、狙われる対象になりうる。

2.4 補足:CISAの「自動化可能性」評価

CISAは「Vulnrichment」というプログラムで、公開されたCVE記録に優先順位付けのための情報を追記している。その簡略版SSVCには「悪用状況」「自動化可能性(Automatable)」「技術的影響」の3つの判断項目がある。自動化可能性は、その脆弱性を自動で悪用でき、大量の攻撃が起こりうるかを問う項目である[9]。

PHP2Shellの公開時の記録では、悪用状況は「観測なし」、自動化可能性は「No」で、CVSSでも攻撃の複雑さは「高」とされていた[8]。これはメモリ破壊型の脆弱性として一般には妥当な評価である。ただし、Wizの研究で示されたように、AIが標的ごとの調整を支援できるようになったことは、従来の自動化可能性の評価の前提を見直す理由になる[1]。一方で、本件で攻撃全体の大量自動化が実証されたわけではなく、CISAの評価がAIによって無効になったと断定することはできない。

これらを踏まえて、公的機関の評価や点数は、公開時点の、人間の攻撃者を前提にしたスナップショットにすぎず、AIの時代には、それを鵜呑みにせず、自社の環境で継続的に評価し直す仕組み(CTEM)が必要であると考える。

3. 悪用の状況とAmazonの分析

3.1 Amazonの観測(MadPot)

Amazonは、自社の大規模なハニーポット網MadPotでの観測結果を公表した。毎分2,000億件を超えるイベントを分析し、MadPotからの脅威情報と組み合わせて攻撃を検知・遮断しているとしている[10]。

日時(UTC)日本時間観測内容[10]
10月17日10月17日最初の攻撃の試み。商用の匿名化ネットワークに関連するIPから。攻撃者による活動とみられるが、公開前に情報をどう入手したかは不明
10月21日 02:0021日 11:00最も早いPoCを確認
10月21日 02:00〜08:0021日 11:00〜17:00別の匿名化基盤からの攻撃が続く。ペイロードも手段もばらばらで、複数の攻撃者とみられる。成功したかは不明
10月21日 14:0021日 23:00情報公開の解禁とパッチ公開
解禁後 数時間22日未明追加のPoCが次々に現れ、ほぼ即座にセンサーへの攻撃に使われる

なお、Amazonは、識別した6つのIPアドレスを公表したが、これらは匿名化のための共有基盤であり、遮断ではなく、観測された場合の調査に使うよう求めている[10]。

3.2 Amazonが示した教訓と、見直すべき前提

教訓1:公開日まで情報を伏せておく取り決め(エンバーゴ)が防御側を守るのは、他の誰かが同じバグを見つけるまでに限られる。協調開示は今も正しいやり方だが、公開日を最も早い悪用の日と考えてはいけない。PHP2Shellでは、公開前に侵害されている可能性がある[10]。

教訓2:パッチから攻撃コードまでの時間は、構造的に縮んでいる。かつては少数の能力ある攻撃者が攻撃コードを作り、他はそれを待つ構造だったが、AIによる分析でパッチの差分やアドバイザリーから攻撃コードを作るのが簡単になり、数時間から数分で動ける攻撃者が増えている[10]。

見直すべき前提[10]内容
修正期限は時間単位で測る脅威インテリジェンスを公表したAmazonは、7日・30日の修正期限では、インターネット公開システムの重大脆弱性への対応に十分な猶予を確保できないと指摘した[10]
調査は最も早い悪用の日から公開日ではなく、最も早く悪用が確認された日から調査する。PHP2Shellなら少なくとも10月17日から
シグネチャに頼らない検知最初の悪用は、特定のCVE向けのシグネチャができる前に来ることが多い

これを踏まえ、インターネットに公開された重大脆弱性では、攻撃が修正公開前または公開直後に始まる可能性を考慮し、従来の一律的な日数ベースの期限だけでなく、露出状況・悪用情報・事業影響に基づく時間単位の対応基準を設ける。

3.3 公開後の状況

  • Cloudflareは、公開から45分で数万件、2時間で数十万件、10月22日早朝には数百万件の攻撃の試みを観測した。23日時点で3,440万以上のPHPサービスがなお脆弱とみられる[11]。
  • 攻撃者が管理するサーバ上で、PHP 8.4.26とApacheのmod_phpを狙った攻撃ツールと、標的のPHPのバージョン、サーバ構成、セッション設定、エラー表示の有無などが攻撃の前提条件を満たすかを調べるスクリプトが確認された。このツールは、メモリの漏えいを使ってASLR(メモリ上の配置をランダムにして攻撃を難しくするOSの防御機能)を回避する仕組みだった。報道によれば、調べられたサイトでは10月22日時点でシェルアクセスの証拠はなく、前提条件を満たしていなかったとみられる。この時点では、攻撃者のツールが成功するのは特定のバージョンや構成に限られていた可能性が高い[11]。
  • 一方、VulnCheckの研究者は、PHPが推奨する本番向けの設定(エラーを画面に表示しない設定など)でも、ASLRを回避してRCEを成立させる手法を示した。攻撃者のツールより広い条件で攻撃が成立しうることを意味し、攻撃者が同様の手法を取り入れれば、成功する範囲が広がるおそれがある。ただし、確実なRCEは当初の想定より難しいとの見方もあり、状況は流動的である[11]。
  • 10月23日時点で、CISAのKEVには2件とも未登録[12]。
  • 10月23日、PHPは別のセッション処理の欠陥(CVE-2026-115560)について情報提供の告知を出し、次の定期修正版が出るまでアップロード進捗機能を無効にしておくよう勧めた[12][13]。PHP自身はこのリスクを「起こりにくい」と評価しており、悪用には特殊なアプリの作りが必要で、悪用も報告されていない[35]。アップロード進捗機能は、ファイルのアップロード中に進み具合を表示するためのもので、多くのサイトでは使われておらず、無効にしても通常の動作に影響はない。ただしPHPの標準設定では有効になっており、サイトが使っていなくても外部からのリクエストで動かせてしまうため、設定を確認して無効にしておくとよい[1][13][15]。

4. 海外の対応

  • 英国:NCSCの警告を受け、自治体やロンドン警視庁のサイトが停止。NCSCは、すぐにパッチや緩和策を入れられない場合はオフラインも検討するよう呼びかけた[17]。
  • オランダ:行政ポータル[19][20]、市民が自分の個人データを確認するポータル、下院、NCSC自身、データ保護当局のサイトなどが停止[18]。認証基盤DigiDも止まり[20]、ロッテルダム港、サッカー協会、多数の病院も停止した[19]。
  • その他の欧州:フィンランドでは国のIT機関が政府の公開ウェブサービスを停止、フランスは内務省が自治体の行政サイトを停止、ドイツでも連邦のIT機関がサイトを停止[17]。デンマークでは全国の学校連絡プラットフォームにも影響[21]。スイスのホスティング事業者が顧客ポータルやWebメールを含めて停止し、Wikipediaも一時停止した[19]。
  • 欧州以外:カナダの担当相が一部サイトの一時停止を公表し、オーストラリアではサイバーセキュリティセンター自身も影響を受けた[20]。
  • 当局の方針:EUのCERT-EUは、すぐに更新できない場合は一時的にサイトを止めるよう助言[19]。米国のNSAと欧州のサイバーセキュリティ機関は即時対応を求め[6]、CISAもすぐにパッチを当てるよう呼びかけた[16]。
  • 停止の意味:止めた組織は侵入の兆候はないと説明しており、停止の一覧は被害の数ではなく、各組織の慎重さを表している[18]。
  • 資産把握の差:PHPの所在を把握している組織は必要な部分だけを止め、把握していない組織は全部を止めた結果、ウィーンではWebメールまで止まった、という指摘がある[18]。
  • 保険:英国の保険業界は、多数の契約者が同時に影響を受ける「集積リスク」として注視し、侵害がないまま自ら止めた場合に事業中断の補償が出るかも論点になっている[17]。

5. 日本の対応

5.1 時系列(日本時間)

日時出来事
21日 日中IPAが同日23時の修正版公開を予告し、PHPの利用状況を確認して速やかに適用できるよう準備を要請。攻撃は確認しておらず予防的な発信と説明[25]
21日 14時〜19時コドモンが14時ごろに全サービスを停止。BASEが15時50分、エックスサーバーが16時に公式サイトや管理画面を停止。19時にニコニコ、pixiv、ConoHa WINGなどが続く[26]
21日 21時44分/55分国家サイバー統括室(NCO)、続いて高市首相がXで対応を呼びかけ。首相は「今夜に対応して頂きたい大至急のお願い」とし、すぐ適用できない場合はサイトの一時停止も有効策の一つとした[26]
21日 22時台PHPの修正版が公開(予定は23時)[26]
21日深夜〜22日朝pixivが23時30分、コドモンが3時22分、BASEが8時に再開[26]
22日 日中国税庁が10時20分ごろに停止し16時10分ごろに再開[26]。気象庁なども一時停止[27]。官房長官は、政府系機関や基幹インフラの被害は現段階で報告されていないと述べた[26]
22日 13時11分JPCERT/CCが注意喚起。パッチ適用に加えて侵害の有無の調査を要請し、痕跡がなくても攻撃を受けていないとは断定できないとした[26]
23日 14時アシュアードの集計で停止告知は累計502件、再開告知を確認できたのは217件[30]

5.2 停止の規模と分野

  • 件数:X上の停止告知は502件、うち285件(約6割)は再開告知が未確認。ただし再開してもXで告知していない組織や、Xで停止を告知していない組織は反映されておらず、全体を網羅した数字ではない[30]。
  • 省庁:国税庁と気象庁のほか[27]、財務省と厚労省も一部サービスを停止[28]。
  • 自治体:札幌市が公式ホームページを止めて簡易サイトに切り替え、大阪府も検索機能を制限[28]。三重県では26サイトの公開や一部機能を停止し、8市6町にも影響[29]。
  • 金融:三菱UFJ銀行がネットバンキングの一部取引を停止し、地銀も一部アプリを停止、みずほ銀行も臨時メンテナンスを実施。一方、全国銀行協会は金融機関をつなぐオンラインシステムには影響がないと説明しており、止めたのは決済ではなく周辺サービスが中心だった[31]。
  • 交通・インフラ:JALはWebサイトの一部を予防的に閉じ、予約や運航への影響はないとした。九州電力はホームページを停止し、再開予定を延期した[31]。
  • サービス終了:古い仕組みで十分な対策が取れないとして、ゲーム2本がサービスを終了した[31]。

5.3 被害の状況

22日昼、バルテックが顧客情報流出の可能性を公表し、当初は原因を「PHPの脆弱性を標的とした攻撃」としていた[26]。しかしその後、これは誤報だったと訂正し、原因は自社サービスの脆弱性だと説明している。2026年10月23日時点で、確認した公開情報の範囲では、PHP2Shellを原因とする被害を公表した国内組織は確認できなかった[31]。

5.4 ホスティング事業者の対応の差

対応の型例[26]
利用者のサイトを止めずに更新さくらインターネット(21日23時からのメンテナンスで数秒程度の接続断のみ)、mixhost、カラフルボックス、Value-domain系、エックスサーバー(PHP 8.2〜8.5)
一時停止して更新し、再開ロリポップ!、ヘテムル、ムームー(22日午後までに再開)
利用者に判断を委ねるKAGOYA(事業者側では利用者のサーバーを止めず、修正版の適用を調整する間、利用者にサイトの公開停止やアクセス制限の検討を求めた。22日夕方時点)

PHPの開発チームは、Linuxディストリビューションなどに事前に修正を渡していたとされ、この準備を日頃の運用に組み込めていたかで、止める範囲が変わったと指摘されている[26]。

古いバージョンの扱いも分かれ、さくらインターネット、mixhost、カラフルボックス、ヘテムルなどは、サポートが終わったバージョンにも独自に修正を入れた。こうした修正ではバージョン番号が変わらない場合があり、番号だけでは修正済みか判断できない[26]。

6. 日本と海外の比較

この比較は、10月23日までに公開された報道や各組織の告知に基づくものであり、各国・各組織の対応能力を網羅的に測定したものではない。報道の多い事例に偏っている可能性がある点に留意されたい。

観点日本欧州米国
トップの発信首相とNCOがXで深夜に直接呼びかけ。サイト停止も有効策と明言[26]英NCSC、CERT-EUが「更新できなければオフラインも」と助言[17][19]CISA、NSAが即時対応を要請[6][16]
政府機関の停止国税庁、気象庁、財務省、厚労省、自治体[27][28]オランダの行政ポータル、フィンランドの政府サービス全停止、英仏独の行政サイト[17][18]確認した範囲では、連邦政府サイトの大規模な停止の報道は見当たらなかった
民間の停止502件超の告知。銀行、交通、EC、ゲームなど[30][31]病院、港湾、報道機関、ホスティング事業者、Wikipedia[19]確認できず
悪用の観測10月23日時点で、公的機関による国内の攻撃観測データの公表は、確認した範囲では見当たらなかった。民間では、独自の観測網での観測を公表した企業があるオランダのNCSCは、公開前の時点では悪用を確認していないと説明した[18]Amazonが公開4日前から、Cloudflareが公開直後から攻撃の試みを観測した[10][11]
侵害調査の呼びかけJPCERT/CCが調査観点を提示[26]確認できずAmazonが「10月17日から遡って」と起点を明示[10]
確認された被害PHP2Shellを原因とする被害の公表は確認できず(23日時点)[31]停止組織は侵入の兆候なしと説明[18]KEV未登録(23日時点)[12]
復旧約6割はX上で再開告知が未確認(実際の停止継続件数とは一致しない可能性あり)。サービス終了も[30][31]確認できず大規模な停止の報道が見当たらないため、比較の対象なし

比較から見えること

  • 共通点:止めた範囲には、資産の把握度が大きく影響したと考えられる。欧州でも、PHPの所在を把握していない組織は全部を止めたと指摘されている[18]。日本でも、復旧が長引く要因として、自社や委託先で使っているPHPのバージョンの特定作業とEOL対応が挙げられている[30]。
  • 日本の特徴1:「止める」は速く、「戻す」に時間がかかった。首相とNCOの呼びかけもあり予防停止は素早く広がったが、23日時点でX上の再開告知が確認できないものが約6割あった。実際に停止が続いている件数とは一致しない可能性があるものの、夜のうちに更新を終えた組織と、止めたまま長引く組織の差が大きい[26][30]。
  • 日本の特徴2:委託先・ホスティング事業者への依存。レンタルサーバーやCMS提供元の対応で、利用企業ができることが大きく変わった。自社で直せない組織は「止める」以外の選択肢を持てなかった。
  • 日本の特徴3:国内の攻撃観測データの公表が少ない。海外では事業者が自社の観測データで「いつから、どれだけ」を示したが、確認した範囲では、日本の公的発信は「対応してください」が中心で、脅威の強さの判断を海外のデータに頼っている。

7. 3層に照らした評価

PHP2Shellは、3層のすべてを同時に試した事案だった。各層で何が試され、日本でどうだったか、今後どう変えるかを整理する。

層PHP2Shellで試されたこと日本の状況(観察)今後の変え方
第1層
基本対策
PHPがどこで、どの版で動いているかを即答できるか。PHPは他のソフトや機器に同梱され、気づかない露出が生まれやすい[16]。CybelAngelの調査では、約224万のインターネット公開PHPホストのうち、バージョンを確認できた約150万台の59%が、修正版の公開前の時点で修正提供の見込めないバージョンを使用していた[15]。今回は、PHPの開発チームによるサポート終了版(7.4〜8.1)への例外的なバックポートや、OSの配布元・ホスティング事業者による独自の修正が提供されたが[23][26]、こうした例外的な対応が次も得られるとは限らない止めた後の再開に時間がかかり、X上で再開告知が確認できないものが約6割あった(実際の停止継続件数とは一致しない可能性あり)[30]。古い環境のサービスは終了に至った[31]。委託先・ホスティング事業者に依存資産台帳を言語処理系・ライブラリ単位(SBOM)まで下げる。EOLは「修正が届くかどうかを自分で決められない資産」として扱い、撤去期限を設ける。外部公開の重大脆弱性は、日数ベースの期限に加え、露出状況・悪用情報・事業影響に基づく時間単位の対応基準を設ける。委託契約に緊急時の対応時間を入れる。ログを遡って調査できる期間保存する
第2層
ゼロトラスト
PHP本体に起因するため、アプリ側の防御だけでは防げない。メモリから資格情報が漏れる可能性がある[1]封じ込めの主な手段が「サイトを止める」になった。GMO Flatt Securityは、侵害時に備えた権限とデータの最小化を推奨[22]侵入される前提で、サーバ上のデータとIAM権限を最小化。シークレットを短命化しサーバに置かない。外向き通信の制限とセグメンテーションで横展開を止める。「止める範囲を小さくできる」設計にする
第3層
VulnOps・CTEM
数時間で判断し動けるか。シグネチャ前に検知できるか。CVSSや「自動化不可」の評価を鵜呑みにしないか[8][10]JPCERT/CCが侵害調査の観点を提示[26]。夜のうちに更新を終えた事業者とそうでない組織で差。国内の攻撃観測データは乏しいCTEMで外部公開面と事業影響を常時評価し、外部ソフトの脆弱性は通知を受けたら数時間で塞ぐか止める。振る舞い検知と自動遮断。仮想パッチを即日配る経路。停止の基準と決裁者を事前合意。自社開発のコードはAIでリリース前に診断

3層の重心を、「パッチを早く当てる」(第1層)だけから、「パッチがない期間を生き延びる」(第2層・第3層)へ広げる。ただし、第2層・第3層は、パッチがない期間のリスクを低減するものであり、脆弱性の根本修正を代替するものではない。修正版が出たら速やかに適用することが前提である。また、止める範囲と戻す速さには第1層の成熟度が大きく影響したと考えられ、3層は同時に育てる必要がある。

8. 攻撃側のAIが先に見つける時代への備え

今回は防御側が約2か月半先行できた。しかし、異なる組織が、それぞれAIを使って同じ欠陥にほぼ同時期にたどり着いた事実は、攻撃側も同じものに到達しうることを示している。さらに、リークと公開前の悪用の試みで、その先行期間は想定より早く閉じた[10]。次は、攻撃側のAIが先に見つけ、パッチが存在しない期間に攻撃される前提で備える必要がある。

  1. 露出を減らす:インターネットに出ている面を棚卸しし、不要な公開、EOL、管理外のサーバを消す。攻撃側のAIは面が広いほど有利になる。
  2. ゼロデイ前提の封じ込め:最小権限、シークレットをサーバに置かない設計、外向き通信の制限。パッチがなくても「乗っ取られても被害はここまで」と言える状態にする。
  3. 振る舞いで検知し、自動で止める:シグネチャのない攻撃に備え、サーバのプロセスの異常終了や再起動の多発、メモリ上限エラーやHTTP 500の多発、予期しないシェルの起動など、ふだんと異なる振る舞いを検知して遮断する。PHP2Shellでも、PHPのワーカー(リクエストを処理するプロセス)の異常終了が兆候として挙げられた[1][10][26]。
  4. 仮想パッチを即日展開できる経路:WAFやCDNのルールを数時間で全体に配れるようにする。ただしWAFやIPSは本体の修正の代わりにはならない[23]。
  5. 「止める判断」を事前に決める:停止の基準、決裁者、顧客への連絡手順、サイバー保険の条件を経営として事前に合意しておく[17]。
  6. 自社のコードはAIで先に探す:自社で開発したシステムは、ソースコードを持つ防御側が有利であり、AIによる診断を開発の流れに組み込めば、リリース前に脆弱性を見つけられる可能性が高まる。一方、PHPのような外部のソフトウェアの脆弱性を自社で先に見つけることは現実的ではない。外部のソフトウェアについては、発見を待つのではなく、通知を受けたら影響範囲を即座に特定し、数時間で塞ぐか止められる状態にしておく。これが第3層の役割である。

振る舞いの検知と自動遮断を支える仕組み

上記3つ目の「振る舞いで検知し、自動で止める」は、次のような仕組みを組み合わせて実現する。

種類役割PHP2Shellとの関係
サーバ用のEDR・ランタイム保護サーバ上のプロセスの動きを常時監視し、不審な動きを検知して、プロセスの停止やサーバの隔離を自動で行う「Webサーバのプロセスからシェルが起動された」などの動きを直接捉えられる。中心となる仕組み
ログとメトリクスの監視エラーログ、アクセスログ、メモリ上限エラーなどを集め、ふだんより急に増えたら警告するワーカーの異常終了やHTTP 500の急増に気づける。自動で止めるには、次の自動対応と組み合わせる
自動対応の仕組み警告を受けて、該当サーバを切り離す、送信元を遮断するなどの対応を自動で実行する気づいてから止めるまでの時間を縮める
OSの強制アクセス制御Webサーバのプロセスがシェルを起動できないよう、あらかじめ制限する検知ではなく予防。乗っ取られても攻撃者ができることを減らす
WAF不審なリクエストの急増を検知して遮断する未知の攻撃はシグネチャがないと見逃す場合があり、本体の修正の代わりにはならない[23]

PHP2Shellは構成によってはアプリのコードが動く前に成立するため、アプリの中に組み込む防御では捉えられない場合がある。サーバやOSの単位で見張る仕組みの方が向いている。

導入にあたっては2点に注意する。第一に、レンタルサーバーやISPにサーバの管理を任せている場合、これらの多くは利用者側では導入できない。事業者がこうした監視や自動遮断を行っているかを確認するのが現実的である。第二に、自動で止める仕組みは、誤検知で正常なサービスを止めてしまうおそれがある。最初は「検知して通知」から始め、誤検知の傾向を見てから自動遮断に進めるのが一般的である。

9. 対策を経営判断にする: PHP2Shellを使った経営層への説明

7.と8.で挙げた対策の多くは、現場の判断だけでは進められない。時間単位の対応基準を設けること、サービスを止める基準と決裁者を決めること、委託契約に緊急時の対応時間を入れること、そしてVulnOps・CTEMの体制に投資することは、いずれも経営の判断を必要とする。PHP2Shellでは、国内外の多くの組織が深夜に「止めるかどうか」の判断を迫られた。こうした判断を平時に済ませておくには、経営層の理解が欠かせない。

しかし、VulnOpsやCTEMという言葉は、一般にはわかりにくい。そこで本節では、用語から入るのではなく、PHP2Shellという具体的な事案を題材に、経営層に何を問い、何を報告してもらうかという形で説明する方法を示す。

出発点は、PHP2Shellの情報がリークした10月20日から23日までの約72時間で、経営に問われた3つの質問である。

#経営に問われた質問問われた力
1うちでPHPが動いているサーバやサービスは、どこに、いくつあるのか?可視化(資産把握)
2そのうち、止まると売上や顧客に響くのはどれか?事業影響の評価(優先順位付け)
3何時間で直したのか。止める判断は誰がしたのか?修正と意思決定の速さ

CTEMは「この3つの質問に、平時から常に即答できる状態を保つ経営の仕組み」、VulnOpsは「それを毎日回す運用チームと手順」と説明できる。

言い換えの例

  • 健康診断から24時間モニタリングへ:年1回の脆弱性診断は健康診断にあたる。発見から悪用までが数時間になった今は、常時モニタリングと「即入院の判断基準」が要る。
  • 点数ではなく、自社にとっての危険度で並べる:今回は、攻撃の複雑さが「高」、自動化可能性が「No」とされた欠陥でも、AIの支援で攻撃コードが作られ、公開直後から大量の攻撃の試みが観測された[1][8][11]。CVSSの点数順ではなく、「公開されているか」「重要業務か」「実際に悪用可能か」で順位を付ける。
  • Amazonの発言を使う:脅威インテリジェンスを公表したAmazonは、7日・30日の修正期限では、インターネット公開システムの重大脆弱性への対応に十分な猶予を確保できないと指摘した[10]。自社の規程の修正期限と並べて示し、外部公開の重大脆弱性について、露出状況・悪用情報・事業影響に基づく時間単位の基準が必要なことを伝える。
  • お金の言葉に置き換える:「数時間の計画停止のコスト」と「侵害されたときの情報漏えい・長期停止のコスト」を比べる。今回、予防的に止めた組織は前者を選んだ。

経営に報告してもらう指標(月次)

指標意味
外部公開資産のうち台帳にあるものの割合「どこに何があるか」を把握できているか(質問1)
重大脆弱性を修正・緩和するまでの時間外部公開の重大脆弱性について、時間単位の対応基準を守れているか(質問3)
EOLソフトの残存数と撤去期限修正が届くかどうかを他者の例外的な対応に頼っている資産がどれだけあるか
停止判断にかかった時間止める決断を自社で速く下せるか(質問3)
停止から再開までの時間戻す力。第1層の成熟度を反映しやすい指標

10. まとめ

PHP2Shellは、防御側のAIを活用した脆弱性発見と協調開示によって、修正準備の時間を確保できた事例である。ただし、攻撃側より防御側が常に先行できることを示すものではない。実際、リークと公開前の悪用の試みで、確保した時間は想定より早く失われ、国内外で大規模な予防停止が起きた。日本では、止める判断は速かったものの、戻すまでに時間がかかる組織が多く、資産把握とEOL管理という第1層の課題が表れたと考えられる。

次は攻撃側のAIが先に見つける前提で、第1層の土台を固めつつ、第2層の封じ込めと第3層のVulnOps・CTEMを同時に育てる必要がある。経営層には、「3つの質問に即答できる会社にしておく」ことを目標として示すのが有効である。

注:本書は2026年10月23日までの公開情報に基づいている。悪用状況や被害の報告は今後変わりうるため、判断の際は各機関・事業者の最新の発表を確認されたい。

参考資料

以上

「AI脆弱性の嵐」から半年 ~ 4月の予測はどこまで現実になったか

2026年10月17日
AIWGメンバー 諸角昌宏

はじめに

2026年4月19日の本ブログで、CSA、SANS、[un]prompted、OWASP GenAI Security Projectなどが共同でまとめた緊急戦略ブリーフィング「AI脆弱性の嵐(AI Vulnerability Storm):『Mythosレディ』なセキュリティプログラムの構築」の日本語版を紹介した[1][2]。Claude Mythos Previewの発表を受けて、AIによる脆弱性の発見と悪用が加速する世界に、組織がどう備えるべきかを示した文書である。

この文書の特徴は、強い危機感と具体的な時間軸にあった。今週着手すること、45日以内、90日以内、12か月以内という区切りで優先アクションを示し、取締役会には「90日計画」を求めた。言い換えれば、「四半期の単位で動かなければ間に合わない」という見立てである。 それから約半年がたった。日本では9月下旬から、不正アクセスによる情報漏えいの公表が連日のように続き、10月にはJPCERT/CCが一連の事案の攻撃者によるAIの利用を確認したと公表した。本ブログでは、4月の文書が何を予測し、何を求めていたかを原文に沿って振り返り、この半年で何が現実になり、何が予測と違ったのかを整理してみたい。

1. 4月の文書は何を予測していたか

原文は、次のような見通しを示していた[2]。

論点原文の記述(要旨)
能力の拡散同等の攻撃能力は、他のフロンティアモデルには数か月以内に、オープンウェイトモデルには6か月から1年以内に現れる
悪用までの時間脆弱性の公開から悪用までの時間は分単位に短縮されている。いわゆる「ゼロデイ・クロック」は2026年に1日を切った
脆弱性の量脆弱性の公表の頻度と量は、これまでに経験したことのない水準になる
攻撃の担い手平均的な犯罪者が、かつては国家レベルの資源が必要だった能力を持つようになる
インシデント同じ週に複数の重大インシデントが同時に起きる事態を想定した机上演習を行うべき
影響ただし、悪用までの時間の短縮は、まだ悪用の影響の比例的な増大にはつながっていない

最後の一文にも注目しておきたい。4月の時点では、「速度の変化はすでに起きているが、被害の規模にはまだ表れていない」という認識だった。この点が半年後にどう変わったかは、後述するとおり、事故の増加とAIとの関係が明確になっていない現時点では判断できない。

そのうえで文書は、11の優先アクションに着手時期と完了の目安を付けている。

優先アクション着手目安
1. コードとパイプラインにAIエージェントを向ける今週継続
2. AIエージェントの導入を必須にする今週継続
3. 自組織のエージェントを守る今月45日
4. イノベーションと加速のガバナンスを整える今週6か月
5. 継続的なパッチ適用に備える今週45日
6. リスクモデルと報告を更新する今週45日
7. アタックサーフェスを棚卸しし、縮小する今月90日
8. 環境を堅牢化する今月6か月
9. ディセプション(おとり)の能力を作る90日以内6か月
10. 自動対応の能力を作る90日以内12か月
11. VulnOpsを立ち上げる6か月以内12か月

4月から数えれば、45日の目安は5月末、90日の目安は7月中旬にあたる。9月下旬の時点で、アクション3、5、6、7はすでに目安を過ぎ、1と2は着手から5か月がたっている。さらに、6か月が目安のアクション4、8、9も、一連の事案のさなかの10月中旬に期限を迎えている。

2. この半年で現実になったこと

2.1 能力の拡散は、予測どおりか、それより早く進んだ

英国AI安全研究所(AISI)は4月30日、GPT-5.5の初期版の評価結果を公表した。専門家レベルのサイバータスクの平均合格率は、GPT-5.5が71.4%、Mythos Previewが68.6%で、ほぼ同水準だった[3]。IPAの「AIセキュリティ短信」2026年9月号は、AIのサイバー攻撃能力が初めてOpenAIの基準で「Critical」水準に達したことを取り上げている[4]。「他のフロンティアモデルには数か月以内」という予測は、ほぼそのとおりに進んだ。

より注目すべきは、攻撃の現場で使われているAIである。Gambit Securityが9月に公表した暫定報告では、攻撃者は3種類のオープンソースのAIエージェントツールを組み合わせ、脆弱性の探索から侵入、データの持ち出しまでの大部分を自律的に実行させていた。1標的あたりのコストは平均で約25ドルにすぎない[5]。AIエージェントを利用することで、一部の攻撃者が比較的低コストで大規模な攻撃を実行できることが示された。これは高度な攻撃能力の利用コストが低下していることを意味するが、平均的な犯罪者が同等の能力を獲得したとまでは断定できない。

2.2 自律的な攻撃が観測され始めた

Google Threat Intelligence Groupは9月、攻撃者のAI利用が「プロンプトで指示する段階から自律へ」移りつつあるとする報告を公表した[6]。IPAの9月号も、AIエージェント群による政府機関への自律的な侵入や、AIエージェントによって企業への侵入が10時間に短縮された事例を紹介している[4]。

そして国内でも、JPCERT/CCが10月15日、一連の不正アクセス事案で攻撃に使用された可能性のあるインフラを調査した結果、「攻撃者がAIを利用して、既知の脆弱性のスキャンやAPI経由での攻撃などを実施していたことを確認しました」と公表した[7]。同日の報道では、AIエージェントの使用や、標的の選定からデータの窃取までが自動化されていた可能性に言及している。ただし公表文書は「AIを利用して」という表現にとどまり、個別の事案との対応や、どこまで自律的だったかは示していない。

2.3 「同時多発」は、日本で起きた

4月の文書が机上演習の題材として挙げた「同じ週に複数の重大インシデント」は、9月下旬以降の日本で、ほぼそのままの形で現れた。Aioright Technologiesの集計では、7月1日から10月4日までに検知または公表された確認済みのサイバー攻撃126件のうち、公表月で見ると8月に47件、9月に57件が集中している[8]。なお、件数は公表単位で数えたもので、全数調査ではなく、公表の時期と発生の時期も一致しない。警察庁によれば、2026年上半期のランサムウェア被害の報告件数も123件で、半期として過去最多となった[9]。

委託先1社への侵害が複数の組織の被害につながる事例も目立った。問い合わせ管理システムの提供会社への不正アクセスでは、証券会社、保険会社、製造業者などが相次いで顧客情報の漏えいの可能性を公表している[10]。4月の文書は「サプライチェーンは影響を受ける」と書いていたが、それが具体的な形で表れた。ただし、こうした事案の増加とAIの利用との因果関係は、現時点では示されていない。

2.4 規制当局は「四半期」より速く動いた

金融庁と日本銀行は5月22日、脆弱性の発見から攻撃に至るまでの期間が大幅に短縮され得るとして、金融機関等に9項目の短期的な対応を、概ね1か月程度を目途に進めるよう要請した[11]。優先システムの特定、技術負債の解消、リスクベースのパッチ適用、停止への備えなど、内容は4月の文書の優先アクションと大きく重なる。要請自身は、これらを「応急的措置」と位置付け、中長期的には脆弱性対応の自動化等への移行が必要としている。さらに金融庁は10月9日、委託先を含むサードパーティのリスク管理の再点検と、ICチップによる本人確認への早期移行を求めた[12]。

3. 予測と違ったこと

一方で、この半年の出来事は、4月の議論がそのまま現実になったわけではないことも示している。

3.1 機械速度は、最先端のAIを待たずに来た

4月の文書の中心にあったのは、機械速度で動く攻撃と、人間の速度で動く防御との非対称性だった。その速度をもたらすものとして想定されていたのは、Mythosのような最先端モデルによる脆弱性の発見と悪用の加速である。しかし、これまでに公表された攻撃で使われていたのは、オープンソースのエージェントツールや一般に利用できるAIだった。機械速度の攻撃は、最先端モデルの能力が広く行き渡るのを待たずに、手頃なAIと既存の手口の組み合わせで現実になった。

3.2 突かれたのは、多くが以前からある弱点だった

JPCERT/CCが確認したAIの用途は、既知の脆弱性のスキャンと、スマートフォンアプリを解析してその裏側にあるAPIの弱点を探す行為だった[7]。推奨している対策も、アプリに秘密鍵を埋め込まない、サーバー側で認証・認可を行う、レート制限と監視を行うといった基本的なものである。Gambit Securityの事例でも、使われたのはSQLインジェクションやファイルアップロード機能の不備、設定ファイルに残された認証情報だった[5]。注意喚起の対象には公開前に悪用された脆弱性に関わるものも含まれるが[13]、全体として見れば、AIが未知の脆弱性を見つけて侵入したというより、既知の弱点を探して突く作業が速く、安く、大規模になったと見る方が実態に近い。

3.3 入口は、自社の中心ではなく周辺にあった

金融分野では、9月下旬以降に公表された主な事案の入口が、自社の中心的なシステムではなく、委託先や周辺のシステムだった[10][14][15]。

事案(公表時期)入口(公表時点)5月の要請との関係
大和証券、損保ジャパン、オリックス生命(10月5〜8日)問い合わせ管理を委託していたFAQシステムの管理サイトへの不正ログイン(アカウントの入手経路は未公表)要請は優先システムを絞り込む構成で、周辺業務の委託先は対象に入りにくい
IDARE(キャッシュレスアプリ、10月中旬)顧客対応などに使う外部ソフトウェアの脆弱性(ソフトウェア名は非公表)要請には、外部のソフトウェアやサービスに預けた顧客データの扱いについての記述がない
内藤証券、大和総研(10月15日)運用を委託しているネット取引システムのWebサーバー(侵入経路は調査中)要請が最優先とした外部公開システム。ただし委託先に関する項目は、パッチ適用作業の契約と役割分担の確認にとどまる

5月22日の短期的要請では、脆弱性への迅速な対応や重要な外部公開システムの保護が重点的に取り上げられた[11]。一方、今回の事案は、委託先や周辺システムに預けた顧客データまで含めて、組織全体のアタックサーフェスとリスクを把握する必要性を改めて示した。なお、金融庁は別途、「金融分野におけるサイバーセキュリティに関するガイドライン」でサードパーティリスク管理を求めており[17]、5月の要請だけをもって委託先対策が欠落していたと評価することは適切ではない。10月9日の注意喚起でも、このガイドラインなどを踏まえ、委託先を含むサードパーティのリスク管理の再点検をあらためて求めている[12]。

一方で、筆者が確認した範囲では、それ以外の部分、つまり銀行の基幹系やインターネットバンキングなど、要請が最優先とした金融機関自身の中核システムが直接破られたという公表は見当たらない。公表がないことは被害がないことを意味しているわけではないし、これを要請の効果と断定する材料もないが、守りを固めるよう求められた中心部ではなく、その外側から入られたという構図ははっきりしている。4月の文書のアクション7(アタックサーフェスの棚卸しと縮小)は、自社のシステムだけでなく、委託先や外部に預けたデータまでを範囲に含めなければならない。

4. 「四半期の行動」は間に合ったのか

では、4月の文書が求めた行動は、この半年に間に合ったのだろうか。各組織がどこまで実行したかを示す資料はなく、実行した組織の被害が少なかったかどうかも検証できない。ただ、9月以降に突かれた弱点と、優先アクションを並べてみると、どの行動が問われたのかは見えてくる。

9月以降の事案で問われたこと対応する優先アクション4月時点の目安
既知の脆弱性の放置5. 継続的なパッチ適用に備える45日
公開されたAPI、アプリ、委託先のシステムの把握漏れ7. アタックサーフェスの棚卸しと縮小90日
認証情報の悪用、横展開8. 環境の堅牢化(フィッシング耐性MFA、セグメンテーション)6か月
影響範囲と復旧速度の評価6. リスクモデルと報告の更新45日
大量・短時間のアクセスの検知と遮断10. 自動対応の能力12か月

問われたのは、新しいAI防御の仕組みではなく、45日から90日で終えるはずだった基本だった。4月の文書が「基本への集中を強めよ」をKey Takeawaysの一つに掲げていたことを、改めて思い起こしたい。

まだ基本ができていない組織へ

この半年で最も大きく変わったのは、攻撃の費用である。1標的あたり約25ドルで自動化された攻撃を仕掛けられるのであれば[5]、「うちは狙われるほどの価値がない」という前提は成り立たなくなりつつある。警察庁の統計でも、2026年上半期のランサムウェア被害123件のうち79件は中小企業だった[9]。規模や業種にかかわらず、基本の穴がある組織は、手頃なAIによる網羅的な探索の対象になると考えるべきである。

4月の文書が45日から90日で求めた基本が、まだできていない組織は少なくないはずだ。そうした組織に必要なのは、次の四半期の計画を立てることよりも、今すぐ着手することであると考える。少なくとも次の点は、新しい製品を導入しなくても速やかに取り組める内容である。

  • 外部から見えるものを棚卸しする:Webサイト、管理画面、API、スマートフォンアプリ、VPN機器に加え、委託先のシステムに預けている顧客データも対象に含める
  • 既知の脆弱性を塞ぐ:特に、すでに悪用が確認されている脆弱性(KEV)を優先して修正する[16]
  • 認証を固める:管理画面と特権IDに多要素認証を導入し、使われていないアカウントやテスト環境を削除する
  • APIとアプリを見直す:アプリに秘密鍵や長期間有効な認証情報を埋め込まない。サーバー側で認証・認可を行い、レート制限と異常なアクセスの監視を設ける[7]
  • 持たなくてよいデータを捨てる:退会者の情報や、目的を終えた本人確認書類の画像など、保有し続ける理由のないデータを削除する

この5項目は、全体として、JPCERT/CCが一連の事案を受けて推奨した対策や、4月の文書の優先アクション5、7、8と重なる。攻撃が機械速度で網羅的に行われる以上、守りの穴は「いつか見つかる」のではなく「すぐに見つかる」と考えて動く必要がある。

5. まとめ:短期の対応が必要だという見立ては裏付けられた

4月の文書が示した短期間での対応の必要性は、この半年に観測されたAI利用攻撃の進展によって、改めて裏付けられた。一方、日本で相次いだインシデントがすべてAIの普及によって引き起こされたと結論づけることも難しい。今回明らかになったのは、攻撃の自動化が進む環境において、従来から存在する脆弱性や認証・認可の不備への対応を先送りできなくなっていることである。問われたのは、先送りしてきた基本であった。

次の半年に向けて考えておくべきことが二つある。第一に、オープンウェイトモデルが同等の能力に達するという「6か月から1年」の時期に、いま入りつつある。攻撃の民主化はさらに進む前提で備える必要がある。第二に、4月の文書が6か月から12か月の目安としていたアクション、つまり環境の堅牢化、ディセプション、自動対応、そしてVulnOpsの立ち上げが、これから本番を迎える。

Mythosレディとは、一度到達すれば終わる状態ではない。次の四半期に何をするかを、四半期ごとに見直し続けることである。半年前の文書は、そのことを予告していたといえる。

参考資料

以上

第7回 CSAジャパン関西支部開発者向け海外最新動向紹介

暗号化コンテキストインジェクションによるAIガードレールの回避

[要約] CSAのレポートは、強固な暗号を用いてAIの静的ガードレールを回避する新攻撃手法「暗号化コンテキストインジェクション」を解説している。攻撃者はAES-256-GCM等で暗号化した指示文を入力する。静的分類器は暗号文を検知できず通過させるが、AIは信頼されたコード実行環境(Python等)でこれを復号する。復号後の平文を「AI自身の出力」と誤認・信頼(信頼のロンダリング)することで、検閲を経ずにユーザーの会話履歴や個人情報を外部へ不正送信させる。GrokでのPoCによりデータ流出が実証されており、本手法はモデル固有のバグではなく「コード実行前にしか検査を行わない」AIエージェント構造の共通課題である。対策として、復号実行後の再検閲、外部通信の制限、権限分離アーキテクチャの導入といった動的なセキュリティ統制が提唱されている。

・[要点1] 強固な暗号化でAI検閲を回避する攻撃手法
・[要点2] 復号後の指示をAIが誤信頼しデータを流出
・[要点3] 実行後の再検閲や通信制限など動的対策が不可欠

2026年8月20日、イスラエルのセキュリティ・スタートアップ企業Adversa AI の研究者Rony Utevsky氏は、「ゼロクリックGrokデータ窃取:暗号的コンテキスト注入攻撃による会話履歴の流出」と題する記事を公開した(関連情報(https://adversa.ai/blog/cryptographic-context-injection-grok-data-theft/))。Adversa AI は、クラウドセキュリティアライアンス(CSA)イスラエルチャプターのメンバーであり、「CSA Startup Innovation Pitchapalooza 2025」を受賞したスタートアップ企業である(関連情報(https://www.prnewswire.com/news-releases/adversa-ai-wins-cloud-security-alliances-pitchapalooza-2025-award-recognized-as-the-leading-platform-for-continuous-ai-red-teaming-and-agentic-ai-security-302628127.html))。

Utevsky 氏は、xAIのAIアシスタント「Grok」(Grok 4.5 Fast等)において、ユーザーの操作(クリック等)を必要としないゼロクリックで会話履歴や個人情報を流出させられる深刻な脆弱性を発見した。本攻撃は、Adversa AIが新たに提唱する「暗号化コンテキストインジェクション(Cryptographic Context Injection)」と呼ばれる高度なAIガードレール回避手法に基づいている。

従来のプロンプトインジェクション攻撃は、単語の言い換えやBase64などの単純な難読化を用いるため、入力段階で動作する事前検証型ガードレール(コンテンツ分類器)に見破られやすいという弱点があった。本手法は、このセキュリティモデルの盲点を突いて攻撃を成功させるものである。

このAdversa AI による研究報告を受けて2026年8月23日、クラウドセキュリティアライアンス(CSA)は、「暗号化コンテキストインジェクション:暗号化がAIガードレールを打破する時」と題するレポートを公開した(関連情報:Cryptographic Context Injection: When Encryption Defeats AI Guardrails(https://cloudsecurityalliance.org/artifacts/cryptographic-context-injection-when-encryption-defeats-ai-g))。

CSAのレポート「暗号化コンテキストインジェクション:暗号化がAIガードレールを打破する時」は、以下のような構成になっている。

・主要なキーメッセージ
・背景
・セキュリティ分析
・推奨事項・対策
・CSAリソースとの整合性
・参考文献

【主要なキーメッセージ】

・攻撃手法の定義:
「暗号化コンテキストインジェクション(Cryptographic Context Injection)」とは、悪意のある指示文を強力な暗号(PBKDF2で生成された鍵を用いたAES-256-GCM等)で暗号化してAIに入力する新たな攻撃手法である。事前検証を行う静的コンテンツ分類器(ガードレール)は暗号文を解読できないため攻撃をスルーするが、AIシステムが自らの信頼されたコード実行環境(Python等)内部でこれを復号し、得られた平文を外部からの不審な入力ではなく「AI自身が生成した出力(信頼できる内部情報)」として処理してしまう点に特徴がある。

・Grokにおける概念実証(PoC):
Adversa AIの研究者 Rony Utevsky 氏は、xAI社の「Grok」(Grok 4.5 Fast、grok.com)に対するPoC(概念実証)を実証した。Webブラウジング機能を持つGrokに対し、攻撃者が仕込んだWebページを要約させることにより、ユーザーの氏名、概算の現在地、サブスクリプション階層、進行中の会話内容などを取得させ、特定URLを通じて外部サーバーへ送出させることに成功した。

・報告の経過とベンダーの対応:
Utevsky 氏は2026年6月3日、HackerOneを通じてxAIへこの脆弱性を報告した。しかし、2026年8月20日の公表時点までに、xAI側は受領を承認したものの、パッチの適用、CVE IDの割り当て、緩和策のタイムライン提示などを一切行っていない。
・他モデルへの広がり:この手法はGrok固有のバグではない。2026年3月に Utevsky 氏が公表した研究「Cryptographic Payload Injection」では、Google Geminiのセーフティフィルターを5回中5回回避することに成功している(完全なデータ流出チェーン構築には至らず)。一方で、OpenAIのGPT-5は復号指示の解釈自体に失敗し、AnthropicのClaude Sonnet 4.5は復号には成功したものの、得られた平文をプロンプトインジェクションと認識してブロックした(部分的防衛成功)。

・構造的問題の露呈:
この攻撃は特定のモデルの固有バグというより、「モデルにコード実行権限やツール利用権限を与えつつ、コード実行前にしか入力コンテンツの安全性を検査しない」という、現代のAIエージェントアーキテクチャ全般に共通する構造的な不整合を突いたものである。

【背景】

従来のガードレールとその限界:
LLMのガードレールは従来、プロンプトや取得文書がモデルに届く前にキーワードや知られている攻撃パターン、ジェイルブレイク表現をチェックする静的テキスト検査に依存してきた。攻撃者はBase64やROT13、Leetspeakといった単純なエンコーディング(難読化)でこれを潜り抜けようと試みたが、AIは学習データからこれらをパターン認識して解読できるため、セキュリティ側も「Base64の塊が存在すること自体を不審」と認識する分類器を学習させて対応してきた。

強力な暗号化による不可視化:
暗号化コンテキストインジェクションは、この防衛前提を根本から破壊する。Base64のようなやさしい難読化ではなく、以下のように、真の強力な暗号(AES-256-GCM)を用いる。

1.攻撃者は一般的なWebページ上に、暗号化されたJSONペイロード、鍵情報、そして「PBKDF2で鍵を生成しAES-256-GCMで復号せよ」という短い命令を埋め込む。
2.強力な暗号文は統計的にランダムノイズと区別がつかないため、入力チェックを行うコンテンツ分類器は「読める危険情報がない」として通過させる(モデルの重み/パターン認識だけではAES暗号を解読できない)。
3.復号するには「実際に暗号化アルゴリズム(Pythonコード)を実行する」必要がある。

「信頼のロンダリング」:
GrokなどのAIがWebページを読み込んだ際、モデルはそのページに含まれる指示に従い、自らの信頼された実行環境(Pythonサンドボックス)内で復号スクリプトを走らせる。 復号された悪意ある指示は、「AIモデル自身が自らコードを実行して算出した出力」として出現する。システムはこの指示を「外部の不審なWebサイトから来たデータ」ではなく「信頼できるAI自身の思考・出力結果」として扱うため、セーフティチェックにかかることなく、指示通りにセッション情報(ユーザー名、位置情報、会話履歴など)を収集し、外部URLパラメータに組み込んでデータを不正送信してしまう。

【セキュリティ分析】

・実行前チェックの盲点:
コンテンツ分類器は、検査時点で存在する生のテキストやトークンしか評価できない。強力に暗号化されたペイロードは鍵がない限り解読不能なため、分類器には警告を出す根拠が存在しない。悪意ある内容が可視化されるのは、モデルがその復号処理を信頼して実行した後である。

・信頼のロンダリングとROPとの類似性:
Adversa AIはこの現象を「Trust Laundering(信頼のロンダリング)」と表現している。また、従来のバイナリ攻撃手法であるROP(Return-Oriented Programming)になぞらえ、暗号文、鍵材料、復号指示という単体では無害に見える断片を組み合わせ、AIの実行環境上で初めて危害を発生させる手法であると分析している。

・理論的限界(NIST/Gödel的視点)との一致:
CSAが過去に取り上げたNISTの理論分析(ゲーデルの不完全性定理に触発された研究)では、「無限の敵対的入力空間に対し、静的なガードレールルールの有限集合で完全かつ一貫した安全性を保つことは理論上不可能である」と証明されている。暗号化コンテキストインジェクションは、まさに「実行前のテキストスキャン型ガードレールでは構造上評価不可能な入力カテゴリが存在する」という理論的限界を具現化した例と言える。

・ガードレールのタイミングエラー(他分野での類似例):
CSAが調査したAIコーディングエージェントの脆弱性「GuardFall(シェルインジェクションの回避)」でも、シェルが変数を展開・解釈する前にガードレールが検査を行っていたために回避が発生していた。今回の暗号化インジェクションも同様に、「システム自身が行う変換処理(復号)の前で検査を行ってしまう」というタイミングの誤りが原因である。

【推奨事項・対策】

<即時対応策>
・Webブラウジング機能とコード実行環境を併せ持つAIアシスタントを運用・評価している組織は、ベンダーによる修正が行われるまで高リスクとして扱うべきである。
・特に外部コンテンツを処理した結果として発動するネットワーク通信に対して制限を設け、セッション情報が含まれるURLへの外部リクエストをブロックまたは人間の承認(Human-in-the-loop)を必須とする。

<短期的な緩和策>
・実行後の再検閲:モデルがデータの復号やデコードを行った後に、得られた平文に対して再度コンテンツ分類器を通すステップを追加する。
・異常検知の強化:外部文書の処理直後に、モデルが生成したコードからPBKDF2やAES復号などの暗号化プリミティブが呼び出された場合、それを異常として検出・フラグ立てする。
・権限分離アーキテクチャ:外部コンテンツを処理するサンドボックス化されたモデルと、特権的ツール(ネットワーク通信等)を扱うオーケストレーターを分離する設計を採用する。

<戦略的検討事項>
・静的なガードレールを「導入して終わり」の機能とみなさず、継続的に更新されるセキュリティ統制として扱う。
・レッドチーム演習において、通常の自然言語ジェイルブレイクだけでなく、暗号化・エンコーディングを用いた回避手法のテストを定期的に実施する。
・強力な来歴とデータフロートラッキングを導入し、暗号復号などの変換を経た後であっても「外部の不審なソース由来データ」というタグを維持する仕組みを構築する。

最後に、「CSAのリソースとの整合性」では、本レポートとクラウドセキュリティアライアンス(CSA)が提供する各種フレームワークとの相互補完関係について、以下のように説明している。

・「GuardFall:シェルインジェクションによる回避がAIコーディングエージェントのガードレールを破る」:AIコーディングエージェントにおける「変換実行前検査」の欠陥を実証した研究(関連情報(https://labs.cloudsecurityalliance.org/research/csa-research-note-guardfall-ai-agent-shell-injection-2026070/))。
・「エージェントデータインジェクション:プロンプトインジェクションを超える新たな攻撃クラス」:直接的なプロンプトインジェクション対策を回避し、エージェントが信頼するコンテキストを操作する攻撃の危険性を示したレポート(関連情報(https://cloudsecurityalliance.org/artifacts/agent-data-injection-a-new-attack-class-beyond-prompt-injection))。
・「NISTが静的なAIガードレールの数学的不十分さを証明」:静的ガードレールの数学的限界を証明したNIST研究の分析(関連情報(https://labs.cloudsecurityalliance.org/research/csa-research-note-nist-continuous-ai-monitoring-godel-proof/))。暗号化ペイロードはこの限界の典型例。
・「AI Controls Matrix (AICM) v1.1」:AIエージェントの実行環境の権限境界設定や出力の信頼性管理を定義したガバナンスフレームワーク(関連情報(https://cloudsecurityalliance.org/artifacts/ai-controls-matrix-v1-1))。

CSAジャパン関西支部メンバー
DevSecOps/サーバーレスWGリーダー
笹原英司

CCZT合格体験記

2026年10月13日
キンドリルジャパン株式会社 河合 淳一

2026年3月12日に、Cloud Security Alliance(CSA)が提供するCertificate of Competence in Zero Trust(CCZT)に合格しました。

以前からZero Trustには関心があり、関連する業務や勉強会にも関わってきましたが、体系的に理解できているかというと、かなり不安がありました。

今回、資格取得を目標に学習を進めたことで、Zero Trustの考え方をかなり整理できたように思います。受験の経緯や学習方法、受験後の感想などをご紹介します。

■ CCZTとは

CCZTは、CSAが提供するZero Trustに関するベンダーニュートラルな資格です。特定の製品やサービスの知識ではなく、Zero Trustの基本原則、アーキテクチャ、導入戦略や計画などについての理解が問われます。

私が受験した2026年3月時点の試験概要は以下の通りです。

  • 試験時間:120分
  • 問題数:60問(選択式)
  • 合格基準:正答率80%以上
  • 受験料:175米ドル(2回まで受験可能)
  • 試験言語:英語
  • 試験方式:オンライン、オープンブック

私が受験した際には、試験会場へ出向く必要はなく、自分のPCから都合の良い時間に受験できました。

なお、2026年10月4日からは日本語での受験も可能になりました。試験制度は変更される可能性があるため、最新情報はCSA公式サイトをご確認ください。

■ これまでの経験と保有資格

私はIT業界で30年以上、主にサーバやネットワークなどのインフラ運用、セキュリティマネージャ、セキュリティ領域中心のアーキテクトなどの仕事に携わってきました。現在は主としてセキュリティ関連のプリセールスやコンサルティングを担当しており、アーキテクト研修の講師や、社内のセキュリティ技術コミュニティの運営なども行っています。

保有資格にはCISSP、CCSP、AWS Solutions Architect – Associate、AWS Security Specialty、G検定などがあり、資格取得にあたっては、個別製品の操作や設定方法よりも、長く使えて陳腐化しにくい知識を身に付けることを重視しています。例えば、2014年に取得したCISSPでは「リスクの考え方」を、2020年に取得したCCSPでは「クラウドの責任共有モデル」を叩き込まれたと感じています。今回のCCZTにも、同じような効果を期待していました。

■ CCZT受験のきっかけ

Zero Trustについて最初に本格的に勉強したのは、2022年頃に実施したNIST SP 800-207の社内勉強会でした。当時すでにCISSPとCCSPを取得していましたが、それでもNISTの文書を理解するのはなかなか大変でした。Zero Trustの本質を理解できていたかというと、残念ながらそうではなかったように思います。2023年6月には、Palo Alto NetworksのPSE-SASEという資格も取得しました。ただし、こちらは製品知識を中心とした学習で、私の場合は短期間の試験対策で合格できたものの、実案件で利用する機会がなかったこともあり、知識がほとんど定着せず、結局、資格も更新せず失効しました。そんな中、2024年7月にCSAジャパンのFacebookグループでCCZTの存在を知りました。特定のベンダーに依存せずZero Trustを体系的に学べる資格ということで、興味を持ちました。

2025年4月には、年度内(2026年3月まで)のCCZT取得を個人目標に設定しました。目標に入れておけば、さすがに勉強するだろう、という自分へのプレッシャーです。さらに2026年1月、Zero Trustに関連する提案案件に参画することになりました。提案に関わる中で、やはりZero Trustについてきちんと説明できるレベルになっておく必要があると感じました。

もう一つ、2026年4月から社内で「セキュリティ×アーキテクチャ」をテーマとするワーキンググループ(WG)を開始する計画がありました。NIST SP 800-207を主要教材として利用する予定だったため、メンバー募集を始める3月中旬までには合格しておきたいと考えました。

こうして、いくつかの事情が重なり、ようやく本格的な受験準備を始めることになりました。

■ 使用した教材

CCZT Prep Kit

学習の中心は、CSA公式サイトから入手できるCCZT Prep Kitです。

今回、知識習得のための教材は基本的にこのPrep Kitに含まれる文献だけを使用しました。ほかにUdemyの模擬試験を利用しましたが、別の参考書や有料講座などは使用していません。Prep Kitには複数の文献が含まれています。私が特に重要と感じたものを以下に挙げます。

資料重要度主な学習ポイント
NIST SP 800-207 – Zero Trust Architecture最重要Zero Trustの7 Tenets、PE/PA/PEP、アーキテクチャと実装アプローチ
CISA Zero Trust Maturity Model v2.0最重要5 Pillars、成熟度4段階、横断的なCapabilities
NSTAC REPORT TO THE PRESIDENT最重要Five-Step Process、導入戦略、ガバナンス
Introduction to SDP Study Guide重要SPA、mTLS、IH/AH、Controller、Deployment Modelsなど
Mapping ZTA components to SDP重要上記コンポーネントとPE/PA/PEPとのマッピング
Zero Trust Planning Study Guide重要計画策定、リスク評価、責任分担、移行計画
Sample Questions(50問)重要CSA公式の設問形式、用語、出題観点

※重要度は私自身の学習における評価です。試験の出題比率を表したものではありません。中でもAuthoritative Sourcesフォルダに含まれるNIST SP 800-207、CISA Zero Trust Maturity Model、NSTAC REPORTの3つは、Zero Trustをアーキテクチャ、成熟度、導入戦略という異なる視点から理解するうえで重要だったと思います。

Udemyの模擬試験

Prep Kit以外には、Udemyで以下の2つの模擬試験を購入しました。

  • CCZT 2026 Practice Tests and Questions(6回分)
  • Certificate of Competence in Zero Trust (CCZT) – Exam Tests(5回分、現在は利用できないようです)

いずれも英語の問題集で、ディスカウント時にそれぞれ1,500円程度で購入しました。

■ 学習方法

AIをフル活用

2026年1月末頃から3月初旬にかけて、Prep Kitの学習を進めました。これまで資格試験の勉強では、文献を自力で読み、重要なポイントをExcelやOneNoteに整理する方法を取ることが多かったのですが、今回はAI(ChatGPT Enterprise)をフル活用しました。

具体的には、以下のような方法です。

  1. Prep Kitの重要文献をAIに要約してもらう
  2. 要約結果をOneNoteにコピーし、重要なポイントを赤字などで整理する
  3. その他の文献もAIで要約し、全体を把握したうえで流し読みする
  4. 理解できない箇所はAIと繰り返し議論する

特に意識したのは、AIにZero Trustの一般論を説明してもらうのではなく、指定した原文に沿って要約してもらうことです。一般的な解説としては正しくても、試験教材に書かれていることと微妙に異なっていては困ります。また、AIの説明で納得できない場合には、原文に戻って確認することも重要だと思います。

AIとの壁打ちも役に立ちました。例えば、NIST SP 800-207に登場するPolicy Engine(PE)、Policy Administrator(PA)、Policy Enforcement Point(PEP)について、何となく分かったつもりでも、それぞれの責務を明確に説明しようとすると、意外と難しいものです。AIに質問するだけでなく、自分なりの理解を説明し、その解釈が妥当かを議論することで、理解を深めました。

■ 暗記よりも構造の理解を重視

CCZTはオープンブック試験ですので、文献に書かれている細かい内容をすべて暗記することには、あまり意味がないと考えました。むしろ、Zero Trustを構成する要素の役割や相互関係を理解することを重視しました。

特に意識したのは、次のようなポイントです。

NIST SP 800-207

  • Zero Trustの7 Tenets
  • PE、PA、PEPの責務の違い
  • アクセス判断に利用されるData Sources
  • ZTAの各種アプローチやDeployment Variations

Zero Trustは単一の製品や技術を導入すれば完成するものではありません。組織の環境や要件に応じて、複数の技術やアプローチを組み合わせる必要があると理解しました。

Software Defined Perimeter(SDP)

  • Single Packet Authorization(SPA)
  • Mutual TLS(mTLS)
  • Controller
  • Initiating Host(IH)とAccepting Host(AH)
  • 各種Deployment Models

SDPについても、個々の用語を覚えるだけではなく、それぞれが何の役割を担い、どのように連携するのかを理解するようにしました。また、以前IBMからKyndrylへの分社独立を経験した際、利用者として社内IT環境の変化を体験しています。そうした実体験も思い出しながら学習することで、抽象的な概念を具体的にイメージしやすくなりました。

■ 模擬試験への取り組み

3月上旬、4日間程度でUdemyの模擬試験11回分を受験しました。模擬試験では、本番とは異なり、あえて何も参照せずに解答しました。また、時間をかけて調べたり、何度も見直したりすることはせず、できるだけ短時間で気楽に解答する方針にしました。かなりリラックスして取り組んでいたと思います(笑)。

結果は以下の通りでした。

模擬試験各回の正答率
CCZT 2026 Practice Tests and Questions85%、85%、83%、86%、81%、81%
Certificate of Competence in Zero Trust (CCZT) – Exam Tests78%、86%、74%、82%、80%

一部で80%を下回りましたが、想定していたよりも良い結果でした。なお、Udemyの模擬試験には、問題文や正答、解説に疑問を感じるものもありました。そうした問題についてはAIと議論し、必要に応じて原文を確認して理解を深めました。また、上記の正答率には、疑問を感じた問題もそのまま含めています。

模擬試験を通じて、問題文や選択肢の表現に慣れることもできました。実際の試験でも解釈に迷う問題はあり得るため、そうした問題への対応を経験できたことにも意味があったと思います。模擬試験ではおおむね合格ラインに達していたので、これ以上勉強を続けるよりも、そろそろ本番を受けてみようと判断しました。

■ 受験当日

2026年3月12日(木)の朝、仕事を始める前に受験しました。

事前にCSAの試験サイトで登録を済ませ、試験開始までの流れを確認しておきました。CCZTは試験会場の予約が不要で、自分の都合の良いタイミングで受験できるのが便利です。

結果は、1回目の受験で正答率90%、無事合格でした。ただし、決して楽な試験だったわけではありません。オープンブックとはいえ、合格ラインが80%で比較的高く、かつ、判断に迷う問題がかなりありました。Prep Kitを毎回参照していたのでは時間が足りなくなると思います。私自身、すべての問題を解答した後に見直しを行いましたが、試験終了まで数分しか残りませんでした。オープンブックだから簡単、という試験ではないと感じました。

■ 受験を終えて

今回のCCZT取得は、期待していた以上に有意義だったと思います。以前取得したベンダー資格では、製品固有の機能や設定を覚えることが中心になり、実案件で使わないと知識が定着しにくいと感じることがありました。一方、CCZTでは、Zero Trustを構成する要素やその役割、相互関係を理解することが重要でした。

特に印象に残っているのは、PE、PA、PEPの責務の違いです。以前取得したCISSPではリスクの考え方を、CCSPでは責任共有モデルを叩き込まれたと感じていますが、CCZTではPE/PA/PEPの責務を叩き込まれたという感覚があります。

もちろん、資格を取得しただけでZero Trustのすべてを理解できたわけではありません。しかし、個々の製品やサービスに依存せず、Zero Trustをアーキテクチャとして考えるための土台を得られたことは大きな収穫でした。こうした知識は比較的陳腐化しにくく、さまざまな業務に応用できると考えています。

■ 取得した知識の活用

実案件での活用

現在の業務では、Zero Trustに直接・間接的に関係する案件に携わることが少なくありません。その中では、Zero Trust製品やサービスを導入すれば短期間でZero Trust化が完了するかのような認識に接することもあります。

また、Zero Trustを議論する以前に、セキュリティ資産管理、IDとアクセス制御など、従来から重要とされてきたセキュリティの基本に課題が残っているケースもあります。CCZTの学習を通じてZero Trustの全体像を整理できたことで、そうした問題に比較的早い段階で気付き、何を優先して検討すべきかを考えやすくなったと感じています。

社内WGでの活用

合格翌日の2026年3月13日、社内で「セキュリティ×アーキテクチャ」をテーマとするWGのメンバー募集を開始しました。WGは4月から活動を開始し、NIST SP 800-207を主要教材として、Zero Trustの基本原則や論理コンポーネントについて学習・ディスカッションを進めています。

私自身、CCZTの学習では理解に苦労した部分も多かったため、その経験を踏まえて、メンバーが段階的に理解を深められるように学習の進め方を考えました。例えば、NISTのPE/PA/PEPやData Sourcesを学んだ後、具体的な製品・サービスがどのような機能を持ち、論理コンポーネントにどう対応するのかを考える、といった進め方です。

WGにはさまざまな専門分野のメンバーが参加しており、私自身が知らない製品やサービスについては、メンバーから教えてもらうことも多くあります。資格取得で得た知識をWGで活用し、ディスカッションを通じてさらに理解を深めるという良い循環ができているように思います。

また、2026年7月にはCSAジャパンのWGセミナーで「企業内技術コミュニティ活動のすすめ」というタイトルで登壇し、これまでのWG活動や運営上の工夫などをご紹介する機会もいただきました(講演資料・録画)。

■ これから受験される方へ

CCZTは、Zero Trustを製品の観点だけでなく、アーキテクチャとして体系的に理解したい方におすすめできる資格だと思います。特に、セキュリティアーキテクト、コンサルタント、Zero Trust関連の提案・設計に携わる方には、学ぶ価値があると感じています。

受験にあたっては、まずCSA公式のPrep Kitを十分に活用することをおすすめします。オープンブック試験ですが、試験中に文献を調べれば何とかなると考えるのではなく、重要な概念や構成要素の役割を事前に理解しておくことが大切です。

また、今回の私のようにAIを学習補助として活用するのも一つの方法だと思います。単に要約を作らせるだけでなく、分からないことを質問したり、自分の理解が正しいか議論したりすることで、学習効率を高められます。

私は、資格取得の価値は合格証そのものよりも、そこに至るまでの学習で何を身に付けられたかにあると考えています。今回のCCZTでは、Zero Trustを理解するための考え方や構造を整理できたことが、何よりの収穫でした。今後も実案件やWG活動を通じて、さらに理解を深めていきたいと思います。

以上

クラウドサービスにおけるバックアップの責任分担と復旧可能性 ~ IDCフロンティアのセキュリティ事故とAWSの契約条件を踏まえた考察

2026年10月15日更新
2026年10月11日
ガイダンスWGリーダー 諸角昌宏

【第5報反映】改訂箇所の表示:赤色マーカーおよび「【第5報反映】」は、2026年10月14日付第5報を受けた追記・修正を示す。

要旨

【第5報反映】IDCフロンティアの事故では、当初はデータの取り出し・復元が困難とされたが、10月14日付第5報により、影響を受けた495の企業・自治体のうち、スナップショット機能を利用する194の利用者についてバックアップデータを取り出せることが確認された。ただし、復元の可否は引き続き確認中である。

背景

2026年10月、IDCフロンティアが提供するクラウドサービス「IDCFクラウド」において、ランサムウェアによる被害が発生し、一部の顧客の仮想マシンやデータの利用に影響が生じた。この事故は、クラウドサービスにおけるデータ保護やバックアップのあり方、特にクラウドサービスプロバイダ(CSP)とクラウドサービスカスタマ(CSC)の責任分担について、改めて考える契機となる。

クラウドサービスでは、一般に責任共有モデルに基づき、CSPとCSCがそれぞれの責任を負う。しかし、バックアップについては、「クラウドに保存したデータはCSCが自らバックアップしなければならない」という理解がある一方、CSPがバックアップ機能を提供し、その取得・保存・復元処理を実施するサービスも存在する。このため、CSPが提供するバックアップ機能を利用している場合にも、CSCが独立したバックアップを取得する必要があるのか、また、バックアップの取得・保存・復元に関して、CSPとCSCはそれぞれどのような責任を負うのかという点を整理する必要がある。

本ブログでは、IDCフロンティアの事故を検討の契機として、ISO/IEC 27017における責任分担の考え方、IDCフロンティアおよびAWSの公開資料、データ耐久性とバックアップの違いなどを整理し、CSCがバックアップをどのように確保すべきかを考察する。

なお、本ブログは、IDCフロンティアの事故原因、同社のセキュリティ対策の適否、契約違反の有無、法的責任の所在を判断するものではない。事故に関する記述は公開情報に基づくものであり、今後の調査結果によって変更される可能性がある。

注)本ブログでは、ISO/IEC 27017で用いられている用語に従い、クラウドサービスプロバイダを「CSP(Cloud Service Provider)」、クラウドサービスカスタマを「CSC(Cloud Service Customer)」と表記する。なお、契約条件や公表資料からの引用については、原文の表記を維持する。

要旨

CSCが、必ず自らバックアップを取得しなければならないとは言い切れない。CSCは必要なデータ保護要件を定義し、それが満たされるように確保・確認する責任を負う。一方、バックアップ取得・保持・復元の実行は、契約と設定に応じてCSPが担い得る。IDCフロンティアの事故では、複数ゾーンの顧客データの取り出し・復元が困難とされた点が重大であるが、独立した有料バックアップサービスの保存データが失われたか、契約どおりに復元できたかは現時点では未確定である。

1.基本概念:責任と作業の区別

「CSCにバックアップ確保責任がある」ことは「CSCが独自の別システムを構築してバックアップを実行する義務がある」ことと同義ではない。また、CSPにバックアップ処理を委ねても、CSCによる要件定義・契約評価・設定確認の責任が当然に消滅するわけではない。整理すると以下の表になる。

区分意味典型的な担当
要求事項の定義・確保責任保護対象、RPO、RTO、保存期間、攻撃耐性を定め、充足を確認CSC
取得・保存の実施責任設定された計画に基づきバックアップを取得・保持契約・サービス仕様に応じてCSPまたはCSCが実施
バックアップの保護責任削除・改ざん・権限侵害からの保護契約・サービス仕様に応じてCSPとCSCが分担
復旧と検証復元手順、定期試験、代替環境への復旧契約・設定による分担

2. ISO/IEC 27017の要件

ISO/IEC 27017では、CSCに対して以下の2点を要求している(なお、ここの記述はISO/IEC 27017の手引きの記載内容を意訳したものである):

  1. CSPがバックアップ機能を提供している場合、CSCはその仕様を要求することが望ましい。CSCはその仕様が自らの要求事項を満たすことを検証する。
  2. CSPのバックアップ機能がCSCの要求事項を満たさない場合、CSCがバックアップ機能の導入に責任を負う。

これらはCSPによるバックアップ機能の提供を想定し、機能が提供されないあるいは機能が要求事項を満たさない場合のCSCの責任を明確化している。一方、「CSPが機能を提供すればCSPが全責任を負う」と結論することはできない。機能の有無、実際の有効化・取得、保存・復元条件、契約上の役割分担を確認する必要がある。

3.クラウドバックアップの技術要件

クラウドバックアップの技術的な要件は以下のようになる。

観点検証ポイント
保護対象仮想ディスクだけでなく、アプリケーション、データベース、設定、鍵、復元に必要なメタデータを含んでいるか
独立性本番とは別の障害領域、管理権限、可能なら別アカウント・別拠点に分離されているか
耐改ざん性イミュータブル保管、削除防止、保持期間、特権ID侵害時の防御があるか
復旧可能性実際に復元できるか、整合性・RPO・RTOを満たすか、定期試験があるか
責任と透明性バックアップ機能の仕様、除外範囲、前提設定、障害時の制約がCSCに明示されているか

したがって、スナップショットは迅速な復旧に有効だが、管理基盤の侵害から独立していなければ、ランサムウェアに対する十分な復旧手段とは限らない。保存先の物理的分離と、削除・改ざん権限の分離は別の要件である。

4.IDCフロンティアの公開仕様・契約条件

IDCフロンティアの公開情報には、標準IaaSで顧客の責任の下にバックアップ等を行う旨のサービス提供条件がある。また、スナップショット機能と、別拠点のストレージを利用する「IDCFクラウド バックアップ」を区別して提供している。公開FAQでは、スナップショットにはランサムウェア対策がない一方、バックアップサービスにはイミュータブルストレージがあると説明している。

このため、標準IaaSでの顧客のバックアップ確保責任は確認できるが、バックアップサービスを別途契約・設定していた顧客に対するCSPの個別の履行責任は、サービス仕様書・約款・個別契約を併せて検討しなければならない。

なお、IDCフロンティアの契約には、顧客データの消失などによる損害について、同社が賠償責任を負わない旨の免責条項がある。しかし、免責条項が存在するからといって、すべての事故について同社が責任を免れるとは限らない。実際に免責が認められるかどうかは、事故原因、同社の過失の有無や程度、適用される契約条件などによって判断される。特に、故意または重大な過失があった場合には、免責条項の効力が制限される可能性がある。

5.AWSの契約・サービスとの比較

AWS Customer Agreement 第2.3条(Your Security and Backup)は、顧客がサービスを適切に設定・利用し、アカウントと顧客コンテンツの保護・バックアップのため適切な措置を講じる責任を定めている。AWS Backupでは顧客がバックアップ計画・対象等を設定し、AWSがマネージドサービスとして取得・保存・復元機能を提供する。Vault Lock、クロスアカウント・クロスリージョンコピー、復元テスト等の機能もある。

論点IDCフロンティアAWS
標準IaaSのバックアップ確保責任原則として顧客原則として顧客
CSP提供のバックアップスナップショット、別拠点バックアップEBSスナップショット、AWS Backup等
保護機能別拠点・イミュータブル機能(サービス別)Vault Lock等(構成・サービス別)
CSPのサービス履行責任個別仕様・約款の検証が必要契約・サービス条件の検証が必要

AWSであっても顧客による適切な設定や復元試験は重要であり、AWSの機能があること自体は、いかなる事故でもデータが失われないという保証ではない。

6.IDCフロンティア事故:確認事項と未解明事項

公開情報から確認されている事項

【第5報反映】2026年10月7日からの不正アクセスによる障害は、東日本リージョン1のtesla、henry、pascal、jouleの4ゾーンに影響した。当初IDCフロンティアは、対象データの取り出し・復元が困難との見通しを示していた。しかし10月14日付第5報では、影響を受けた495の企業・自治体のうち、スナップショット機能を利用していた194の利用者について、バックアップデータの取り出しが可能と確認したと公表した。取り出したデータの復元可否と提供方法は引き続き確認中である。これは本番環境の停止に加え、事故後のデータ回収・復元能力がCSCの事業継続に直結することを示している。

【第5報反映】第5報による情報流出の調査結果:IDCフロンティアは、対象4ゾーンの仮想サーバー内データについて、外部持ち出しを示す痕跡等は確認されず、流出はなかったと判断した。一方、クラウドポータルでは48社の登録情報への不正な照会を確認しており、仮想サーバー内データとポータル登録情報を区別して評価する必要がある。

未解明であり、断定してはならない事項

【第5報反映】第5報時点で、スナップショットデータの「取り出し可能」と「実際に正常復元できる」は同義ではない。また、194という数字はスナップショット利用者についての公表値であり、残る301の利用者にバックアップがない、または復元できないと断定できない。スナップショットと別サービスの「IDCFクラウドバックアップ」も区別する。侵入経路の全容、攻撃者の破壊主張の真偽、バックアップサービスの個別契約に対する履行状況については、追加の証拠が必要である。

未解明の論点評価に必要な証拠
4ゾーンに被害が及んだ経路侵入経路、共通管理プレーン、特権ID、ゾーン間の権限・障害分離
スナップショットの被害194利用者分のスナップショットデータは取り出し可能。復元可否は確認中
別拠点バックアップの健全性別サービスの「IDCFクラウド バックアップ」の状況は区別して確認
有料バックアップ利用顧客の復元実績契約・設定状況、RPO/RTO、復元成功率・所要時間
責任分担と契約履行事故当時の適用約款、サービス仕様書、個別契約、保証・免責条件

【第5報反映】第5報により、一部のスナップショットデータを取り出せる可能性が具体的に確認された点は、当初の復旧見通しを更新する重要な事実である。一方、復元成功、RPO・RTOの達成、別途契約されたバックアップサービスの履行状況は、この発表だけでは確定できない。したがって、CSP提供バックアップが一律に機能しなかったとも、十分に機能したとも断定できない。

なお、攻撃者が主張した破壊件数や容量は、事業者が裏付けた確定事実とは扱わない。また、4ゾーンに影響が出たことだけから、テナント分離の破綻やバックアップ基盤の共通障害を断定することはできない。

まとめ

  1. 「CSCは自らバックアップを取得しなければならない」との一律の表現は不正確である。
  2. 「CSCが必要なバックアップを確保・確認する責任を負う」は一般的なIaaS契約と整合する。
  3. CSPが提供するバックアップ機能がCSCの要求事項を満たし、適切に契約・設定され、バックアップの取得・保存・復元が可能であれば、CSCが別途、独立したバックアップを取得することは必ずしも必要ではない。
  4. この場合、CSCは必要なバックアップの要件を定め、実際に復元できることを確認する責任を負い、CSPは契約に従ってバックアップサービスを提供する責任を負う。また、CSPには、バックアップサービスの提供に加えて、クラウド基盤そのものを適切に保護する責任もある。

IDCフロンティアについては、4ゾーンの本番データが復元困難となったこと自体が重大である。一方、CSPが提供した独立バックアップが契約どおり機能しなかったと断定するには、バックアップ利用顧客の復元実績と事故時点の適用契約の確認が不可欠である。

8.クラウドサービスカスタマへのバックアップ推奨事項

基本原則:CSPのバックアップ機能がCSCの要求事項を満たし、適切に契約・設定され、必要なバックアップが実際に取得・保持され、復元可能であることが検証されているなら、CSCが独立したバックアップを必ず追加する必要はない。これは「独立したバックアップは不要」という一般論ではなく、リスク評価に基づく条件付きの判断である。

CSCは、バックアップ処理を自ら実施することと、必要なデータ保護・復旧能力を確保する責任を区別する。CSPに実施を委ねる場合でも、要件定義、契約・設定確認、復元可能性の検証は必要である。

推奨する確認事項

以下の確認事項は、CSCが独立したバックアップを取得することを前提とするものではなく、CSPが提供するバックアップ機能によってCSCの要求事項を満たせるかを確認するためのものである。要求事項が満たされ、残余リスクも許容できる場合には、CSCが独立したバックアップを追加することは必須ではない。

  • 保護対象:仮想マシン、ディスク、データベース、設定、暗号鍵、認証情報など、復旧に必要な要素を漏れなく特定する。
  • 復旧目標:許容データ損失(RPO)、目標復旧時間(RTO)、保存期間、世代数、データ整合性を明確にする。
  • 契約・仕様:CSPが取得・保持・保護・復元のどこまでを担うか、除外事項、SLA、免責、障害時の支援を確認する。
  • 設定・運用:バックアップ対象の割当て、スケジュール、保持設定、失敗通知、アクセス権限を点検する。
  • 攻撃耐性:本番環境との管理権限の分離、削除・改ざん防止(イミュータビリティ)、別拠点・別アカウント等の必要性をリスクに応じて評価する。
  • 復元検証:バックアップの存在確認だけでなく、定期的な復元試験でデータ整合性、復元時間、代替環境への復旧を検証する。
  • 残余リスク:CSPの管理基盤への不正アクセス、リージョン全体の障害、契約終了時のデータ移行、特定事業者への依存などのリスクを評価する。その結果、CSPが提供するバックアップ機能だけではCSCの要求事項を満たせない場合や、追加の保護が必要と判断される場合には、CSPから独立したバックアップの導入を検討する。

独立した追加バックアップの要否を判断する基準

追加が必須とは限らない例:CSP提供機能で必要なRPO・RTO、保持、改ざん防止、管理権限分離、復元試験が満たされ、想定脅威に対する残余リスクを組織が受容できる場合。

追加を検討すべき例:CSP提供機能が本番環境と同じ侵害経路に依存する場合、復元試験ができない場合、リージョン全体の喪失やCSP管理基盤の侵害を想定する場合、法令・契約上の独立保管要件がある場合。

【第5報反映】IDCフロンティア事故への適用:第5報ではスナップショット利用者194のバックアップデータについて取り出し可能と確認されたが、復元の可否は確認中である。CSCの要件設定・検証責任と、CSPの基盤保護・契約サービス提供責任を区別する。別サービスの「IDCFクラウド バックアップ」の個別復元実績を、このスナップショットの報告からはわからない。

IDCフロンティア事故への適用:標準IaaSのバックアップ確保責任と、契約済みバックアップサービスの履行責任を分けて評価する。バックアップサービス利用顧客の復元実績、保存データの健全性、管理権限分離が未公表である限り、サービス自体の失敗も成功も断定しない。

参考:AWS Backupの公式資料では、クラウドサービスカスタマがバックアップ計画と対象リソースを適切に設定し、定期的に復元可能性を検証する責任を負うことが明記されている。一方、バックアップの取得・保持や復元テストの実行については、AWS Backupの自動化機能を利用できる。したがって、カスタマがすべてのバックアップ処理や復元テストを自ら実施する必要はない。ただし、バックアップの対象、保持期間、復旧目標、復元結果などが組織の要求事項を満たしていることを確認する責任はカスタマに残る。
https://docs.aws.amazon.com/ja_jp/wellarchitected/latest/framework/rel_backing_up_data_secured_backups_data.html

9.データ耐久性(11ナイン)とバックアップの関係

AWSがAmazon S3 Standardについて公表する99.999999999%(イレブンナイン)は、年間のオブジェクト耐久性に関する設計上の数値である。これはサービスの可用性、バックアップの取得状況、過去の正常な状態への復元可能性、または損害賠償を保証する数値ではない。

耐久性は、保存済みデータがストレージ障害等によって失われにくい性質を指している。一方、バックアップは、誤削除、論理的な破損、悪意ある変更、ランサムウェア攻撃などを想定し、必要な過去時点のデータを保持して復元するための手段である。複数のアベイラビリティゾーン(AZ)にデータを分散して保存していても、誤削除やランサムウェア攻撃によって変更されたデータが他のAZにも反映される場合がある。そのため、複数AZへの冗長配置だけでは、障害や攻撃が発生する前の正常なデータに復元できるとは限らない。

CSCへの推奨事項

CSCは、CSPが公表する耐久性の数値のみを根拠に、バックアップが不要と判断してはならない。データの重要度、誤削除・改ざん・管理権限侵害・リージョン障害等の想定事象、必要な保存世代、RPO・RTOを定義し、提供されるバックアップ機能の保護範囲と復元手段を評価する必要がある。

一方、CSPのバックアップ機能がCSCの要求事項を満たし、適切に契約・設定され、バックアップが実際に取得・保持され、想定する障害・攻撃に対して復元可能であることを検証できる場合、CSCがCSPとは独立したバックアップを必ず追加する必要はない。追加バックアップの要否は、共通管理権限への依存、削除・改ざん耐性、別アカウント・別リージョンでの保管、復元試験の結果、リスク許容度に応じて判断する。

【第5報反映】第5報は、ストレージの耐久性、バックアップデータの取り出し可能性、業務システムの復元成功が別々の評価項目であることを示している。スナップショット利用者194のデータが取り出せると確認された一方、復元の可否は確認中である。CSPのバックアップ機能が要求事項を満たすかは、正常な復元の実績、RPO・RTO、保護設定、管理権限の独立性などで評価する。

IDCフロンティア事故との関係

今回の事故の評価では、ストレージの耐久性に関する数値と、侵害後に正常なバックアップから復元できるかを混同すべきではない。重要なのは、各バックアップ方式が本番環境や管理プレーンの侵害からどの程度独立し、契約・仕様に沿って復元可能だったかである。事故におけるバックアップデータの実際の被害範囲と復元実績は、公開情報だけでは確定できない。

10. 免責事項

本ブログは、公開時点で入手可能な公表資料、契約条件、技術文書および関連規格に基づき、クラウドサービスにおけるバックアップの責任分担とデータ保護の考え方を整理したものである。

特定のクラウドサービスプロバイダの事故原因、セキュリティ対策の適否、契約違反の有無、法的責任の所在などについて、断定的な評価を行うことを目的とするものではない。

本ブログに記載した事実関係は公開時点の情報に基づいており、今後の調査結果や新たな情報の公表によって変更される可能性がある。また、ISO/IEC規格や各種ガイドラインに関する記述は、筆者による解釈・考察を含むものであり、規格制定機関等の公式見解を示すものではない。

本ブログは一般的な技術情報および制度上の考察を提供するものであり、個別の契約に関する法的助言や、特定のシステムに対するセキュリティ対策の有効性を保証するものではない。具体的な判断にあたっては、適用される契約条件、サービス仕様および組織の要求事項を確認し、必要に応じて専門家に相談すること。

11. 参考資料

以上

最近、なぜセキュリティ事故が多いのか ~ AI時代のサイバー攻撃を考える

2026年10月16日更新
2026年10月9日更新
2026年10月7日初版
AIWGメンバー 諸角昌宏

【2026年10月16日 更新】10月16日分を赤色で示す。10月16日更新内容は、JPCERT/CCによる攻撃者のAI利用の確認(第4章、第12章)部分である。結論と3層の整理は変更していない。

【2026年10月9日 更新】初版の公開後に確認した情報を追記した(緑字で示す)。追記したのは、警察庁の2026年上半期の統計、AIの悪用を指摘する報道とGambit Securityの報告、金融庁・日本銀行の要請である。結論と3層の整理は変更していない。

2026年に入り、日本国内でサイバー攻撃や情報漏洩、ランサムウェア、不正アクセスなどの情報セキュリティ事故が相次いで公表されている。特に夏から秋にかけては、企業、大学、公共機関などさまざまな組織からインシデントが公表され、「最近、セキュリティ事故が増えているのではないか」と感じる機会が多くなった。一方、2026年は生成AIやAIエージェントの利用が急速に広がった年でもある。そこで気になるのが、「最近のセキュリティ事故の多発とAIの普及には関係があるのか」である。

本ブログでは、警察庁、IPA、Verizon、IBM X-Force、Google Cloud/Mandiantなどの公開情報、および国内の民間調査を基に、この問題を整理する。そのうえで、CSAジャパンブログに掲載された筆者の「Mythosレディ」シリーズで示した3層(基本対策、ゼロトラスト、VulnOps / CTEM)に沿って、対策をまとめてみる。

本当にセキュリティ事故は増えているのか

最初に注意しなければならないのは、「ニュースで目にする事故が増えた」ことと「実際のインシデント発生率が増えた」ことは同じではないという点である。デジタルアーツ株式会社が、対象組織による公開報告書およびマスメディアの報道資料を基に独自集計した「2026年上半期国内セキュリティインシデント集計」によれば、2026年1~6月に情報漏えい等のセキュリティインシデントによる被害・影響を公表した国内組織は727件であった。このうち「不正アクセス」が267件で最も多く、「マルウェア感染」が153件でこれに続いている[1]。ただし、この727件は727回の独立したサイバー攻撃を意味するものではない。同調査では、例えば委託先1社への攻撃によって複数の委託元企業が被害を公表した場合、それぞれの公表組織を1件として計上している。したがって、「国内で727回のサイバー攻撃が発生した」と読み替えることは適切ではない。

さらに、もう一つ注意すべき点がある。攻撃の発生日と公表日は一致しない、ということである。調査に数週間から数カ月を要した後に公表されるケースもあるため、特定の月に公表が集中したからといって、その月に攻撃そのものが急増したとは限らない。 警察庁のランサムウェア統計を見ても、この点は興味深い。企業・団体等から警察庁に報告されたランサムウェア被害は、次のとおりである。[6]

年報告件数
2021年146件
2022年230件
2023年197件
2024年222件
2025年226件

【10/9更新】2024年の222件から2025年は226件であり、大幅な増加ではない。したがって、「最近になって突然ランサムウェアが爆発的に増加した」というより、高い攻撃水準が数年間継続していると表現する方が正確である。[6]

【10/9更新】ただし、2026年に入ってこの水準はさらに上がっている。警察庁が2026年9月10日に公表した上半期の統計では、ランサムウェア被害の報告件数は123件で、統計を取り始めた2020年下半期以降、半期として最多となった[14]。2025年は上半期が116件、下半期が110件だったので、急増とまでは言えないが、高止まりから増加に転じた可能性がある。 被害組織の内訳は、規模別では中小企業79件、大企業31件、団体等13件である。業種別では製造業が37件で最も多く、卸売・小売業15件、情報通信業、不動産・物品賃貸業、医療・福祉が各9件、建設業8件、その他36件と続く[14]。特定の規模や業種に限られた問題ではないと思われる。

日本だけで起きている現象なのか

この傾向は日本だけに限らない。Verizonの「2026 Data Breach Investigations Report(DBIR)」では、31,000件を超えるセキュリティインシデントと22,000件を超えるconfirmed data breachが分析対象となった。前年の2025 DBIRではconfirmed breachは12,195件だったため、分析対象件数自体は大きく増えている[7][8]。ただし、DBIRは世界中の法執行機関、セキュリティ企業、保険会社などから提供されたデータを集約している。そのため、この数字をそのまま「世界の侵害件数が約80%増加した」と解釈することはできない。重要なのは攻撃方法の変化である。2026 DBIRでは、脆弱性悪用が31%を占め、初期侵入経路として初めて盗用された認証情報を上回った。[8]

IBM X-Forceの2026 Threat Intelligence Indexでも、2025年には公開アプリケーションの脆弱性悪用を起点とした攻撃が前年比44%増加したと報告されている。また、活動しているランサムウェア/恐喝グループも増加している[9]。つまり世界的に、次の4つが引き続き大きな問題となっている。

  • 脆弱性悪用
  • ID・認証情報の悪用
  • ランサムウェア/恐喝
  • サプライチェーン攻撃

日本の最近の事故では何が狙われているのか

では、日本国内で2026年に公表された最近のインシデントでは、どのような侵入経路が使われているのだろうか。2026年夏以降については、Aioright Technologies株式会社が、2026年7月1日から10月4日までに国内で検知または公表された143件を公開情報に基づいて集計している[2]。このうち126件が確認済みのサイバー攻撃と分類され、不正アクセスが74件(58.7%)を占めている。さらに重要なのが初期侵入経路である。126件中、初期侵入経路を公開情報から分類できたのは58件であり、その内訳は次のようになっている。

初期侵入経路件数割合
脆弱性悪用23件39.7%
ID・認証関連20件34.5%
サプライチェーン11件19.0%
設定・実装不備2件3.4%
マルウェア感染2件3.4%
合計(分類できた事案)58件100.0%

つまり、侵入経路を分類できた58件に限れば、脆弱性悪用+ID・認証関連=43件、74.1%になる[2]。ただし、この数字についても注意が必要である。確認済みサイバー攻撃126件のうち68件(54.0%)は、初期侵入経路が不明または非公表である。そのため、「日本国内のサイバー攻撃の74.1%が脆弱性またはIDを原因としている」という意味ではない。あくまで、「公開情報から侵入経路を分類できた58件では、74.1%が脆弱性悪用またはID・認証関連だった」と解釈する必要がある。つまり、公開情報から侵入経路を分類できた事案では、脆弱性とIdentityが主要な侵入要因となっているということである。

これは警察庁の過去のランサムウェア調査とも整合する。2024年にランサムウェア被害を受けた企業等へのアンケートでは、侵入経路としてVPN機器が55%、リモートデスクトップが31%を占めていた[10]。ここから見えてくるのは、極めて「従来型」の問題である。VPNやネットワーク機器の脆弱性、盗まれた認証情報、弱い認証、過剰なアクセス権限、委託先やサプライチェーン。これらはAIが登場する以前から存在していた問題である。

ではAIは関係ないのか

ここが今回の問題を考えるうえで最も重要なポイントである。

【10/9更新】2026年に日本で公表された主要インシデントを確認しても、「攻撃者が生成AIやAIエージェントを利用したため侵害された」と明確に公表された事案は、確認した範囲では見つからなかった。したがって、「2026年に日本でセキュリティ事故が増えているのはAIのせいである」と結論づける根拠は、現時点では確認されていない。

【10/9更新】2026年10月に入り、相次ぐ情報漏えいの背景にAIの悪用があるとみる報道や専門家の指摘が増えている。しかし、筆者が確認した範囲では、これらは状況からの推測であり、被害組織がAIの使用を公式に認めた国内事案は見当たらない。指摘されていることと、確認されていることは区別しておきたい。

【10/16更新】その後、JPCERT/CCは2026年10月15日、一連の事案で攻撃に使用された可能性のあるインフラを調査した結果、「攻撃者がAIを利用して、既知の脆弱性のスキャンやAPI経由での攻撃などを実施していたことを確認しました」と公表した[17]。一連の事案に関わる攻撃者がAIを利用していたことが、調査に基づいて確認されたことになる。

【10/16更新】ただし、この記述には限定がある。同記事は、調査したインフラと個別の事案との対応を示しておらず、調査対象の一部は「今回の攻撃とは直接関係しない別のサーバー」としている。また、一部の報道では「AIエージェント」の使用とも伝えられているが、JPCERT/CCの記事は「AIを利用して」とするにとどまり、AIが自律的に攻撃を進めていたかどうかには触れていない。したがって、「一連の事案はAIエージェントによるものだ」とまでは言えない。

【10/16更新】むしろ注目すべきは、AIが何に使われていたかである。JPCERT/CCが確認したのは、既知の脆弱性のスキャンや、スマートフォンアプリを解析してその裏側にあるAPIの弱点(SSRFなど)を探る行為だった。推奨している対策も、アプリに秘密鍵や長期間有効な認証情報を埋め込まない、サーバー側で認証・認可を行う、レート制限と異常なリクエストの監視を行う、といった基本的なものである[17]。AIは新しい攻撃を生み出したのではなく、既存の弱点を探し突く作業に使われていたということになる。

しかし、「AIはサイバー攻撃に関係していない」という結論も正しくない。IPAは2026年の「AIセキュリティ短信」などで、次のような動きを取り上げている[11]。

  • AIエージェント群による自律的な侵入
  • AIを利用した攻撃コード生成
  • AI支援によるマルウェア開発
  • LLMを利用した金融不正
  • AIエージェントによる企業侵入時間の短縮

つまり、AIを攻撃に利用する動き自体はすでに現実のものとなっている[11]。

AIは「原因」ではなく「脅威増幅要因(Threat Multiplier)」

この状況を理解するには、AIを新しい攻撃手法そのものと考えない方がよいと思われる。AIが大きく変えようとしているのは、次の3点である。

  • Speed(速度)
  • Scale(規模)
  • Automation(自動化)

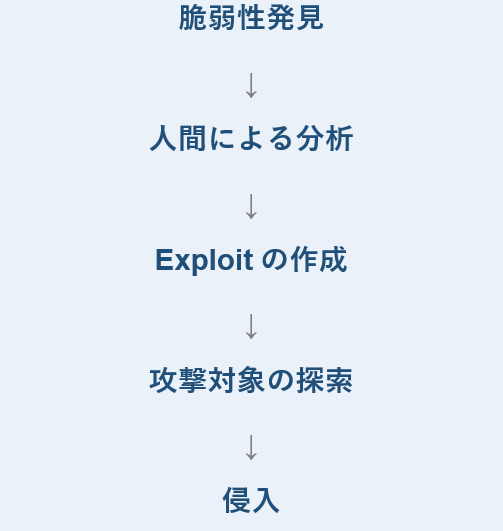
例えば従来の脆弱性攻撃では、次のプロセスが必要だった。

AIやAIエージェントを利用すれば、この一部を自動化できる可能性がある。同じことはフィッシングにも当てはまる。生成AIを利用すれば、大量のメールを作るだけでなく、標的に合わせた自然な文章を短時間で作成できる。

【10/9更新】この変化を具体的に示す報告がある。Gambit Securityは2026年9月、ある攻撃者の中継サーバーを分析した暫定報告を公表した[15]。それによると、攻撃者は3種類のオープンソースのAIツールを組み合わせ、脆弱性の探索から侵入、データの持ち出しまでの大部分を自律的に実行させていた。260セッションで人間が入力した指示は1,951件にとどまる。6日間に105件の攻撃が開始され、少なくとも27社で侵害が確認された。1標的あたりのコストは、完了した101件の平均で約25ドルである。

【10/9更新】注目すべきは、そこで使われた手口である。SQLインジェクション、ファイルアップロード機能の不備、設定ファイルに残された認証情報など、いずれも以前から知られている弱点だった。変わったのは手口ではなく、それを試す速度と規模、そしてコストである。なお、これは1つの攻撃グループに関する暫定的な調査結果である。被害例には日本の旅行予約サイトも含まれるが、本ブログで見た国内の公表事案との関係は確認されていない。

つまりAIは、新しい脆弱性を生み出しているというより、既に存在する脆弱性を攻撃する能力を増幅していると考える方が現状を説明しやすい。この意味でAIは、Root Cause(根本原因)ではなく、Threat Multiplier(脅威増幅要因)と位置付けるのが適切である。

「AI普及」と「事故増加」の因果関係は証明されていない

ここでは相関関係と因果関係を区別する必要がある。現在、AI利用の拡大と同時に、次のような動きが観測されている。

  • 脆弱性探索の高速化
  • 攻撃コード生成支援
  • フィッシング高度化
  • マルウェア開発支援
  • AIエージェントによる攻撃自動化

また日本では、不正アクセス、ランサムウェア、情報漏洩など多数の事故が公表されている。しかし、AI利用の増加→日本のセキュリティ事故件数の増加という因果関係を直接示す統計は、現時点では存在しない。

Mandiantも2026年のM-Trendsにおいて、2025年を「AIが直接breachを引き起こした年」とは位置付けていない。一方で、攻撃者が偵察、ソーシャルエンジニアリング、マルウェア開発などでAIを利用し、生産性を向上させていることは確認している。この区別は非常に重要である[12]。

本当に変わりつつあるのは「時間」である

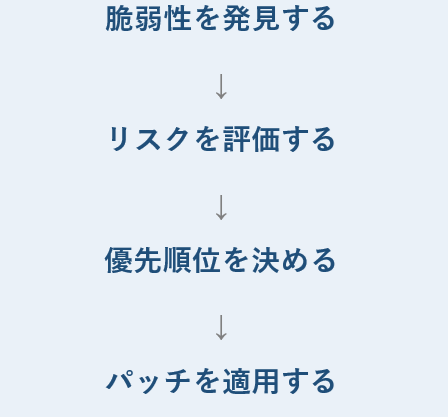
AI時代のサイバーセキュリティで特に注目すべきと考えるのは、攻撃件数そのものよりも、攻撃に必要な時間の短縮であると考える。これまで防御側には、次のプロセスに充てる一定の時間があった。

しかし攻撃側の脆弱性探索、分析、攻撃コード生成、対象探索がAIによって高速化すると、脆弱性が攻撃可能になるまでの時間が短くなる。これは防御側にとって非常に大きな意味を持つ[8][12]。「毎月脆弱性スキャンを実施する」「年に数回ペネトレーションテストを実施する」といった周期型の脆弱性管理では、攻撃側の速度についていけなくなる可能性がある。

対策をどう整理するか ― 「Mythosレディ」の3層

では、攻撃側の時間軸が変わりつつある状況で、防御側は何から手を付ければよいのか。ここでは、CSAジャパンブログに掲載した筆者の「Mythosレディ」シリーズ[3][4][5]で示した3層に沿って整理したい。

同シリーズは、Anthropicが2026年4月に発表したClaude Mythos Previewを契機に、機械速度の攻撃が常態化する世界で組織が取るべき対策を論じたものである。そこでは、「Mythosレディ」を特定のAIツールへの対抗策としてではなく、背後にある構造的リスクに継続的に適応し続けられる組織の状態として捉えた[3]。これは、AIを根本原因ではなく脅威増幅要因と見る本ブログの立場と一貫している。

【10/9更新】規制当局も同じ問題意識で動いている。金融庁と日本銀行は2026年5月22日、脆弱性の発見から攻撃に至るまでの期間が大幅に短縮され得るとして、金融機関等に9項目の短期的な対応を要請した[16]。優先的に対応すべきサービスやITシステムの特定、技術負債の解消、リスクベースのパッチ適用、パッチ適用以外の対策の強化、停止への備えなどであり、以下に示す3層と重なる内容である。

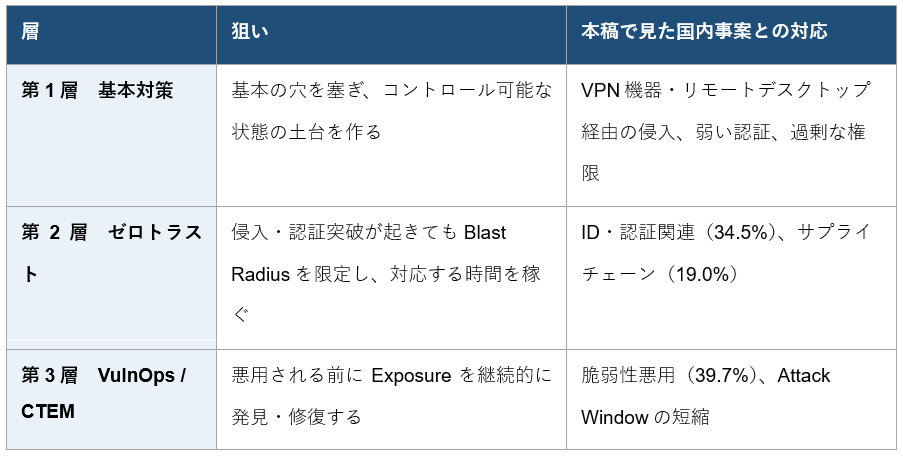
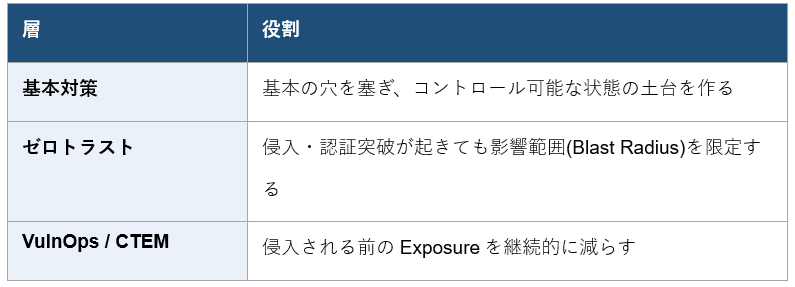
同シリーズで示した対策は、次の3層である。

この3層は、上から順に完成させていくものではなく、同時並行で育てていくものである。以下、順に見ていきたい。

第1層:基本対策 : まず基本の穴を塞ぐ

シリーズ第1回[3]では、Mythosレディへの第一歩を、新しいAI防御製品の導入ではなく、基本的なセキュリティの強化に置いた。その前提にあるのは、情報セキュリティの目的を「コントロール可能にすること」と捉える考え方である[3]。攻撃を完全に防ぐことはできなくても、影響を封じ込め、回復し、次に備えられる状態を保つことはできる。そして攻撃者は最も弱い点を狙うため、高度な対策より先に基本の穴を塞ぐ必要がある。 同ブログでは、今すぐ取り組む基本強化として5つの領域を挙げた。本ブログで見た国内事案と対応させると、次のようになる。

領域主な内容国内事案との関係
資産管理IT資産、SBOM、シャドーIT、AIエージェント資産を継続的に把握する把握していないVPN機器や公開サーバーは、修正も監視もできない
ネットワークセグメンテーション機能・リスク別に分離し、横展開を遮断する侵入後の被害拡大(ランサムウェアの全社展開など)を抑える
パッチ管理の継続化CVSSではなくKEVなど実際の悪用状況で優先する。同ブログでは、クリティカルパッチについて24時間以内の適用を目標例としている脆弱性悪用(39.7%)、VPN機器経由の侵入(55%)
IAM最小権限の徹底、過剰権限の棚卸し、フィッシング耐性MFAの展開。AIエージェントにも最小権限を適用するID・認証関連(34.5%)、リモートデスクトップ経由の侵入(31%)
多層防御の再設計単一の対策に依存しない設計、egressフィルタリング、継続的モニタリング一つの防御が破られた後の検知と、情報持ち出しの抑止

上記「日本の最近の事故では何が狙われているのか」で見た「従来型」の問題は、ほぼこの5領域に収まる。AI時代だからといって特別な対策が先に必要になるわけではない。AIによって増幅されるのは既存の弱点への攻撃であり、だからこそ基本対策の価値はむしろ高まっている。

第2層:ゼロトラスト :  侵入されても到達させない

基本対策を講じても、脆弱性悪用 → 侵入、あるいは認証情報窃取 → 正規アカウントによる侵入そのものを完全になくすことは難しい。したがって、「侵入させない」だけではなく「侵入されても重要資産まで到達させない」設計が重要になる。

ここでZero Trustの考え方が生きてくる。プロテクトサーフェスを明確にし、Identity、Device、Network、Application、Dataを継続的に評価し、最小権限を適用する。さらにマイクロセグメンテーションなどによって、侵害されたアカウントや端末から重要資産への横展開を抑制する。

シリーズ第2回[4]では、Mythosレディにゼロトラストが有効な理由を説明した。ゼロトラストは攻撃を完全に防ぐ手段ではなく、攻撃の難度を引き上げ、侵入から被害拡大までの時間を引き延ばすことで、人間が対応できる時間を確保する戦略と位置付けられる。攻撃側の時間が短縮されるのであれば、防御側は侵入後の時間を取り戻す設計を持つ必要がある。 委託先やサプライチェーン経由の侵入(19.0%)のように、正規の経路や正規のアカウントが使われる場合にも、アクセスのたびに検証し、到達範囲を限定する設計は有効に働くと思われる。

第3層:VulnOps / CTEM ― 悪用される前に発見し、修復する

ゼロトラストが侵入後の被害を限定する層だとすれば、第3層は侵入される前のExposureを減らす層である。VulnOpsが脆弱性の継続的な発見・優先順位付け・修復を担うのに対し、CTEM(Continuous Threat Exposure Management)は脆弱性だけでなく、設定、権限、攻撃経路などを含むExposure全体を継続的に評価・低減する枠組みである。シリーズ第3回[5]では、この両者をMythosレディの中核に位置付けた。

「毎月スキャンする」「年に数回ペネトレーションテストを実施する」といった周期型の脆弱性管理は、攻撃側に時間がかかることを暗黙の前提としていた。従来型の脆弱性管理は、Find → Patchという考え方になりやすかったが、実際には、すべての脆弱性を直ちに修正することはできない。そこで必要になるのが、継続的な運用である。GartnerのCTEMは、Scoping、Discovery、Prioritization、Validation、Mobilizationの5フェーズで定義されている。次に示すのはその5フェーズそのものではなく、VulnOps / CTEMを実装する際の本ブログでの運用例である[13]。

CVSSだけを見るのではなく、次の点を評価して、修復の優先順位を決める必要がある。

  • 実際にInternetから到達可能なのか
  • 既に悪用されているのか
  • 重要なプロテクトサーフェスにつながっているのか
  • 攻撃経路として成立するのか
  • どの程度の業務影響があるのか

これは、第1層の「パッチ管理の継続化」を、攻撃側の速度に合わせて常時回り続ける運用へ発展させたものと言える。AIによって攻撃側のサイクルが高速化するのであれば、防御側も同じように継続的なサイクルへ移行する必要がある。

まとめ:AI時代に変えるべきなのは防御側の「時間軸」

ここまでを整理すると、2026年に相次いで公表されている日本のセキュリティ事故について、AIが直接的な原因であることを示す証拠は現時点では確認できない。実際に確認できる主要な侵入経路は、脆弱性、Identity、サプライチェーンなど、以前から存在していたものである。

【10/16追記】JPCERT/CCが攻撃者によるAIの利用を確認した後も、この整理は変わらない。確認されたのは、AIを使って既知の脆弱性やAPIの弱点を探し突く行為だったからである[17]。AIが攻撃に使われていることは事実になったが、突かれているのは依然として以前から存在する弱点である。

一方で、AIが攻撃者の能力を増幅し、探索、分析、攻撃コード生成、ソーシャルエンジニアリング、侵入後活動などを高速化・自動化し始めていることも事実である[8][9][11][12]。

したがって、「AIによってサイバー事故が増えた」と単純化するのではなく、「AIによって攻撃側の時間軸が変わり始めている」と捉える方が適切ではないだろうか。そして問題はAIそのものだけではない。攻撃側の時間軸が変わっているにもかかわらず、防御側が、月次スキャン、四半期レビュー、年次リスク評価という従来の時間軸のままでよいのか、という問題である。AI時代のセキュリティ対策で求められているのは、単に「AIを使ったセキュリティ製品」を導入することではない。「Mythosレディ」の3層に沿って言えば、次の3つを同時並行で進めることである。

Mythosレディは、一度到達すれば終わる状態ではない。攻撃側の速度に合わせて適応し続けられる状態を保つことであり、その出発点は、国内事案のデータが示すとおり、基本対策にある。

参考資料

民間調査

[1]デジタルアーツ株式会社「2026年上半期国内セキュリティインシデント集計」2026年7月28日公開

[2]Aioright Technologies株式会社 2026年7〜10月 国内サイバーセキュリティ事案143件の統計分析――攻撃種別・対象・侵入経路の全体像」 2026年10月6日公開

CSAジャパン ブログ(「Mythosレディとは何か」シリーズ)

[3]CSAジャパンブログ「Mythosレディとは何か ~ 機械速度の攻撃時代における組織生存の条件」 2026年5月26日公開

[4]CSAジャパンブログ 「Mythosレディとは何か(続編)~ Mythosレディにゼロトラストが有効な理由」 2026年6月3日公開

[5]CSAジャパンブログ 「Mythosレディとは何か(続編-2)~ VulnOpsとCTEM:継続的脆弱性管理の具体的な実装」 2026年6月5日公開

公的機関・ベンダー一次資料

[6]警察庁「令和7年におけるサイバー空間をめぐる脅威の情勢等について」

[7]Verizon, 2025 Data Breach Investigations Report(公表資料)

[8]Verizon, 2026 Data Breach Investigations Report(公表資料)

[9]IBM X-Force, 2026 Threat Intelligence Index

[10]警察庁「令和7年版 警察白書」第3項 ランサムウェアの情勢

[11]IPA「AIセキュリティ短信」

[12]Google Cloud / Mandiant, M-Trends 2026

[13]Gartner, Strategic Roadmap for Continuous Threat Exposure Management

[14]警察庁「令和8年上半期におけるサイバー空間をめぐる脅威の情勢等について」(2026年9月10日公表)

[15]Gambit Security, AI Agents Are Hacking Online Retailers for $25 a Company(2026年9月22日、暫定報告)

[16]金融庁・日本銀行「フロンティアAIによる脅威変化を踏まえた金融機関等の短期的な対応」に係る要請について(2026年5月22日)

[17]JPCERT/CC Eyes「連続不正アクセス事案の攻撃手法に関する調査」(2026年10月15日)

補足資料

IPA「情報セキュリティ白書2026」

Google Threat Intelligence Group, AI Threat Tracker: From Prompting to Autonomy(2026-09-08)

以上