月別アーカイブ: 2026年9月

ゼロトラスト追補(2) ~ ZTNAだけでは十分でない理由、SASE/SSE・IdPと組み合わせても残る課題

2026年9月28日
ゼロトラストWGリーダー 諸角昌宏

背景

ゼロトラスト実装の5ステップ(NSTACモデル)入門シリーズについての質問で、ZTNAとZTAの違いを詳しく説明してほしいという意見がある。特に、ZTNAの導入ではZTを実現したとは言えないというのはどういうことかという質問が寄せられている。

そこで、本ブログでは、ZTNAだけでは十分でない理由、および、SASE/SSE・IdPと組み合わせても残る課題について掘り下げてみる。

はじめに

Zero Trust Network Access(ZTNA)は、VPNの代替として急速に普及している。「ゼロトラスト実装の5ステップ」シリーズ第3回でも、SDPと並ぶ代表的な実装パターンの一つとして紹介した。しかし、「ZTNAを導入した=ゼロトラストを実現した」という理解は誤解である。

本シリーズが依拠するNSTACの5ステップは、ゼロトラストという抽象的な原則(「決して信頼せず、常に検証する」)を、組織が実際に手を動かして実装していくための、実践的な進め方である。ZTNAやSASE/SSEといった技術は、この5ステップのうち主にステップ3(アーキテクチャの構築)を実現する手段の一つにすぎず、5ステップ全体を代替するものではない。

今回は、ZTNAだけでは十分でない理由を整理し、そのうえでSASE/SSEやIdP(アイデンティティプロバイダー)と組み合わせた場合に何が改善し、何が改善しないのかを検討する。

ZTNAだけでは十分でない理由

ZTNAは、ZTA(ゼロトラストアーキテクチャ)を構成する要素の一つであり、ネットワークアクセス制御に特化した技術カテゴリである。つまりZTNAは、ZTAという大きな設計図の一部分にすぎない。具体的には、次の理由がある。

① 単独では、5本柱を包括的にカバーしない

ZTNAは、CISAのゼロトラスト成熟度モデルにおけるネットワークの柱を中心に、アイデンティティ、デバイス、アプリケーションへのアクセス制御にも関係する。接続を許可するにはユーザーを認証する必要があり、多くの製品はデバイスの状態も判断材料に含め、制御の単位もネットワーク全体ではなくアプリケーション単位である。しかし、ZTNAだけで5本柱および3つの横断的能力(可視化と分析・自動化とオーケストレーション・ガバナンス)を包括的に実現できるわけではない。データの分類・保護や、エンドポイントの詳細な健全性管理などは、別の仕組みで補う必要がある。

② 「入口」は絞れても、「入った後」の制御には限界がある

多くのZTNA製品は、接続開始時にユーザー/デバイスを検証して「このアプリへのアクセスを許可するか」を決めることに主眼を置いている。しかし、いったんアクセスが許可された後、そのセッションの中で何が行われるかまでは見ていないことが多い。真のゼロトラストは、一度きりの検証ではなく、継続的な検証を要求している。

③ ラテラルムーブメント(横移動)対策は「軸」によって効き方が違う

従来型VPNでは、接続後のアクセス範囲を適切に制限していない場合、広範なネットワークリソースへの到達が可能となり、横移動のリスクが高まる。一方ZTNAは、アクセス対象をアプリケーション等の単位に限定することで、このリスクを低減する。常に検証し、最小権限による制御を前提とする設計であることも、この違いを支えている。

ただし、ここには以下の2つの異なる軸がある。

軸何の話かZTNAの役割
A:ユーザー→アプリの横移動(VPN文脈)アクセス範囲が適切に制限されていない場合、リモートユーザーが広範なネットワークリソースに到達できてしまう問題ZTNAはアクセス対象をアプリ単位に限定し、このリスクを低減する
B:サーバー・ワークロード間の横移動(マイクロセグメンテーション文脈)攻撃者がいったん社内の1台に侵入した後、サーバー間・サービス間を東西(east-west)に動き回る問題ZTNAは通常ここまでは踏み込まない。別の技術(マイクロセグメンテーション)の役割である

表1:ZTNAが効く横移動と、効かない横移動

Target社の事件では、外部委託先の認証情報を悪用した侵入後、内部ネットワークでの横移動が発生した。本ブログでの分類では、特に軸Bに相当する問題を示す事例である。

④ 非人間アイデンティティへの対応が弱い

多くのZTNA製品は、人間のユーザーがアプリにアクセスする場面を想定して設計されており、サービスアカウントやAPI、ワークロード間の通信、AIエージェントのような非人間の主体に対するコントロールは、そのままでは不十分なことが多い。「Whoには人だけでなく非人間も含める」という、シリーズ第4回で説明した原則が、ZTNA単体では十分にカバーしきれない領域である。

⑤ 通信内容の脅威検査は、別の機能に委ねられる

アクセス制御を主機能とするZTNAは、マルウェアやゼロデイ攻撃を通信内容から検出・防御すること自体を主目的としていない。こうした脅威に対応するには、ZTNAと連携する脅威検査機能やエンドポイント保護等が必要になる。

⑥ 5ステップで言えば「ステップ3の一部」にすぎない

ZTNAは、5ステップのうちステップ3(アーキテクチャの構築)で選べる実装パターンの一つにすぎない。ZTNAをどれだけ高度に導入しても、プロテクトサーフェスの定義(ステップ1)を飛ばしていれば何を守るべきか曖昧なままであり、トランザクションフローのマッピング(ステップ2)がなければポリシーの中身がスカスカになり、監視と保守(ステップ5)がなければ時間とともにポリシーが陳腐化する。ZTNAという「箱」を導入しただけでは、その中身(ポリシー、プロテクトサーフェスの定義、継続的な運用)が伴わなければ機能しない。

ZTNAとIdPを組み合わせるとどうなるか

ZTNAの限界を踏まえると、「IdP(アイデンティティプロバイダー)と組み合わせればどうか」という発想が浮かぶ。これは第3回で説明した「ZTNAという枠組みに、IdPをデータソースとして接続する」という構成そのものであり、実務でも広く行われている。

ただし、ここで前提を一つ補足しておきたい。ZTNAをSSEやSASEの構成要素として提供するベンダーが存在し、SWGやCASB等との統合が進められている。SASE(Secure Access Service Edge)は、SD-WAN等のネットワーク機能とクラウド提供型のセキュリティ機能を統合するアーキテクチャである。一方、SSE(Security Service Edge)は、SASEのセキュリティ機能部分に相当し、ZTNA、SWG、CASB等を中心に構成される。ZTNAは、このSSEに含まれる機能の一つにすぎない。なお「ZTNA 2.0」は、SASEやSSEという製品カテゴリを指す言葉ではなく、ZTNAという機能自体を、継続的検証やインライン脅威検査まで含めてより高度に実装したものを指す、ベンダー側の呼称である。三者は並列の同義語ではなく、ZTNAはSASE/SSEを構成する機能の一つである。ZTNA 2.0は、そのZTNA機能を高度化したものを指すベンダー提唱の概念であり、SASE/SSEの実装に組み込まれる場合がある。

こうした統合が進むベンダーの構成を踏まえ、以下では「ZTNA単体+IdP」ではなく、「SASE/SSE+IdP」という組み合わせで、先の課題がどこまで解消するかを見直してみる。結論から言えば、かなり改善するが、埋まらない穴は変わらず残ると考えられる。

ZTNA単体の課題
ZTNA単体の課題SASE/SSE + IdP改善の程度(構成条件による)
① 5本柱を単独では包括的にカバーしないアイデンティティの柱をIdPが補強し、SASE/SSEはネットワーク以外の柱にも機能を広げる○
② 接続時の検証だけで、その後は見ないIdPとSASE/SSEの連携により、リスク変化の検出と接続後のコントロールを強化できる。ただし、実現範囲は製品・構成に依存する◎
③-A ユーザーの横移動(VPN文脈)ZTNAによるアプリケーション単位のアクセス制御により、広範なネットワーク到達に伴う横移動リスクを低減する◎
③-B サーバー・ワークロード間の横移動マイクロセグメンテーションはSASE/SSEとは別の機能・製品として提供される場合があり、別途対応が必要となることがある△
④ 非人間アイデンティティに弱いIdP側の対応範囲拡大に加え、SASE/SSE側も進みつつあるが発展途上△
⑤ 通信内容の脅威検査は、別の機能に委ねられるSSEに含まれるSWG等の機能が脅威防御を、DLPが機密情報の持ち出し制御を担う。ただし対象通信・構成は製品によって異なる○
⑥ 5ステップのうちステップ3の一部にすぎないステップ4(ポリシー)の判断に利用できる情報が拡充する。ただし、ステップ1・2・5は製品によって支援・自動化できても、組織の責任そのものは代替できない△

表2:ZTNA単体の課題と、SASE/SSE+IdPを組み合わせた場合の改善の程度
凡例:◎=大きく改善する、○=一定程度改善する、△=限定的な改善にとどまる

⑤はかなり埋まる。ただし条件と構成に依存する

SSEに含まれるSWG等の機能により、対応する通信についてマルウェア検査や脅威防御を実施できる。また、DLPによって機密情報の不適切な持ち出しを検出・制御できる。ただし、TLS復号の可否、検査対象となる通信、適用されるセキュリティポリシーは製品や構成によって異なる。これにより、ZTNA単体では扱えなかった「通信内容の脅威検査」は、条件が整えば大きく前進する。

特に注意したいのは、同じベンダーの製品であっても、ZTNAを担うサービスと脅威検査を担うサービスは、別々に設計・提供されていることが多いという点である。両者を連携させる設定を明示的に行わなければ、ZTNA経由の通信が脅威検査を自動的に通るとは限らない。

「SASE/SSEを導入した」だけでは足りず、構成として正しくつなぎ込まれているか、対象通信・ポリシーが意図どおりかの確認が要る。

③-Bは、SASE/SSEに広げても、なお埋まりにくい

一方、マイクロセグメンテーション(サーバー・ワークロード間の横移動対策)は、SASE/SSEとは別の機能・製品として提供される場合があり、導入時には両者の機能範囲や連携状況を確認する必要がある。

つまり、「SASE/SSEまで導入したから安心」という判断は早計であり、Target社事例のような内部の横移動対策は、依然として別の検討が必要である。

特に効くのが②:継続的なリスク評価

これが一番の実質的な進歩である。一部のIdP製品は、認証後もユーザーやセッションのリスク変化を検出・評価する機能を備えている。ただし、リスク評価と既存セッションのコントロールは別の機能である。IdPの評価結果をZTNAやSSEのアクセス制御に反映し、必要に応じて再認証・アクセス制限・セッション終了を実行できるよう、製品間の連携とポリシーを適切に構成する必要がある。こうした連携によって、接続時だけでなく、接続後の状況変化にも対応できる。

これはまさに、第3回で説明したCBAC(コンテキストベースアクセス制御)が目指す「セッション中も継続的に再評価する」という原則を、実装レベルで具体化したものである。

それでも、組織の責任そのものは代替できない

ここが本ブログの核心である。ベンダーがZTNAの機能を、SASE・SSEというプラットフォームや「Zero Trust Platform」といった上位概念に組み込み、どれだけ機能を束ねて上位概念に昇華させても、以下の3点は製品によって支援・自動化できるが、組織の責任そのものは代替できない。

  • プロテクトサーフェスの定義(ステップ1)
  • トランザクションフローのマッピング(ステップ2)
  • 監視と保守(ステップ5)

資産管理ツールやCMDBは棚卸しを助け、フロー可視化ツールはマッピングを助け、SIEMやアクセスレビュー自動化ツールは監視・保守を助ける。しかし、「何を守るべきか」「どこにコントロールを置くべきか」という最終的な判断と責任は、組織にしかできない仕事である。むしろ、ベンダーが機能を統合すればするほど、「それでも組織の責任は残る」という結論が、より際立って正しく見えてくる。

「組織の責任は代替できない」ことで、実際に何が起きるか

ここは、単に「代替できない」と言うだけでは足りない。放置すると、具体的に次の3つの問題が起きる可能性がある。

  1. 高機能な製品を入れても、「何を守るか」を考えていなければ意味がない
    プロテクトサーフェスの定義(ステップ1)を組織自身が行わなければ、何を重点的に保護すべきかが曖昧となり、保護すべき対象がアクセス制御の対象から漏れる可能性がある。また、保護対象に応じた適切なアクセス制御を設計できず、業務への影響を避けるために広すぎるアクセス許可を敷いてしまう場合もある。その結果、高機能なプラットフォームを導入していても、本来守るべき重要な資産が十分に保護されない状態になりかねない。
  2. ポリシーの中身がスカスカになる
    トランザクションフローのマッピング(ステップ2)がなければ、「誰が・どこへ・何のためにアクセスするか」の実態が分からないままポリシーを書くことになる。フローのマッピングはポリシーの“下書き”であり、下書きがなければポリシーは推測や慣習で書かれ、必要なアクセスを誤って止めて業務が止まるか、逆に不要なアクセスを許してしまうことになる。
  3. 導入時は良くても、時間とともに劣化する
    監視と保守(ステップ5)がなければ、業務やシステムが変化してもポリシーは自動では更新されず、ポリシーの腐敗がそのまま進行する。最新のプラットフォームを入れた初日は良い状態でも、1年後には形骸化している、という事態になる。

この問題について以下のよく知られた事件を5ステップの観点から分析し整理してみる。なお、これらは各社の公式な原因発表そのものではなく、5ステップという枠組みに照らして整理した分析である点に留意されたい。

事例関連するステップ何が起きたか
Capital One(2019年)ステップ1、4攻撃者は設定上の脆弱性を悪用して不正アクセスし、過大な権限を持つIAMロールを利用してS3上の情報を取得した。米国約1億人、カナダ約600万人が影響を受けた。保護対象の特定(ステップ1)だけでなく、アクセス権限の最小化と設定管理(ステップ4)の重要性を示す事例と解釈できる
Colonial Pipeline(2021年)ステップ5攻撃者は、当時使用されていなかったものの有効な状態だったVPNアカウントを悪用した。当該レガシーVPNではMFAが適用されていなかった。アカウントのライフサイクル管理、アクセス権限の定期的な見直し、MFA適用という、継続的な運用(ステップ5)の重要性を示す事例と解釈できる
Equifax(2017年)ステップ5既知のApache Strutsの脆弱性に対するパッチ適用が行われていなかった。また、ネットワーク監視に利用する証明書が約19か月間期限切れとなっており、暗号化通信の監視に支障が生じていた。攻撃による侵害は約76日間継続し、約1億4,800万人の個人情報が影響を受けた

表3:組織的な作業の観点から分析した主な事例

いずれも、高度なセキュリティ製品の有無とは別の次元で、組織的な判断・継続的な運用という観点から解釈できる事件である。

一言でいえば、「製品が高機能かどうか」と「その製品が正しく機能するかどうか」は別問題である。SASE/SSEは、正しいポリシーを、正しく強制する道具にすぎない。「何を・なぜ・どのように守るか」という中身は、組織が用意しなければならない。「組織の責任は代替できない」ことの本当の問題は、「良い製品を買えば安心」という誤った安心感を生み、実際にはザルなポリシーのまま運用されてしまうリスクがあるということである。

ZTNAやSASE/SSEは、ZTAにおけるアクセス制御やポリシーの実施を担う技術として利用できる。また、IdPはアイデンティティ情報や認証結果を提供し、アクセス判断を支える。ただし、これらの製品を組み合わせても、組織として何を保護対象とし、どの通信経路にどのようなコントロールを適用するかが自動的に決まるわけではない。第3回で説明したとおり、PEは、組織が定めたポリシーと各種データソースから得られる情報に基づいてアクセスを判断する。しかし、その判断の基礎となる保護対象の定義やアクセス方針を策定する責任は、組織にある。そのポリシーの中身は、プロテクトサーフェスの定義とトランザクションフローの理解に基づいて、業務オーナーとセキュリティ担当が作り込むものであり、これを用意するのは、あくまで組織の仕事である。

さらに、いったん作ったポリシーも、業務やシステムの変化に応じて陳腐化していく。ステップ5の監視と保守、つまりマッピングと実態の突き合わせ、ポリシーの検証と見直しを継続しなければ、どれほど高機能な製品を導入していても、ポリシーはやがて「腐敗」する。ZTNA・IdP・SASE/SSEをはじめ、あらゆる技術的な対策は、この組織的な土台があって初めて意味を持つことになる。

まとめ

SASE/SSE+IdPの組み合わせは、「誰が」という軸(アイデンティティ)と「通信の脅威検査」という軸の両方を大幅に強化し、しかも一度きりでなく継続的に検証できるようにする、という点で非常に理にかなっている。ただし、以下の点はこの組み合わせでも埋まらない。

  • 内部の横移動対策(マイクロセグメンテーション): SASE/SSEだけでは対応範囲が十分でない場合があり、別途の対策を検討する必要がある
  • プロテクトサーフェスの定義・トランザクションフローのマッピング・監視保守という組織的な作業(ステップ1・2・5): 製品によって支援・自動化できるが、組織の責任そのものは代替できない

「SASE/SSE+IdPを入れれば十分」ではなく、「それらは、5ステップの中の“良いパーツ”の一つ」と捉えるのが正確であると考える。ベンダーがZTNAの機能を、SASE/SSEといった上位のプラットフォームに組み込んでも、とりわけステップ1・2・5は、製品の導入では代替できない、組織自身が担うべき中核的な仕事である。ゼロトラストは製品の組み合わせで完成するものではなく、5ステップという手順そのものを、組織として回し続けることで実現される。これは、本シリーズが一貫して伝えてきた考え方に、改めて行き着く結論である。

参考資料

  • Portnox「Why Do ZTNA Solutions Fall Short When It Comes to Zero Trust?」
  • Cato Networks「ZTNA Alone Won’t Win the Zero Trust Race」
  • Palo Alto Networks「What is Zero Trust Network Access (ZTNA) 2.0」
  • Reco AI「Top Zero Trust Security Solution」
  • そのほか、事件に関する公開情報

以上

第6回 CSAジャパン関西支部開発者向け海外最新動向紹介

英国AISI:オープンウェイトAIがサイバー機能の性能差を縮小

2026年8月10日、クラウドセキュリティアライアンス(CSA)は、「英国AISI:オープンウェイトAIがサイバー機能の性能差を縮小」と題するレポートを公開した(関連情報:AISI: Open-Weight Models Close Cyber Capability Gap(https://cloudsecurityalliance.org/artifacts/aisi-open-weight-models-close-cyber-capability-gap))。

[要約]本文書は、英国AIセキュリティ・インスティテュート(AISI)が2026年7月に公表した評価データを基に、オープンウェイトAIモデルとクローズド先端モデルにおけるサイバー攻撃能力の格差が縮小している実態を分析したものである。オープンウェイトモデル(GLM-5.2やDeepSeek V4-Pro等)の攻撃能力は、わずか4〜7ヶ月前のクローズド先端モデル(AnthropicのOpus 4.5/4.6など)と同等水準に達しており、さらに実行コストは大幅に低下している。ベンダ側でのモニタリングや利用制限・アクセスの取り消しが不可能なオープンウェイトモデルの特性上、組織の防御側が対策を講じる猶予が急速に狭まっているため、防御戦略の再構築が必要であると警告している。

・[要点1] オープンウェイトモデルの向上による攻撃能力格差の急速な縮小
・[要点2] 攻撃の実行コストの劇的な低下
・[要点3] 撤回不能なリスクと防御側の猶予時間の短縮

CSAの「英国AISI:オープンウェイトAIがサイバー機能の性能差を縮小」は、以下のような構成になっている。

・主要なキーメッセージ
・背景
・セキュリティ分析
・推奨事項・対策
-即時対応策
-短期的な緩和策
-戦略的検討事項
・CSAリソースとの整合性
・参考文献

主要なキーメッセージ

英国AISIの調査によると、先端オープンウェイトAIモデルのサイバー攻撃能力(脆弱性調査、攻撃実行、リバースエンジニアリング、Web攻撃、暗号解読など)は、クローズド先端モデルとの差が2025年時点の6〜10ヶ月から「4〜7ヶ月」へと急速に縮小している。

オープンウェイトモデルは自前環境でダウンロード・ホストでき、ベンダ側のモニタリングや利用制限を取り除くことが可能である。CSAは、能力差の縮小により、従来は監視・管理された一部のホスト型APIサービス経由でしかアクセスできなかった高度な攻撃機能に対し、企業の防御側が対策を準備するための猶予期間が狭まっていると評価している。

オープンウェイトモデルでの攻撃実行コストは、クローズドモデルに比べて大幅に抑えられます。1億トークン規模の自律攻撃の実行コストは、Anthropicのクローズドモデルが約85米ドルかかるのに対し、GLM-5.2は約46米ドル、DeepSeek V4-Proに至っては約1.19米ドルである。これにより技術的障壁だけでなく経済的障壁も下がり、持続的かつ試行錯誤を繰り返すAI攻撃のリスクがさらに増幅している。

背景

英国AIセキュリティ・インスティテュート(AISI)は、AIのサイバー攻撃能力の進化およびそれが商用ラボからオープンウェイトモデルへと波及する速度を評価・公表している。2026年7月の最新分析では、主要なオープンウェイトモデル(GLM-5.2、DeepSeek V4-Pro、および今後検証予定のKimi K3)を、AnthropicやOpenAIの先端クローズドモデル(Opus 4.5/4.6、GPT-5.3-Codex、GPT-5.5、Mythos Preview等)と直接比較した(関連情報:How Far Behind the Frontier are Leading Open Weight Models on Cyber?(https://www.aisi.gov.uk/blog/how-far-behind-the-frontier-are-leading-open-weight-models-on-cyber))。

評価アプローチとしては、以下の2つを採用している。

・単一技術タスク評価(Narrow Cyber Tasks):脆弱性調査、攻撃実行、リバースエンジニアリング、Web攻撃、暗号など、4段階の難易度にわたる約70の個別課題で構成される。各スキルの成否が明確に判定できるため、AISIはこれをモデル間の比較における「より強力な指標」として扱っている。
・サイバーレンジ評価(Cyber Ranges): 偵察、横移動(ラテラルムーブメント)、権限昇格などの一連の攻撃手順を自律的に連鎖させる多段階攻撃テストである。主に使用された「The Last Ones」は、熟練者でも約20時間を要する32ステップの擬似企業ネットワーク侵入テストである。ただし、長い攻撃チェーン中の1度の成否で結果が大きく変動することや、実環境の動的な防御者が模倣されていないことから、AISIは単一タスク評価よりも比較の証拠力としては弱いとしている。

CSAの過去の分析(2025年12月時点)では、オープンソースモデルの能力遅延は4〜8ヶ月と試算されていた。しかし今回の2026年7月の比較により、具体的なモデルデータをもってこの格差がさらに縮小していることが裏付けられた。これは、フロンティアAI(クローズド・オープン双方)のサイバー攻撃能力が2024年後半以降「約4.7ヶ月ごとに倍増している」というAISIの継続的トラッキング結果とも一致している。

セキュリティ分析

英国AISIのレポートでは、以下のようなAIツールについて報告している。

中国・GLM-5.2 (Zhipu AI, 2026年6月)
・モデル種別:オープンウェイトモデル
・フロンティアモデルに対する特定タスク能力の遅れ:~4ヶ月(Opus 4.6に到達/同等レベルを達成)
・サイバーレンジ実行コスト(1億トークンあたり):~46米ドル
・高信頼で特定タスクを実行できる最安コスト:個別報告なし

中国・DeepSeek V4-Pro
・モデル種別:オープンウェイトモデル
・フロンティアモデルに対する特定タスク能力の遅れ:~5ヶ月(Opus 4.5に到達/同等レベルを達成)
・サイバーレンジ実行コスト(1億トークンあたり):~1.19米ドル
・高信頼で特定タスクを実行できる最安コスト:~0.28米ドル

米国・Opus 4.6(Anthropic, 2026年2月)
・モデル種別:クローズドモデル
・フロンティアモデルに対する特定タスク能力の遅れ:フロンティア基準点
・サイバーレンジ実行コスト(1億トークンあたり):~85米ドル
・高信頼で特定タスクを実行できる最安コスト:~15.17米ドル

米国・Opus 4.5(Anthropic, 2025年11月)
・モデル種別:クローズドモデル
・フロンティアモデルに対する特定タスク能力の遅れ:オープンウェイトモデル比較時点における基準点。ただし、この基準点自体が、2026年4月以降の最新クローズド・フロンティアモデルから現在は5〜7ヶ月遅れている。
・サイバーレンジ実行コスト(1億トークンあたり):~85米ドル
・高信頼で特定タスクを実行できる最安コスト:個別報告なし

具体的なセキュリティ分析の結果は、以下の通りである。

・「監視・取消不能な環境」への能力の普及:
CSAの評価によれば、オープンウェイトモデルのタイムラグ(機能差)縮小における実質的な脅威は、能力の到達点(最も難易度の高いタスクは依然として最先端のクローズドモデルが優れる)よりも、「監視やアクセス取り消しが不可能な環境下で高度な能力が利用可能になること」にある。
・ガードレールの無効化とガバナンスの限界:
ホスト型のクローズドモデルでは、ベンダが危険な攻撃機能を検知した際に利用制限・監視・公開見送り(例:Anthropicが安全上の理由で「Mythos Preview」の一般公開を見送ったケース)といった制御が可能である。しかし、オープンウェイトモデルでは一度モデル重みが公開されると、以下のような理由からベンダ側の制御レバーが完全に消失する。
-誰でもローカル環境でダウンロード・ホスト・微調整できる。
-モデルに組み込まれた安全フレームワーク(ガードレール)を取り外すことができる。
-ベンダ側からアクセスを取り消したり、ダウンロードされた全コピーの脱獄(ジェイルブレイク)を修正したり、利用状況をモニタリングしたりすることが不可能。
-たとえば、DeepSeek V4-Proはリバースエンジニアリングタスクで拒絶反応を示したものの、試行を繰り返すことでバイパス可能であり、サーバー側の監視を伴わない安全対策がいかに脆いかを裏付けている。
・コスト格差によるリスクの増幅:
機能差の縮小に加えて、圧倒的なコスト差がこの危険性を増幅させている。単一タスク評価において、信頼できる最低実行コストは「Opus 4.6」がタスクあたり約15.17米ドルかかるのに対し、「DeepSeek V4-Pro」は約0.28米ドルと桁違いに安価である。この劇的なコスト低下により、安価かつ制御不能な形で高度なサイバー攻撃が試行・反復されるリスクが高まっている。

推奨事項・対策

【即時対応策】

セキュリティチームは、以下のような3つのアクションを即座に採るべきである。

・攻撃能力に関する認識のアップデート:
現在利用可能なオープンウェイトモデル(GLM-5.2、DeepSeek V4-Pro、およびその上位モデル)は、わずか4〜7ヶ月前のクローズド先端モデルと同等水準のサイバー攻撃能力を持つと想定すべきである。「オープンモデルのツールは攻撃者が利用可能な最先端技術より大きく遅れている」という前提は捨てる必要がある。
・脅威モデルの改定:
「このような高度能力を持つのは一部の先端AIラボのみである」という前提で構築された従来の脅威モデルは見直しが必要である。自前で大規模モデルをホストできる十分なリソースを持った攻撃者であれば、ベンダの監視や利用制限を受けずに、すでに同等(または近いうちに同等となる)能力を自由に行使できると想定しなければならない。
・攻撃コストと実行スピードの再評価:
脆弱性管理や攻撃対象領域管理プログラムを運用する組織は、従来の高度なホスト型APIの割高なコストではなく、AISIが試算したDeepSeek V4-Proのような「タスクあたり1米ドル未満」という低コストを前提に、攻撃者の試行スピードやコスト効率の想定を再計算・再評価する必要がある。

【短期的な緩和策】

・監視・制御不能な自前環境(セルフホスト)前提への更新:
検知および脆弱性管理プログラムは、「AI攻撃の実行にはベンダによる監視や制御が可能なホスト型サービスが必要である」という従来の前提を捨て、ベンダが観察・帯域制限・後からのパッチ当てを一切行えない「セルフホストされたオープンウェイトモデル」の利用を考慮した内容に更新する必要がある。
・行動ベース検知への優先シフト:
既知のAPI利用パターンやIPアドレス範囲に依存したインジケーター型検知では、自前のインフラ上でオープンウェイトモデルを運用する攻撃者を検知できない。そのため、検出エンジニアリングにおいては「どのAIサービスが使われたか」の特定ではなく、偵察・横移動(ラテラルムーブメント)・攻撃実行パターンといった「攻撃行動そのもの」の特定を優先すべきである。
・脆弱性修正SLA(対応期限)の再評価:
特定ベンダの環境外で再現可能となった「AI支援型攻撃の極めて低いコストと短い実行時間」を踏まえ、脆弱性管理チームは脆弱性の修復・対処にかかるSLAを再点検・改定する必要がある。

【戦略的検討事項】

・ライセンス形態ではなく「モデルの実際の能力」に基づくリスク評価:
社内ツールに組み込むオープンウェイトモデルを含め、サードパーティ製AIシステムを調達・評価する企業は、「オープンウェイトだからリスクが低い(あるいはクローズドだから高い)」といったライセンス形態でリスクを判断するのではなく、能力ベースのリスク評価を適用すべきである。ライセンスに関わらず「モデルがサイバータスクで実際に何を実行できるか」を階層的に評価するガバナンスアプローチ(能力別ガバナンス)こそが、オープンモデルが攻撃に直結する重要タスクで先端クローズドモデルの数ヶ月遅れにまで迫っているという現実(AISIのデータ)に適合している。
・継続的なタイムラグ縮小を前提とした長期計画の構築:
オープンとクローズドの差が縮まっているのは一過性の追いつきではなく「継続的なトレンド」であることをAISIのデータは示している。セキュリティおよびリスク管理チームは、この格差が縮小し続けることを数カ年計画に組み込む必要がある。「オープンモデルとクローズドモデルの間には持続的な能力の壁が存在する」という前提に立った防御投資は見直しが必要であり、AISIが再テストを行う6ヶ月間隔と同等のサイクルで定期的な評価・再検討を行うことが求められる。

最後に、「CSAのリソースとの整合性」では、本レポート「AISI:オープンウェイトAIがサイバー機能の性能差を縮小」とクラウドセキュリティアライアンス(CSA)が提供する各種フレームワークとの相互補完関係について、以下のように説明している。

・攻撃能力の急増と修正サイクルの構造的非対称性:
AIのサイバー攻撃能力は「約4.7ヶ月ごとに倍増」している一方、企業のパッチ適用・修復サイクルは長期化しており、双方の間に構造的な非対称性が生じている。今回のAISIの発表により、この脅威が一部の監視された先端ベンダのホスト型環境にとどまらず、自前環境(セルフホスト)で運用されるオープンウェイトモデルへも波及していることが示された。自前運用の攻撃者はベンダ側のテレメトリ(ログ)を残さないため、脆弱性管理のSLO(サービスレベル目標)の再設定や、行動ベース検知への優先シフトが不可欠である。
・ベンダの安全性主張への過信防止と政府由来トレンドの活用:
CSAの過去のガイドライン(「AIコントロール・マトリックス(AICM v1.1)」(関連情報:AI Controls Matrix v1.1(https://cloudsecurityalliance.org/artifacts/ai-controls-matrix-v1-1))や「エージェント型AIレッドチームガイド」(関連情報:Agentic AI Red Teaming Guide(https://cloudsecurityalliance.org/artifacts/agentic-ai-red-teaming-guide))など)で示された通り、企業はベンダ側の「安全対策(セーフガード)主張」のみに頼るべきではない。ベンダの主張は自社管理下のホスト型環境にしか適用されず、オープンウェイト誘導モデルや自前環境での運用には及ばないため、政府機関等による能力トレンド評価を自社のAI脅威モデルに組み込むことが重要である。
・能力ベース・ガバナンスモデルの限界と対応:
Anthropicが「Mythos Preview」の公開を見送ったような「モデルの実際の能力に基づくガバナンス(Capability-Based Risk Assessment [CBRA])」は、ベンダがアクセスの制御権(ゲート)を保持している場合にのみ有効である。ダウンロード可能なオープンウェイトモデルとして同等の能力が配給された瞬間にこの制御レバーは完全に喪失するため、企業はこのガバナンスモデルの限界を認識し、約6ヶ月周期で縮小する能力ギャップに合わせたリスク評価を継続する必要がある。

CSAジャパン関西支部メンバー
DevSecOps/サーバーレスWGリーダー
笹原英司

ゼロトラスト追補 ~ アタックサーフェスとプロテクトサーフェス

2026年9月25日
ゼロトラストWGリーダー 諸角昌宏

背景

ゼロトラスト実装の5ステップ(NSTACモデル)入門シリーズのプロテクトサーフェスについて、いろいろと質問をいただいている。その中で、John Kindervagの言っている「Protect Surface is much smaller and more knowable than the Attack Surface.(プロテクトサーフェスは、アタックサーフェスよりもはるかに小さく、はるかに把握しやすい。)」 は根拠があるのかという質問が寄せられている。そこで、事例を交えてこれを説明していきたいと考えた。まず、「この内容に該当するような事例があるか」ということになるが、ここでAIに支援を求めたところ、Target社の情報漏えい事件が上がってきた。

はじめに

「ゼロトラスト実装の5ステップ(NSTACモデル)入門」シリーズでは、ゼロトラストの出発点として「アタックサーフェス(攻撃対象領域)ではなく、プロテクトサーフェス(保護対象領域)に焦点を絞る」という考え方を紹介してきた。しかし「アタックサーフェスが広すぎて把握しきれない」という説明は、ともすれば抽象的に響いてしまう。

本ブログでは、この点を示す実例として、2013年に発生したTarget社の大規模情報漏えい事件を取り上げる。この事件は、セキュリティ業界で最も広く分析されてきた事例の一つであり、アタックサーフェスの広さと、プロテクトサーフェスを正しく隔離することの重要性の両方を、同時に教えてくれていると考えている。

Target社の大規模情報漏えい事件 ~ 何が起きたか

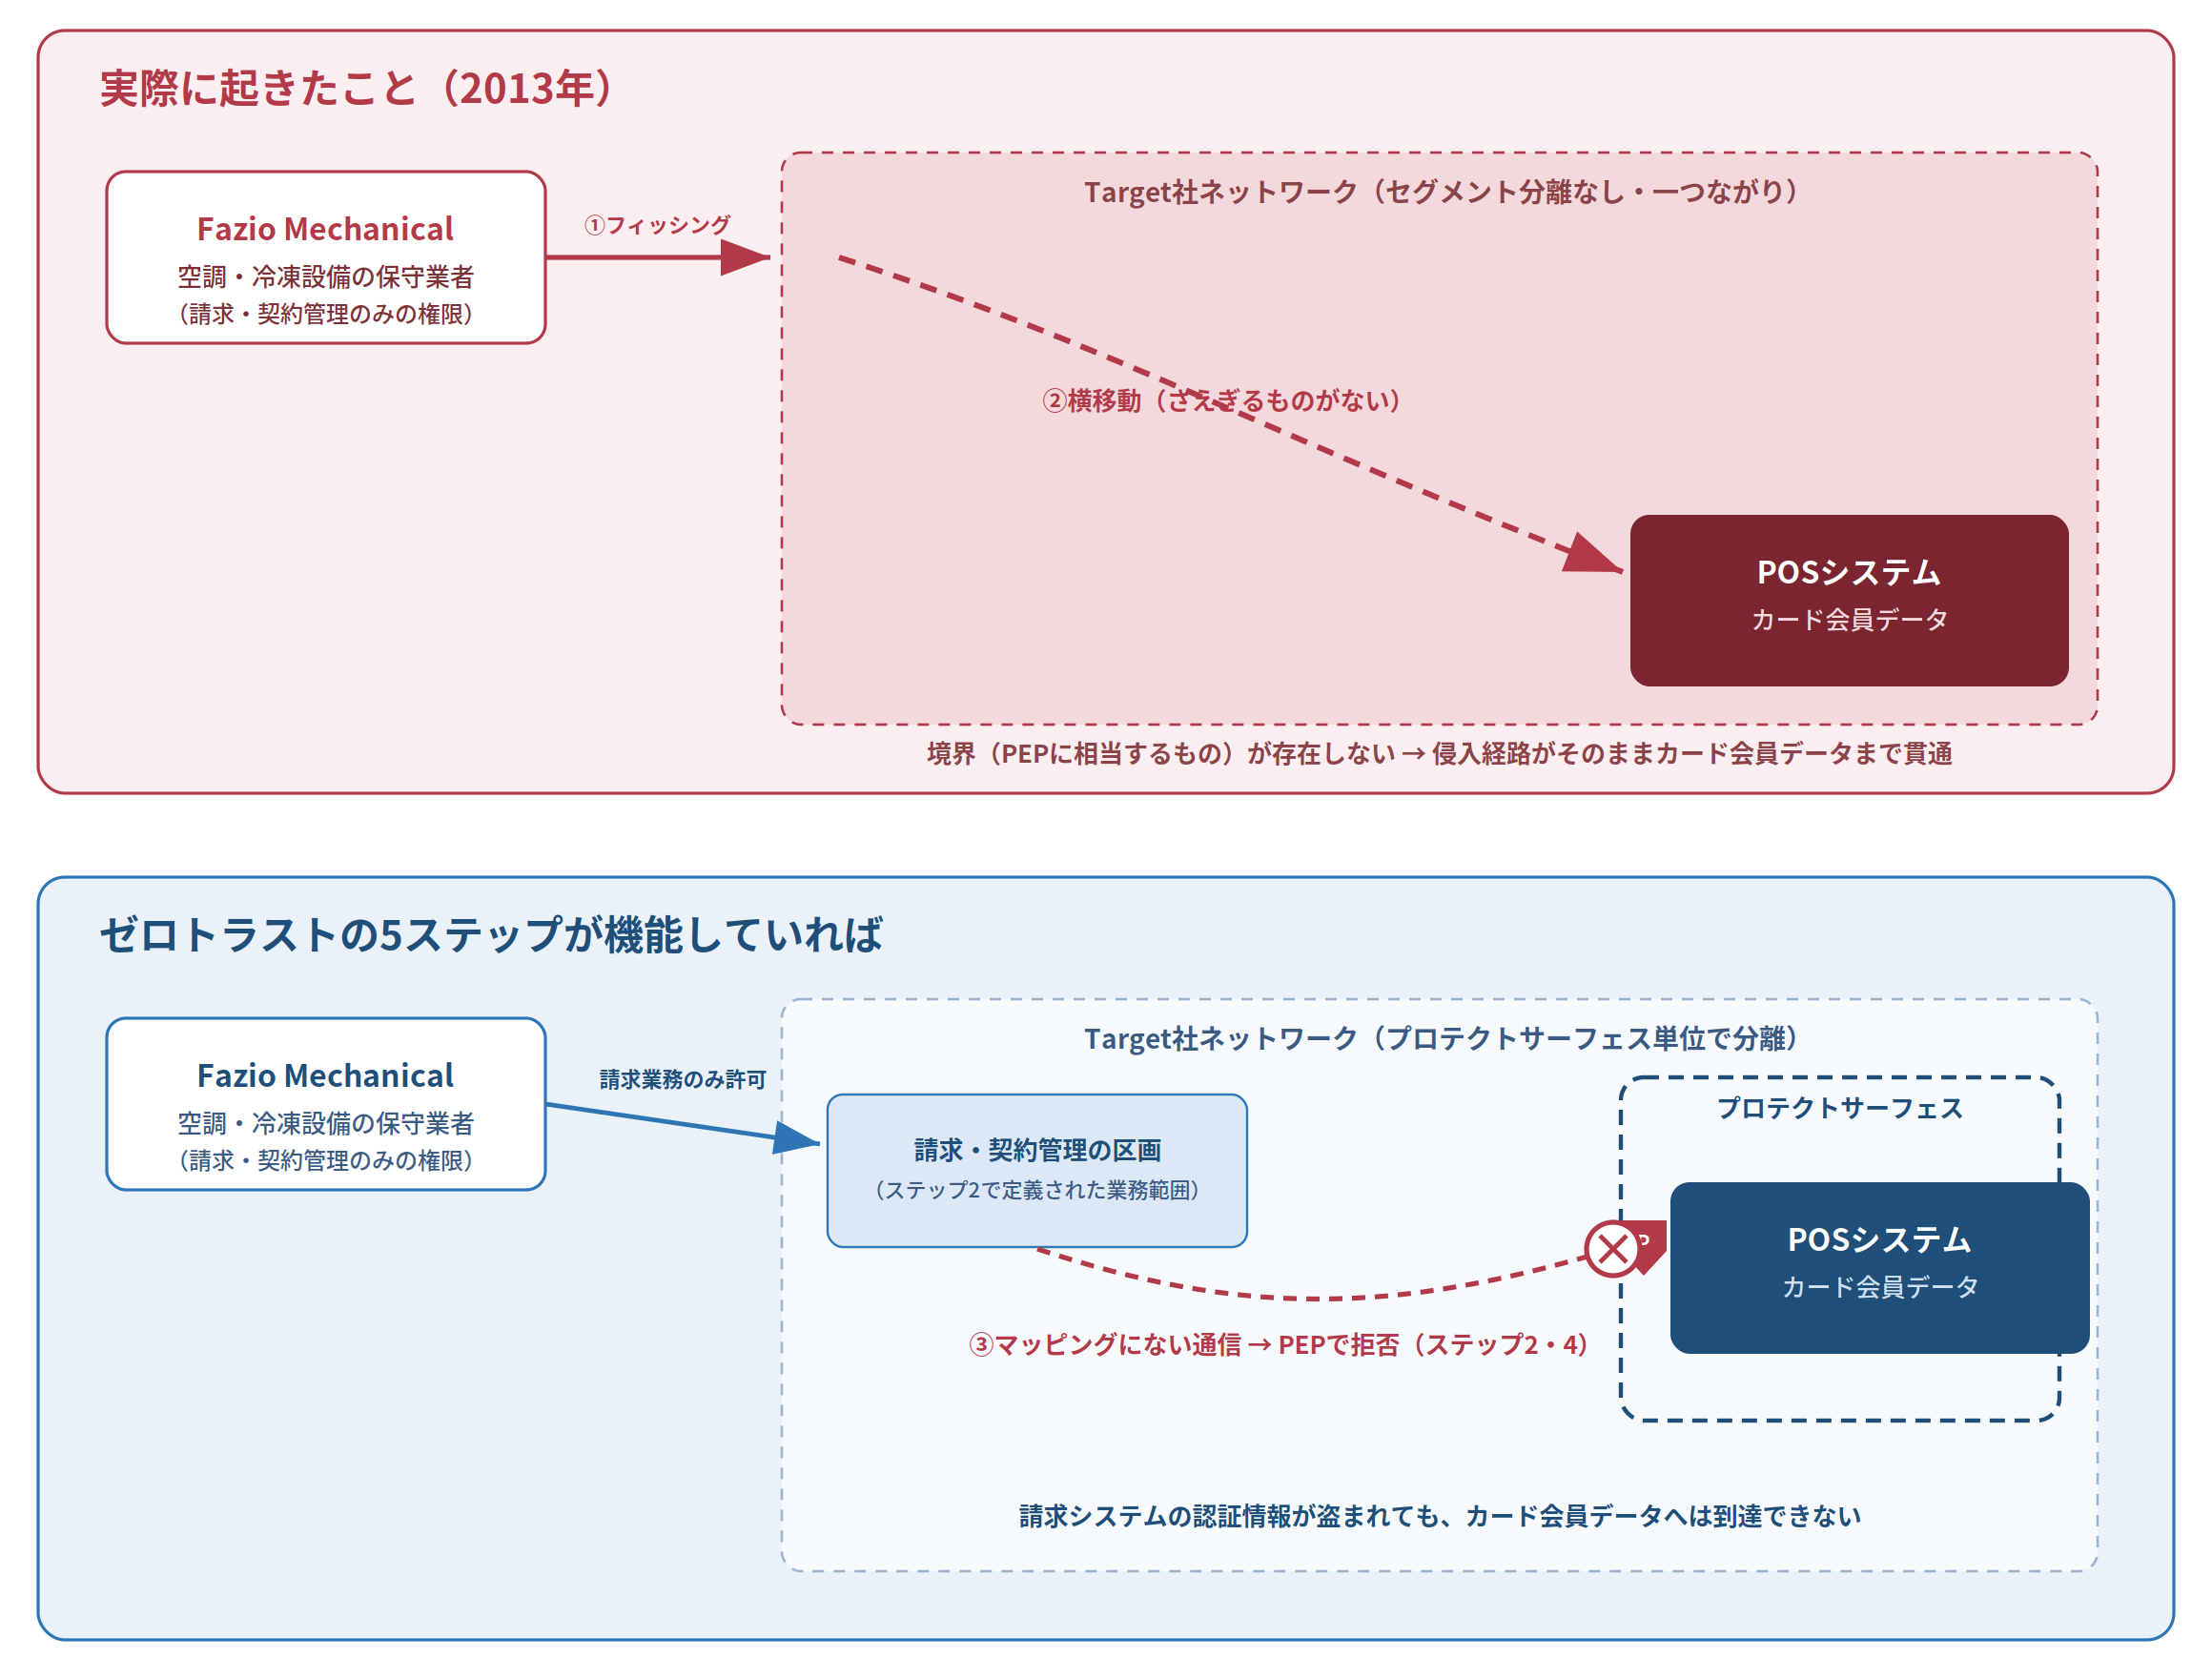
攻撃者は2013年11月15日、空調・冷凍設備の保守を請け負う地方の業者、Fazio Mechanical Services社から盗んだ認証情報を使って、Target社のネットワークに侵入した。Fazio社は、電子請求書の提出・契約管理・プロジェクト管理のためだけに、Target社のシステムへリモートアクセスできる契約だった。捜査関係者の話として、攻撃者はFazio社の従業員にフィッシングメールを送り、その認証情報を窃取したと報じられている(なお、これはTarget社・Fazio社の双方から公式に表明された確定した手口ではないことは述べておく)。

そこを足がかりに、攻撃者はTarget社のネットワーク内を横移動し、全米1,797店舗(後年の報道による)のPOSシステムにまで到達した。Target社がネットワークを適切に分離していなかったため、本来つながっているべきでないシステム同士が結びついてしまっていたことが、被害を広げる決定打となった。

結果として、約4,000万件のカード情報と、最大7,000万人分の個人情報が流出した。被害総額は、報道時期や算定方法によって幅があり、2億ドル超から、2014年時点のアナリスト試算では最大4億2,000万ドルに達するという推計も示されている。

なぜこれが「アタックサーフェスの広さ」の良い例なのか

「クレジットカード情報を守る」と考えるとき、誰も「空調業者の請求システムへのアクセス」を守るべき対象だとは思わない。しかし、実際の侵入口はそこだった。

アタックサーフェスには、こうした「守るべきだと誰も思っていなかった場所」が無数に含まれている。取引先、保守業者、委託先など、業務上必要だからという理由だけで存在する、無数の細い糸がある。そのすべてを事前に洗い出し、守り切ることは事実上不可能である。これが、ゼロトラストが「アタックサーフェス全体を守る」という発想を捨て、「本当に守るべきもの(プロテクトサーフェス)に焦点を絞る」という発想に転換する理由である。

空調業者の請求システムはプロテクトサーフェスにできるのか

ここで一つ、重要な問いが浮かぶ。「空調業者の請求システムも、DAAS(データ・アプリケーション・資産・サービス)として定義すれば、プロテクトサーフェスにできるのではないか」というものである。

答えは「YES」である。契約情報や請求データ(D)、ベンダー用ポータル(A)、それをホストするサーバー(A)、リモートアクセスの仕組み(S)、これらを1つの業務システムとして束ね、プロテクトサーフェスとして定義することは十分可能である。

しかし、これは本質ではない。Target社に本当に必要だったのは、請求システムを守ることではなく、カード会員データというプロテクトサーフェスを、他のすべてから隔離することだった。ゼロトラストは「攻撃者がどこから来るか」を防ぐのではなく、「侵入されても、守るべきプロテクトサーフェスにだけは到達させない」という設計を取る。カード会員データのプロテクトサーフェスが正しく隔離されていれば、攻撃者がアタックサーフェスのどこから侵入しようと、それが空調業者だろうと、他の誰かだろうと、守るべきものには届かない。

トランザクションフローとして、この経路は存在したのか

もう一つ、重要な点がある。「業務上正当なトランザクションフロー」と「実際に存在してしまった経路」は別物であるということである。

Fazio社は、電子請求・契約管理のためだけにアクセス権を持っていた。したがって、カード会員データやPOSシステムとやり取りする業務上の理由は、そもそもない。つまり、もしTarget社がステップ2(トランザクションフローのマッピング)を正しく行っていたら、カード会員データへのフロー図に「空調業者の請求システム」が登場することは、ありえないはずだった。

ところが実際には、ネットワークが適切に分離されていなかったため、マッピング上は存在しないはずの経路が、物理的には通ってしまっていた。これは、ステップ4で説明した「フローにある流れは許可の候補、フローにない流れは原則拒否」という原則が機能していなかった、ということに他ならない。

もしステップ5(監視と保守)で定期的に「定義したフローと、実際に観測されるフロー」を突き合わせていれば、空調業者のセグメントからカード会員データ環境へ到達できる経路が実在すること自体が、「本来ないはずの抜け道」として検知できていたはずである。

図1:実際に起きたことと、ゼロトラストの5ステップが機能していた場合の対比(公開報道を基に作成)

5ステップに当てはめると

この事件を、本シリーズの5ステップに当てはめ直すと、失敗の構造がより明確になる。なお、NSTACの5ステップモデルは2022年に公表されたものであり、2013年の事件当時にTarget社がこの手順を実際に採用していた(あるいは特定の手順が欠けていた)という記録があるわけではない。以下は、起きた事実に、後からゼロトラストの枠組みを当てはめて整理した、筆者による分析である。

ステップこの事件では
ステップ1:プロテクトサーフェスの定義カード会員データという、守るべきプロテクトサーフェスは(おそらく)認識されていた
ステップ2:トランザクションフローのマッピングそこへの正当なフローが厳密にマッピングされていなかった(あるいは、マッピングと実態が一致しているかの検証が甘かった)
ステップ3:アーキテクチャの構築ネットワークが十分に分離されておらず、PEPに相当する「関所」がフローの境界に存在しなかった
ステップ4:ポリシーの作成「フローにない通信は拒否する」というポリシーが、実効的に機能していなかった
ステップ5:監視と保守定義したフローと実態の突き合わせが行われず、抜け道が長期間放置された

表1:Target社の事件を5ステップに当てはめた場合の失敗構造(筆者による整理)

つまりこの事件は、5ステップのどこか一つが欠けたら何が起きるかを、そのまま実証した事例だと言える。

まとめ

Target社の事件が教えてくれるのは、次の2点である。

  • アタックサーフェスは、空調業者の請求システムのように、誰も予想しない場所まで含みうるほど広い。すべてを事前に守り切ることはできないと考える。
  • だからこそ重要なのは、守るべきプロテクトサーフェスを正しく定義し、そこへの正当なフローだけを許可し、それ以外を遮断すること。攻撃者がどこから来るかではなく、どこにも到達させないことに焦点を当てるべきである。

これは、「ゼロトラスト実装の5ステップ」シリーズが第1回から第5回まで一貫して説いてきた考え方、つまり守る対象を定め、流れを可視化し、アーキテクチャで隔離し、ポリシーで許可を絞り、監視で継続的に確かめるというのが、机上の空論ではなく、現実の重大な事件の教訓そのものであることを示している。

以上

中国のAIエージェント規制 ― 概要と意義

2026年9月23日
AIWGメンバー 諸角昌宏

CSAI Foundation/CSA本部が、「China’s AI Agent Regulation Enters Enforcement for Frontier Systems」を公開しました。本ブログでは、このレポートの簡単な概要とそこから読み取れる意味・意義を整理しました。

なお、原文の日本語訳の提供は予定していません。

文書の概要

中国は2026年7月15日、「Implementation Opinions on the Standardized Application and Innovative Development of Intelligent Agents」を施行しました。これは2026年5月8日に国家インターネット情報弁公室(CAC)、国家発展改革委員会(NDRC)、工業情報化部(MIIT)が共同で発布したもので、複数の法律専門家により「世界初のAIエージェント専用の国家規制カテゴリー」と評されています。従来の生成AI規制がコンテンツ(何を生成するか)を対象としていたのに対し、本規制はAIエージェントの意思決定・行動の権限(何をしてよいか)を規律の対象とする点が最大の特徴です。以下、その概要になります。

三層の意思決定権限モデル

規制の中核は、エージェントの自律的な行動を3段階の権限階層に分類し、段階に応じて人間の関与レベルを定める仕組みです。

階層説明代表的な活動人間の関与
レベル1日常的で影響の小さい業務スケジューリング、データ取得、基本的な顧客対応エージェントが自律的に進める
レベル2重要だが可逆的な決定契約内容の変更、価格設定の変更実行前に人間の承認が必要
レベル3影響が大きく、後戻りが困難な決定金融取引、法的文書の執行、安全に関わる制御措置自動化は禁止。人間へのエスカレーションが必須

出典: CSAレポート内で引用されている表を日本語化

適用範囲と域外適用

セクターごとにリスクが区分されており、医療・交通・メディア・公共安全は「高リスク分野」として、公開前の強制的な届出、コンプライアンステスト、リコール義務が課されています。リスクの低い消費者向けアプリケーションは、プラットフォームの自己評価や業界自主規制、信用ベースの執行にゆだねられています。加えて、「膨大なパラメータ規模・大規模ユーザー数・社会動員能力」を持つ汎用大規模モデルや、金融・医療・自動運転など重要インフラに組み込まれた専門モデルには、最も強い規制が留保されています。

適用範囲は中国の国境を越えます。企業の本社所在地に関わらず、エージェントが中国のユーザー・データ・市場運営に接触する組織はすべて対象となり得る、いわゆる域外適用型の規制となります。

CSAによる推奨事項(要約)

  • 即時対応(30〜60日): 中国関連のエージェント展開を棚卸しし、三層モデルに照らして分類。高リスク分野への該当有無、擬人化AI対話サービスへの該当有無、シャドーエージェント(未承認導入)の有無を確認。
  • 短期的対応(1〜2四半期): レベル2・3の意思決定について監査可能なログを整備し、実質的な人間によるオーバーライド機構を制度化。ベンダー契約上の責任分担の見直し。
  • 戦略的対応(6〜12か月): 特定国のコンプライアンスに個別対応するのではなく、アイデンティティ・権限のスコープ化・人間監督・監査ログを備えた、複数法域に対応できる社内エージェントガバナンス体制を構築。

文書の意味・意義

規制の視点の転換:「出力」から「権限」へ

本レポートが最も強調している点は、この規制が従来のAI規制の発想を転換させているということです。これまでの生成AI規制は、ラベル表示・正確性・禁止カテゴリーへの該当性など、AIが「何を生成するか」というコンテンツを対象にしてきました。これに対し、エージェントが行動を決定した後に「何をすることが許されているか」を問うものであり、規律の対象をコンテンツモデレーションの問題から、アイデンティティ・権限付与・監査ログというアクセス制御の問題へと移しています。この転換により、コンプライアンス対応の主体が法務チームからセキュリティチームへと移る、という実務上の帰結も指摘されています。

なぜこの転換が重要か

レポートは、2026年第1四半期だけで主要なエージェント型AIフレームワーク全体で約100件の脆弱性が公開され、資格情報の窃取・データの窃取・不正なツール呼び出しが実際の被害モードとなっていることを指摘しています。攻撃の起点はAIが生成した「中身」ではなく、AIエージェントに与えられていた「権限」そのものであり、この実態が三層の権限モデルによる規律という設計に直結しています。

また、域外適用性と責任の所在の曖昧さも重要な論点です。本社所在地を問わず中国関連のユーザー・データ・市場に接触する組織が対象となるため、多国籍企業は自社が対象に該当するかを法人登記地だけでは判断できません。加えて、権限付与モデルは「文書化された人間の監督」に責任の重心を置くため、ベンダーのエージェントを導入する企業がガバナンス責任を再交渉せずに済ませると、契約上想定していない責任を負うリスクが生じます。

留意事項

  • 原典であるCSAレポート自体が、「AI-assisted Rapid Research」と明記された、AIの支援により作成され正式なレビュー・承認プロセスを経ていない資料です。
  • 実際の法的判断・実務対応に用いる場合は、原典である「実施意見」の条文、および改正サイバーセキュリティ法・擬人化AI対話サービス措置の一次資料、必要に応じて現地弁護士への確認を推奨します。

まとめ

「生成結果」ではなく「権限」で規律するという方向性そのものは、法務関係者、agentic AIを利用する企業、そして中国と取引のある企業にとって、今後の規制動向を占ううえで注視しておく価値のある視点です。

ただし、本資料の評価にあたっては次の2点を踏まえておく必要があります。第一に、本レポートはCSAの公式レビュー・承認プロセスを経ていない、AI支援によるRapid Researchです(冒頭に “This document was generated with AI assistance and has not undergone official CSA review and approval processes.” と明記されている)。第二に、「欧米も同様の方向に向かっている」と断定するには、レポート内で挙げられている根拠がやや弱く、あくまで推測の域を出ません。

とはいえ、規制の発想が「出力」から「権限」へと転換しつつあるという着眼点自体には一定の説得力があり、読み手の立場や用途によっては有意義な参考資料になり得ると考えられます。

以上

第5回 CSAジャパン関西支部開発者向け海外最新動向紹介

EU AI法 第50条「透明性義務」の施行と運用

2026年7月29日、CSAクラウドセキュリティアライアンス(CSA)は、「EU AI法 第50条「透明性義務」の施行と運用」と題するレポートを公開した(関連情報:EU AI Act Article 50: Transparency Obligations Take Effect(https://cloudsecurityalliance.org/artifacts/eu-ai-act-article-50-transparency-obligations-take-effect-2))。

[要約] EU AI法第50条の透明性義務は、他規定の延期(デジタルオムニバス)に関わらず2026年8月2日に予定通り適用された。本条項は対話型AIや合成コンテンツ等の提供者・運用者に開示や電子透かしを義務付けるが、現行技術には透かしの消去や回避といった脆弱性が存在する。そのため企業は、単発のラベル対応にとどまらず、自社AIの棚卸し、技術選定のドキュメント化、標準アイコンの採用、およびCSA AICM等を活用した動的かつ継続的なガバナンス体制の構築を行う必要がある。

・[要点1] 2026年8月2日より適用開始となったEU AI法第50条の透明性義務
・[要点2] 企業は一回限りの対応ではなく継続的な技術評価と文書化が必要
・[要点3] CSA AICMなどを活用した動的なガバナンス体制の構築・運用

CSAの「EU AI法 第50条「透明性義務」の施行と運用」は、以下のような構成になっている。

・主要なキーメッセージ
・背景
-第50条の要求事項
-なぜデジタルオムニバスでこの期限が変更されなかったのか
・セキュリティ分析
-コンプライアンスと技術水準のギャップ
-未解決の検出問題の上に重ねられた規制義務
・推奨事項・対策
-即時対応策
-短期的な緩和策
-戦略的検討事項
・CSAリソースとの整合性
・参考文献

EU AI法第50条が要求する4つの透明性義務

EU AI法第50条は、AIシステムのカテゴリーおよび関係者の役割(プロバイダー(提供者)かデプロイヤー(運用者)か)に応じて、主に4つの独立した透明性義務を規定している。

1.対話型AIシステムのプロバイダー(提供者)に対する義務
・対象:自然人と直接対話することを目的としたAIシステム(チャットボット、音声アシスタント、対話型エージェントなど)。
・要求事項:合理的に十分な情報を持つユーザーに対し、相手がAIシステムとやり取りしていることを理解できるように提示・開示しなければならない。
・例外:ユーザーが置かれた状況や利用の文脈から、AIと対話していることが客観的に明白である場合、および犯罪の検知・予防・捜査のために法律で認可された警察・捜査機関による特定用途。

2.合成コンテンツ(画像・音声・動画・テキスト)生成AIのプロバイダー(提供者)に対する義務
・対象:合成された音声、画像、動画、またはテキストコンテンツを生成するAIシステム。
・要求事項:システムの出力結果(生成物)を、人工的に生成または操作されたものであると検出可能な「機械読取可能なフォーマット(電子透かしやメタデータ)」で標識・マーキングしなければならない。
・技術的要件と柔軟性:条文上、技術的に実現可能な限りにおいて、効果的、相互運用可能、堅牢かつ信頼性の高い技術手段を用いることが求められている。技術自体がまだ発展途上であることを考慮した柔軟性が一定組み込まれている。

3.感情認識・生体情報分類システムのデプロイヤー(運用者)に対する義務
・対象:感情認識システムまたは生体認証分類システムを導入・運用する者。
・要求事項:当該システムの作動に晒される(対象となる)自然人に対し、システムの存在および作動について事前に通知し、適用されるデータ保護法(GDPR等)を遵守しなければならない。

4.ディープフェイクまたは公共の関心事項に関するAIテキストのデプロイヤー(運用者)に対する義務
・対象:実在の人物・イベントに類似したディープフェイク・メディア、または公共の関心事に関して公開・発信されるAI生成テキストを運用・公表する者。
・要求事項:当該コンテンツが人工的に生成・改変されたものであることを明確に提示・開示しなければならない。
・例外:明らかに芸術的・創造的・風刺的・虚構(フィクション)的な作品であって適切に開示されている場合、または責任ある自然人・法人の手による適切な人間の編集プロセス(人によるレビュー)を経たテキストコンテンツ。

なお、全てのカテゴリーにおいて、開示情報は「明確かつ判別可能な方法で、遅くとも最初のやり取りの時点まで」に提示されなければならず、障害者に対するアクセシビリティ要件に準拠している必要がある。

なぜデジタルオムニバスで適用開始期限が変更されなかったのか

2026年5月7日に暫定合意に達し、6月29日に欧州理事会で承認された「デジタルオムニバス」法案では、附属書IIIに該当するスタンドアロン型ハイリスクAIの適用開始期限を2026年8月2日から2027年12月2日へと延期し、附属書Iに該当する製品組み込み型ハイリスクAIに対しては2028年8月までの適用開始とした(関連情報:AI Omnibus enters into force(https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force))。これは標準化団体(CEN-CENELEC)による標準規格の策定遅延に対応するための措置だった。

しかし、第50条の透明性義務はこの延期措置に統合・同梱されなかった。透明性義務は、リスク分類に基づく枠組み(Annex I/III)とは完全に独立して機能する義務であり、AIの機能的性質(対話、生成、感情認識、ディープフェイク)に基づいて発生するためである。多くの企業が「EU AI法の適用が一律に延期された」と誤認して対応を後回しにするリスクが生じているが、実際にはチャットボットやAI執筆支援ツールなど、エンタープライズで最も多用される機能に対する透明性要件が2026年8月2日に予定通り到来したことになる(関連情報:Commission starts enforcing AI Act rules and new transparency requirements on 2 August(https://digital-strategy.ec.europa.eu/en/news/commission-starts-enforcing-ai-act-rules-and-new-transparency-requirements-2-august))。

コンプライアンスと技術水準のギャップの存在

本レポートのEU AI法第50条に係るセキュリティ分析では、最初にコンプライアンスと技術水準のギャップがもたらす課題を取り上げている。

EU AI法第50条は、プロバイダーに対しAI生成コンテンツを機械読取可能な手段で「検出可能」にすることを求めているが、現在のウォーターマーキング(電子透かし)の技術水準は、以下の通り法規定の要求に追いついていないのが現状である。

・テキストにおける攻撃・回避の容易性
-ETH ZurichのSRI Lab(ICML 2024にて発表)の研究では、電子透かしされた言語モデルの公開APIに対してクエリを送信する攻撃者が、透かしスキームをリバースエンジニアリングできることが証明された。これにより、AI生成テキストからウォーターマークを消去したり、人間が書いた文章に偽のウォーターマークを付与したりすることが、50米ドル未満の低いクエリコストで80%以上の成功率で達成可能であると示された(関連情報:Watermark Stealing in Large Language Models(https://files.sri.inf.ethz.ch/website/papers/jovanovic2024watermarkstealing.pdf))。
-ICML 2025で発表された「Self-Information Rewrite Attack」研究では、テキストの質を保つために高エントロピーなトークンにシグナルを埋め込むウォーターマーク手法に対し、それらのトークンを選択的に特定して書き換えることで、意味を保ったままウォーターマークを完全に除去できることが実証された(関連情報:Revealing Weaknesses in Text Watermarking Through Self-Information Rewrite Attacks(https://icml.cc/virtual/2025/poster/44537))。

・画像における脆弱性
-画像領域においても、Googleの「SynthID」電子透かしシステムをリバースエンジニアリングした公開ツールが登場している。この最新バージョンでは、最新のGeminiモデルによって生成された画像からSynthID検出器を回避する加工が施され、人間の目には元の画像と全く区別がつかない出力が作成可能であることが確認されている(関連情報:Reverse Engineered SynthID’s Text Watermarking in Gemini(https://www.reddit.com/r/coolgithubprojects/comments/1qvopfw/reverse_engineered_synthids_text_watermarking_in/))。

・規制遵守上の意味
-第50条が「技術的に実現可能な限りにおいて(as far as this is technically feasible)」という定型句を含んでいることは、ウォーターマーキング技術が未解決の問題であることを法自体が暗黙的に認めていることを示している。
-従って、規制当局は「固定された完璧な標準」ではなく、「変化する技術的ベースライン」に基づいてコンプライアンスを評価することになる。善意で導入した電子透かし技術が数ヶ月後に無効化されるリスクがある中で、どのようなドキュメント化とモニタリングの実務を行えば「法的防衛が可能な姿勢(Defensible Compliance Posture)」を構築できるかが重要な焦点となる。

未解決の検出問題の上に重ねられた規制義務

欧州委員会は、AI法第50条(4)が求める人間が視認可能な開示表示のために、3種類のデザイン(完全AI生成、部分改変、一般的AI関与)からなる「ボランタリー・アイコンセット」を公開した(関連情報:EU Icons for labelling AI-generated content(https://digital-strategy.ec.europa.eu/en/policies/eu-icons-labelling-ai-generated-content))。しかし、これは人間が読む表示レイヤーを解決するのみであり、メタデータの削除、再エンコード、スクリーンショット、あるいは来歴データを保持しないプラットフォーム間での共有によってデータが損なわれた場合の機械読取可能性という根本的な問題を解決するものではない。

さらに、EU域外で開発・生成されたコンテンツが即座にEUユーザーに届く環境下において、域外の事業者に対して第50条を強制する直接的な手立てが乏しいため、EU居住者が直面するディープフェイク脅威の多くは検出側の防御に頼らざるを得ない状況にある。

企業セキュリティチームにとっての最大のポイントは、「第50条の遵守を一回限りのラベル付けプロジェクトとして扱ってはならない」という点である。組織は電子透かしやコンテンツ由来(C2PA等)の技術スタックを、バイパス手法が常に存在する他のセキュリティコントロールと同等に扱い、定期的再評価、公開脆弱性情報の監視、および現在の実装が合理的な技術的努力を反映している旨のドキュメント化を継続的に行う必要がある。

EU AI法 第50条の透明性義務で求められる対応策とは?

【即時対応策】

・AIシステムの一元棚卸し(インベントリ):
-組織内のあらゆる顧客向け・社内向けAIシステムを、第50条の4分類(対話型、合成コンテンツ生成、感情認識/生体分類、ディープフェイク/公共関心テキスト)に照らして再点検する。
・開示と機械読取機構の確認:
-該当するシステムにおいて、遅くとも最初のユーザーインタラクションまでに明確でアクセス可能な開示が表示されているか確認する。
-EUユーザーに届く合成コンテンツに対し、単にプラットフォーム上で利用可能というだけでなく、機械読取可能なマーキング機構(メタデータ、ウォーターマーク、C2PAコンテンツクレデンシャル等)が実際に有効化され、テストされていることを検証する。

【短期的な緩和策】

・欧州委員会の標準アイコンとプレーンテキスト表示の採用:
-行動規範(Code of Practice)の署名企業が視認性やアクセシビリティの基準に合意しているため、標準アイコンおよび分かりやすいテキストラベルを導入することで、規制当局からの実務的ベンチマークを満たしやすくなる。
・「技術的実現可能性」に関する技術選定記録の作成:
-採用したウォーターマーク技術の選定理由や限界を文書化し、単なる形式的なチェックボックスではなく「技術的に実現可能な限りの合理的な努力」を行った証拠を残す。立証責任は企業側にある。
・米国の類似法規制とのインフラ統合
-米国の「TAKE IT DOWN Act」(関連情報:FTC Begins Enforcing the TAKE IT DOWN Act(https://www.ftc.gov/news-events/news/press-releases/2026/05/ftc-begins-enforcing-take-it-down-act))等に対応したコンテンツ識別・削除・来歴管理(C2PA等)の技術インフラが存在する場合、欧州専用に別ラインを構築するのではなく、統合的に拡張して運用効率を高める。

【戦略的検討事項】

・電子透かし技術を「動的なコントロール」として運用:
-ウォーターマーク技術を、一度導入すれば永久に法的要件を満たす静的な機能としてではなく、脅威監視が必要な「動的セキュリティコントロール」として位置付ける。
・ガバナンスフレームワークとの統合(CSA AICM v1.1の活用):
-CSAが提供する「AI Controls Matrix (AICM) v1.1」の透明性・AIアプリケーションセキュリティ管理策に第50条の遵守エビデンス(開示テキスト、マーキング実装記録、技術選定ログ)をマッピングし、監査可能なガバナンス構造を構築する(関連情報:AI Controls Matrix v1.1: Strengthening the Foundation for Trustworthy AI(https://cloudsecurityalliance.org/blog/2026/07/14/ai-controls-matrix-v1-1-strengthening-the-foundation-for-trustworthy-ai))。
・EU AIオフィスの動向監視:
-欧州AIオフィスが策定を進める「検出およびラベル付け基準に関する行動規範(Code of Practice)」の動向を追跡し、「技術的に実現可能」とされる範囲の変化に適時対応する(関連情報:Code of Practice on Transparency of AI-generated Content(https://digital-strategy.ec.europa.eu/en/policies/code-practice-ai-generated-content))。

最後に、「CSAのリソースとの整合性」では、本レポート「EU AI法 第50条「透明性義務」の施行と運用・セキュリティへの影響」とクラウドセキュリティアライアンス(CSA)が提供する各種フレームワークとの相互補完関係について、以下のように説明している。

・デジタルオムニバス分析との連携:
-CSAの過去の研究(デジタルオムニバス再調整に関する分析)は、本レポートの基礎となっており、Annex IIIのハイリスクAI適用開始が2027年12月に延期された一方で、第50条の透明性義務、汎用AI(GPAI)規定、および第5条の禁止行為規制は当初のスケジュール(2026年8月)通り適用されることを明確に指摘していた(関連情報:EU AI Act Digital Omnibus: Enterprise Risk Recalibration(https://labs.cloudsecurityalliance.org/research/csa-research-note-eu-ai-act-digital-omnibus-20260609-csa-sty/))。
・4ヶ月の準備猶予期間(Grace Period)の精度
-デジタルオムニバスがウォーターマーク技術の実装に対してのみ与えた「2026年12月2日までの4ヶ月間の猶予期間」を正しく理解し、対話型システムやデプロイヤー(運用者)側の開示義務自体は2026年8月2日から即時適用されている点に注意する必要がある。
・AICM v1.1によるエビデンス管理
-CSAの「AI Controls Matrix (AICM) v1.1」を活用して、第50条に関する開示文書、技術実装ログ、および意思決定履歴を整理・マッピングすることで、単なる単発の法規制チェックリストにとどまらない、持続可能かつ監査に耐えうるAIガバナンス体制を確立することができる(関連情報:AI Controls Matrix v1.1: Strengthening the Foundation for Trustworthy AI(https://cloudsecurityalliance.org/blog/2026/07/14/ai-controls-matrix-v1-1-strengthening-the-foundation-for-trustworthy-ai))。

なお、欧州委員会のAIオフィスが策定した「生成AIコンテンツの透明性に関する行動規範(関連情報:Code of Practice on Transparency of AI-generated Content(https://digital-strategy.ec.europa.eu/en/policies/code-practice-ai-generated-content))」には、2026年8月2日の第50条施行に先立ち、約190の企業・組織が署名を行っている。

この行動規範は、EU AI法第50条の「合成コンテンツの機械読取可能なマーキング(第50条2項)」および「ディープフェイク等のラベル表示(第50条4項)」の実務的な遵守手順を具体化することを目的とする自主規制フレームワークである。任意参加の仕組みであるが、署名して規範を遵守することにより、各国の市場監視当局に対して「第50条を正しく遵守している」という法的予見性(合規の立証)を得やすくなるメリットがある。署名企業は「署名者タスクフォース(Signatory Taskforces)」に参加し、業界内でのマーキング・ラベル表示の共有や技術運用を進めることになる。

他方、署名を行わない企業であっても第50条の法律上の義務(2026年8月2日発効)自体から免除されるわけではなく、個別に適合性を当局へ証明する必要がある。

CSAジャパン関西支部メンバー
DevSecOps/サーバーレスWGリーダー
笹原英司

ゼロトラスト実装の5ステップ(NSTACモデル)入門(全6回シリーズ)まとめ

シリーズで投稿しました「ゼロトラスト実装の5ステップ(NSTACモデル)入門」、全6回が揃いましたのでここにまとめてリンクを貼ります。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第5回:ステップ5 — 監視と保守

2026年9月4日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回で守る対象(プロテクトサーフェス)を定義し、第2回で流れを可視化し、第3回でアーキテクチャを構築し、第4回でポリシーを作った。これで一通りの実装は終わる。では、なぜまだステップ5「監視と保守」があるのか。答えは、ゼロトラストは「作って終わり」ではないからである。

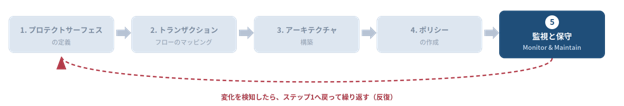
図1:ゼロトラスト導入の5ステップ。ステップ5は、変化を検知したらステップ1へ戻る「反復」の入口でもある

ステップ5には2つの部分がある。監視(モニター):防御が正しく働いているか、異常が起きていないかを継続的に確かめることと、保守(メンテナンス):ポリシーや設定を、変化する環境に合わせて健全に保つことである。以下、順に見ていく。

よくある誤解:ステップ5から始めてはいけない

ステップ5はとかく忘れられがちだが、逆にステップ5から始めてしまう組織も多い。「とにかくログを全部集めて、何か悪いことが起きていないか探す」というやり方、いわゆるMDR的なアプローチである。だが、ログをすべてSIEMやデータレイクに放り込んで、そこから何かを見つけようとするのは骨が折れるうえ、それ自体は“防御”ではない。

MDRは検知と対応(Detection & Response)であって、防御・予防(Prevention)がない。したがって常に後手に回ることが多い。つまり、「侵害されて、どこで何が起きたかは分かったが、すでに侵害されてしまっている」という事態になりやすい。ゼロトラストが目指すのは、侵害はいずれ起きるという前提に立ちながらも、それが実際の被害に広がる前に、できるだけ手前で食い止めることである。まずステップ1〜4で防御を築き、そのうえでステップ5の監視で「まだ健全か、対応が要るか」を確かめる。この順序が肝心である。

監視(モニター)

ゼロトラストの原則の一つに、「すべてのトラフィックを検査し、記録せよ(inspect and log all traffic)」がある。監視が要であることを示す言葉である。プロテクトサーフェスを小さく切り分けたことで、一つひとつについて「いま何が起きているか」という多くの情報(ログ)が得られる。配置したコントロール(ファイアウォールやEDRなど)が、その動作結果を、こちらに知らせてくれるようになる。

ログとイベントは違う

まず、ログとイベントを区別したい。監視で主役になるのはイベントである。

ログイベント
中身見えたことの記録そのものセキュリティ機器が「意味のある出来事」を検知したもの
例IP AがIP Bにアクセス/プロセスが起動/ボタン押下ブルートフォース検知、マルウェア検知、普段と違う国からのログイン、大量アップロード
扱い調査(根本原因の追跡)に使う。全部を長期保存はしない監視の主役。1件ずつ検査する。より長く保持できる

表1:ログとイベントの違い(Threat Talksを基に作成)(注:本ブログで参照しているThreat Talksは、Threat Talks(ON2IT × AMS-IX)の解説動画である)

なお、ここでいう「イベント」は、セキュリティ機器がフィルタして「意味がある」と判定したものを指す(無害な状態変化のログは含まない)。一般的な情報セキュリティの用語では、サービスの起動・停止や設定変更といった無害な状態変化も含めて「イベント」と呼ぶ、より広い使い方をすることが多い。本稿では、そのうち監視の対象として意味を持つものに絞って「イベント」と呼んでいる。

トラフィックのログをすべて7年間も保存する必要はない(保存コストばかりかさむ)。一方、セキュリティ機器が検知したイベントは、1件ずつ確かめる価値がある。ログは、イベントが起きたときに根本原因をたどるための材料として効いてくる。

プロテクトサーフェスの「文脈」を足す

ここでステップ1が効いてくる。ファイアウォールのイベントは、そのままではIPアドレスしか教えてくれない。だが、そのIPが「どのプロテクトサーフェスか」に翻訳できれば、第1回で記録したメタデータ(所有者・重要度・扱うデータ)が結びつき、「Active DirectoryからCRMへのアクセス」といった業務の文脈が見えてくる。

同じイベントでも、文脈が違えば対応が変わる。たとえば「ブルートフォース攻撃をブロックした」という同じイベントでも、インターネットから顧客向けWebへの攻撃ならよくあることでブロック済みなら無視してよいと考えられる。しかし、もしそれが社内のActive Directoryから発生していたら、たとえブロックされていても調査すべきである。すでに誰かが侵入して横移動を試みているのかもしれない(あるいは、サービスアカウントのパスワード期限切れによる誤検知かもしれない)。いずれにせよ、起きてはならないことなので確かめる必要がある。

IoG/IoC/Unknown で振り分ける

では、大量のイベントをどうさばくか。有効なのは、イベントを3つに振り分ける考え方である。文脈を足すことで、この振り分けができる。

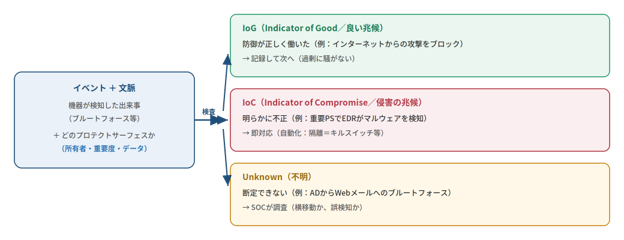
図2:イベントに文脈を足して、IoG/IoC/Unknown に振り分ける(Threat Talks「監視」回を基に作成)

  • IoG(Indicator of Good/良い兆候):防御が正しく働いた合図(例:インターネットからの攻撃をブロック)。記録して次へ行く。
  • IoC(Indicator of Compromise/侵害の兆候):明らかに不正(例:重要なプロテクトサーフェスでEDRがマルウェアを検知)。即対応する。
  • Unknown(不明):断定できないもの(例:ADからWebメールへのブルートフォース)。SOCエンジニアが調査する。

多くのツールは、機器が出す「中身(コンテンツ)」だけを見るため、良い判断が難しい。ゼロトラストは、ここにステップ1の文脈を足せる点が強い。おすすめしたいのは、「ログを全部ためて、その中から怪しいものを拾う」のではなく、機器が出すイベントを1件ずつ、順に検査していくという発想である。コントロールはそれぞれ意味があって置かれているものなので、本来は良いイベントを上げてきてくれるはずである。もし何も上がってこないようなら、ツールの選び方や設定を見直すサインかもしれない。イベントの数は膨大になるため自動化が前提になるが、その自動化を支えるのが、いま述べた文脈「そのイベントがどのプロテクトサーフェスのものか(所有者・重要度・扱うデータ)」という背景情報である。同じイベントでも、文脈があれば振り分けやすくなるが、なければ判断がつきにくい。AIも助けにはなるが、この文脈を与えて初めて、より的確に働いてくれると思われる。

対応の自動化(Rules of Engagement)とキルスイッチ

振り分けの先には、対応の自動化(Rules of Engagement)がある。プロテクトサーフェスの重要度に応じて、どこまで自動で対応するかを決めておく。たとえば、ERPのような重要なプロテクトサーフェスで、EDRがランサムウェアだと判定したプログラムが動き出したら、そのプロテクトサーフェスをネットワークから隔離(キルスイッチ)して影響範囲(ブラスト半径)を抑える。

この隔離は、完全に自動化することも、人が承認する形にすることもできる。確度の高い脅威(明らかなIoC)で、かつランサムウェアのように広がる速度が速いものは、人の判断を待つ時間自体が被害を広げてしまうため、全自動で即座に遮断する運用が現実的である。一方、誤検知の影響が大きい場面などでは、自動化が「これを実行してよいか」という提案だけを整え、SOCが承認ボタンを押して実行する中間形(半自動)も取れる。どちらか一方に決める必要はなく、全自動が不安なら、まず承認を挟む形から始め、信頼度が上がったら段階的に自動化を広げる、という進め方もできる。ただし承認を待つ間にもランサムウェアは広がるため、承認フローを選ぶ場合でも、できるだけ素早く判断できる体制にしておく必要がある。

そして基本姿勢は防御優先(prevention first)である。IPS等は検知モードではなくブロックモードで使う。最良の対応ルールは「防いでブロックする」ことであり、最悪は「侵害されてから原因を探す」ことである。ブロックできたら、その結果をイベントとして受け取り、検査する。

キルスイッチは「セグメンテーションの通信簿」

あるプロテクトサーフェスを丸ごと遮断しようとすると、実はネットワークが十分に分離されておらず、「遮断したらネットワークの半分が止まる」と判明することがある。この予期しない巻き添えの大きさ(ブラスト半径の大きさ)は、次の2つのどちらか、あるいは両方が不十分だったことを教えてくれる。

  • ステップ1:守る対象を、他と混ざらない形で明確に切り分けて定義できていたか(プロテクトサーフェスの境界があいまいなままだと、1つを止めるつもりが他まで巻き込んでしまう)
  • ステップ3:その分離を、設計どおりマイクロセグメンテーションとして実装できていたか(設計は分離のつもりでも、実装が甘いと同じセグメントに相乗りしたままになる)

つまり、「これを止めたら他も止まる」と分かった瞬間は、分けたつもりで実は分かれていなかったことの証拠であり、実地で見落としを発見できる機会でもある。だからキルスイッチの検討は、なぜプロテクトサーフェスをきちんと分けるべきかを組織に示す良い材料にもなる。

保守(メンテナンス)

監視と並ぶもう一つの柱が保守である。作った防御は、放っておくと質が下がっていく。それに抗う仕組みが保守である。主な観点は次のとおりである。

ポリシーの検証

ここでいうポリシーは、いわゆる情報セキュリティ方針のたぐいのものではなく、実際に機器で動いている運用ポリシー、つまりファイアウォールのアクセス規則、EDRの設定などである。とくにファイアウォールでは、新しいアクセスは足されるが、不要になったアクセスは消えずに残りがちである。サーバーを撤去しても何も壊れないので誰も申告せず、「壊すのが怖い」ため規則は何年も放置される。今はネットワークセキュリティポリシー管理(NSPM)ツール(Tufin、AlgoSec、FireMon など)や、ファイアウォール自体に組み込まれた分析機能(例:Palo Alto NetworksのPanoramaが持つセキュリティポリシーオプティマイザ)を使えば、使われていない・重複した規則を検出できるので、変更のたび(少なくとも定期的)に、ポリシーが今も正しいかを点検する。ログが無効になっていないか、EDRでディスク全体をスキャン除外していないか、消し忘れの一時規則がないか、構成管理に近い実際に動いている設定の点検である。

ベンダー更新と“眠っている新機能”

ファイアウォール等は、クラウド経由で自動更新される。シグネチャだけでなく、新機能が配信されることもある。典型的なのは、新しいURLカテゴリ(例:登録されたばかりのドメイン)の追加である。ところがベンダーは、更新で通信を突然止めて障害を出さないよう、新機能を既定で「許可(=素通り)」にして配信することが多い。そのため多くの人が新機能に気づかず、有効化しないまま眠らせてしまう。すでに料金を払っている機能なので、更新のたびに点検し、そのプロテクトサーフェスに使えるものは有効化する。機器を新調したときも、古い設定をそのままコピーせず、新機能を評価し直すことが必要である。

トランザクションフローと実態の突き合わせ

第2回で「どのプロテクトサーフェス同士が通信してよいか」を(業務オーナーの合意のもとで)定義した。運用フェーズでは、定義したフローと、実際に観測されるフローを突き合わせる。定義したのに見えないフローがあれば、ステップ2の誤りか設定ミスを疑う。逆に、定義していないのに流れているフローがあれば、なぜかを調べる。つまり、正当なものか、それとも横移動の兆候かである。ステップ2〜4を正しくやれていれば、本来ここはきれいに一致するはずで、ずれはこれまでの仕事を検算する良い機会になる。

挙動分析(ベースライン)

ここで、監視の節との関係を整理しておきたい。両者は矛盾しているように見えて、実は役割が異なる、補完し合う仕組みである。

  • イベント検査(監視の節):機器が、その場・その1件について「これは意味がある」と判定したものを、その都度チェックする(リアルタイム・1件単位)。ここで人間(SOCエンジニア)が見るのは、あくまで機器が意味づけ・絞り込んだ結果である。
  • 挙動分析:時間をかけて蓄積したログ全体を、機械学習が処理し、統計的な「通常の姿(ベースライン)」を学習して、そこからの逸脱を見つける(蓄積・傾向単位)。ログ全体に目を通すのは機械学習であって、人間ではない。人間が見るのは、やはりベースラインから外れたという判定結果(アラート)だけである。

つまり、「全部のログを人間が精査する」というやり方には、どちらの仕組みでも戻らない。同じログという材料を、機器が1件ずつその場で判定する(イベント検査)か、機械学習が蓄積してから傾向として判定する(挙動分析)かの違いであり、いずれも人間が最終的に目にするのは、絞り込まれた結果だけである。

挙動分析が拾えるのは、単発のイベント検査では見えない、じわじわとした変化や、複数の小さな兆候の積み重ねである。やり方は、ログをXDR(あるいは次世代SIEM・SIEM 2.0とも呼ばれる仕組み)に集約し、機械学習にかける。すると「自分たちの環境では、ふだんこういう挙動が普通だ」という平常時の姿(ベースライン)を学習できる。そのうえで、ベースラインと大きくかけ離れた挙動、つまり普段と違う量・普段と違う相手・普段と違う時間帯のトラフィックなどが現れたら、アラートを上げる。

ただし、誤検知(false positive)が多くなりやすいという弱点も認識しておきたい。たとえば小売業なら、繁忙期(セール・年末商戦など)に通信量が跳ね上がるのは正常な変化だが、対策をしていなければベースラインから外れた「異常」として大量にアラートが出てしまう。同様に、システムの一部がフェイルオーバー(切り替え)しただけでも、普段と違うトラフィックパターンとして検知され、誤検知につながりやすい。

こうした誤検知を抑えるには、季節性やイベントごとの例外をあらかじめ調整しておく必要があり、ある程度の運用の作り込みが求められる。そのため挙動分析は、監視・保守の他の要素(イベントの振り分け、ポリシー検証、フロー突合)が一通り運用に乗ってから取り組む、成熟度の高い最後の一手として位置づけるのが現実的であると考える。

アーキテクチャの変化は「ステップ1へ戻る」合図

クラウド移行、VMからコンテナへ、オンプレのKubernetesからクラウドへ、サービスメッシュのサイドカー廃止など、こうしたアーキテクチャの変化は、可視性を変えてしまう。たとえばサイドカーがあれば見えていた通信が、廃止で見えなくなる。ネットワーク的には分離しているつもりでも、すべてが一つのプラットフォームに集約されれば、もはや分離ではなくなる。

怖いのは、クラウドチームが移行を進め、ネットワークチームが気づかないうちに「見えなくなる」ことである。監視で「これまで見えていた2つのプロテクトサーフェス間の通信が、急に見えなくなった」と気づいたら、それは大きな合図である。こうした変化を検知したら、ステップ1に戻ってやり直す。5ステップは反復であり、ステップ5は次の反復の引き金である。ただし大枠はできているので、多くの場合は所有者や一部のコントロールなど、変わるのはわずかな部分だけである。だからこそ、ゼロトラストの考え方をCISOの上まで含め、組織のあらゆる層に根づかせ、開発者が「クラウドネイティブな機能を使うと、セキュリティに影響するかもしれない」と気づける状態にしておくことが大切になる。

まとめ — そして、また1へ

最終回では、作った防御を健全に保つステップ5を扱った。要点は次のとおりである。

  • ステップ5から始めない。まずステップ1〜4で防御を築く(MDRだけでは常に後手)
  • 監視はイベントが主役。1件ずつ検査し、プロテクトサーフェスの文脈でIoG/IoC/Unknownに振り分ける(自動化+文脈)
  • 対応は自動化(Rules of Engagement)と防御優先。重要なPSはキルスイッチで隔離し、ブラスト半径を抑える
  • 保守で質を保つ:ポリシー検証・眠った新機能の有効化・フローと実態の突き合わせ・挙動分析
  • 大きな変化はステップ1へ戻る合図。5ステップは回り続ける

そして、ここまでの5ステップを、最初から全システムに広げる必要はない。第1回で示した「練習台から本命へ」がここでも効いてくる。まずは重要度の低い1つのプロテクトサーフェスで、定義・可視化・構築・ポリシー・監視保守という一連の流れを小さく回してみる。そこで運用を成熟させ、勘所をつかんでから、優先度の高いシステムへと広げていく。小さく始めて、回しながら育てるのが、5ステップを無理なく定着させる進め方である。

プロテクトサーフェスを定義し(1)、流れを可視化し(2)、アーキテクチャを構築し(3)、ポリシーを作り(4)、監視と保守で守り続ける(5)。そして、環境が変われば、また1に戻る。ゼロトラストは、一度きりのプロジェクトではなく、回し続ける取り組みである。この5ステップという実践的な地図があれば、その歩みを、着実に、そして繰り返し進めていける。全5回(+第1.5回)にわたる本シリーズを、実装の一助としていただければ幸いである。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第4回:ステップ4 ゼロトラストポリシーの作成

2026年9月1日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回で守る対象(プロテクトサーフェス=DAAS)を定義し、第2回でその周りのトランザクションフローを可視化し、第3回でPEP(ポリシー実施ポイント)を配置したアーキテクチャを設計した。配置したPEPは、まだ「何を通し、何を止めるか」というルールを持っていない。そのルールであるゼロトラストポリシーを作るのが、本編のステップ4である。

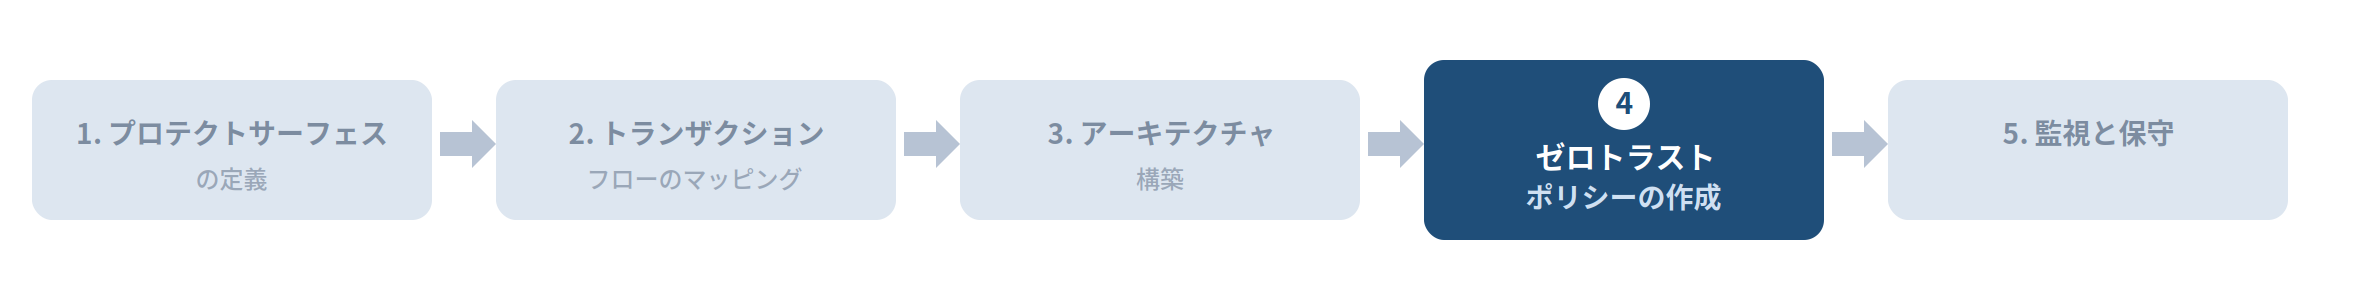
図1:ゼロトラスト導入の5ステップと、本稿が扱うステップ4(CSA文書の5段階プロセスを基に作成)

ステップ4のねらいは、ゼロトラストをアプリケーション層(L7)のポリシー文として具体化することである。第3回のPEPに、このプロテクトサーフェスへ「誰が・何に・どんな条件でアクセスできるか」を、細かい粒度で書き下ろしていく。

ゼロトラストポリシーとは

ゼロトラストポリシーは、セキュアなアーキテクチャの要石(cornerstone)である。ポイントは3つある。1つめは、プロテクトサーフェスにできるだけ近い場所(PEP)で適用すること。2つめは、最小特権・デフォルト拒否で、必要なアクセスだけを明示的に許可し、それ以外はすべて拒否する。3つめは、ポリシーは最初は静的でも、ZTAの成熟に合わせて動的に進化させることである。

また、ゼロトラストポリシーはアプリケーション層(OSI L7)で書く。IPアドレスやポート(L3/L4)だけでなく、「どのアプリの・どの操作を・どのアイデンティティに許すか」というアプリケーションの文脈で表現する点が、従来のファイアウォールルールとの違いである。

もう一つ大切なのが、ポリシーはまずビジネスの視点から出発し、それを技術的なルールに翻訳するという二段構えである点である。たとえば「営業担当は、勤務時間内なら自宅からでもCRMにアクセスしてよい」というのはビジネス上の方針(業務要件)である。これを、ファイアウォールやIdPが実際に強制できる形、つまりユーザーグループ、時間帯、場所の条件に落とし込む。翻訳のしやすさは使うツールに依存する。新しめのファイアウォールならユーザーグループのまま書けるが、古いものではIPアドレスに変換する必要があり、手間が増える。ビジネス要件の定義は業務オーナーが担い、技術ポリシーへの実装は、プロテクトサーフェスがきちんと定義されていれば、セキュリティ担当やSOCが引き受けられる。

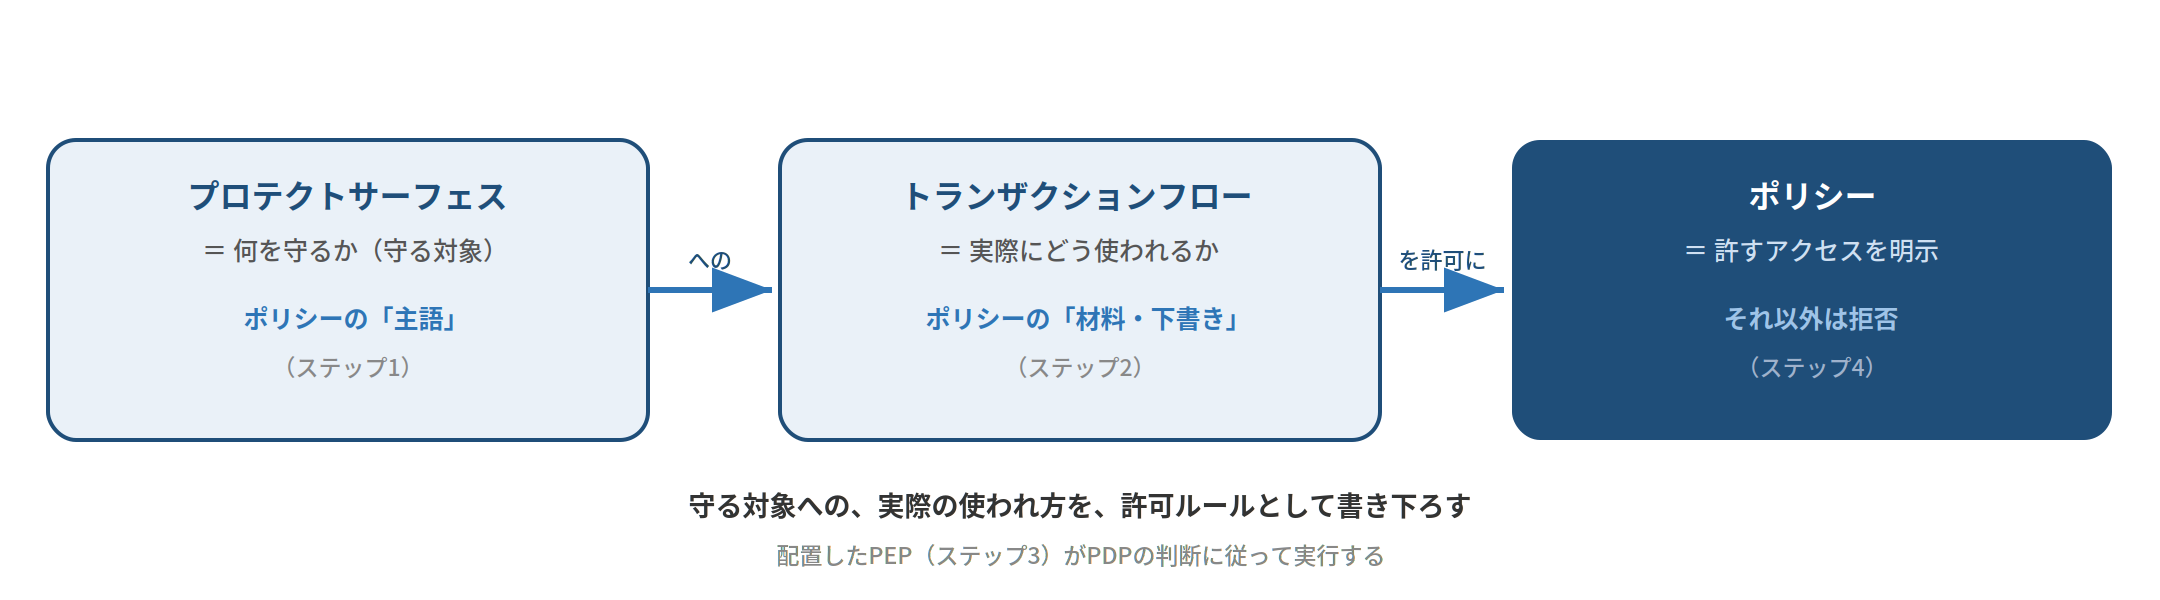
プロテクトサーフェス、トランザクションフロー、ポリシーの関係

ポリシーを書く前に、これまでのステップとの関係を押さえておく。この3つは、次のような連鎖でつながっている。

図2:プロテクトサーフェス、トランザクションフロー、 ポリシー

  • プロテクトサーフェス=ポリシーの「主語」:ポリシーは「このプロテクトサーフェスへ、誰が・何にアクセスできるか」を定める。守る対象(ステップ1)が決まって初めて、ポリシーの主語が決まる。
  • トランザクションフロー=ポリシーの「材料・下書き」:ステップ2で可視化した「実際にどんなアクセスが・どの経路で流れているか」が、そのままポリシーの下書きになる。フローにある流れは許可の候補、フローにない流れは原則拒否する。
  • ポリシー=許すものを明示:フローのうち、業務上正当なものだけをキプリングメソッドで許可として書き下ろし、それ以外はデフォルト拒否とする。

一言でいえば、守る対象(プロテクトサーフェス)への、実際の使われ方(トランザクションフロー)を、ポリシーとして書き下ろす、という関係である。だから、ステップ2のフローのマッピングが甘いと、ステップ4のポリシーも甘くなる。必要なアクセスを漏らして業務を止めるか、余計なアクセスを許してしまう。フローの精度が、そのままポリシーの精度になる。

ここで、ポリシーをめぐる3つの役割を、時間軸で分けて押さえておきたい。ここは混同しやすいところである。

  • 定義する(事前・人間):業務オーナーとセキュリティ担当が、キプリングメソッドでポリシーを作る(ステップ4)。作ったポリシーはPDPに登録しておく。
  • 判断する(実行時・PDP):アクセス要求のたびに、PDPが、その登録済みポリシーに、データソースから得た“今の状況”(本人性・端末状態・リスク等)を照らして、許可/拒否を判断する。
  • 強制する(実行時・PEP):経路上に配置したPEP(ステップ3)が、PDPの判断結果を実行する。

つまり、第3回で「PDPは様々なデータソースから情報を得る」と述べたのは、PDPがポリシーを作っているのではなく、人間が作った登録済みポリシーを評価するために、その場の状況を集めている、という意味である。ポリシーを作るのは人間(ステップ4)、それを状況に照らして判断するのがPDP、判断を強制するのがPEP。この切り分けを押さえると、「PEPがPDPの判断に従って実行する」と「PDPは様々なソースから情報を得る」が、どちらも実行時の同じ動きを指していることが分かる。

キプリングメソッド — 5W1Hでポリシーを書く

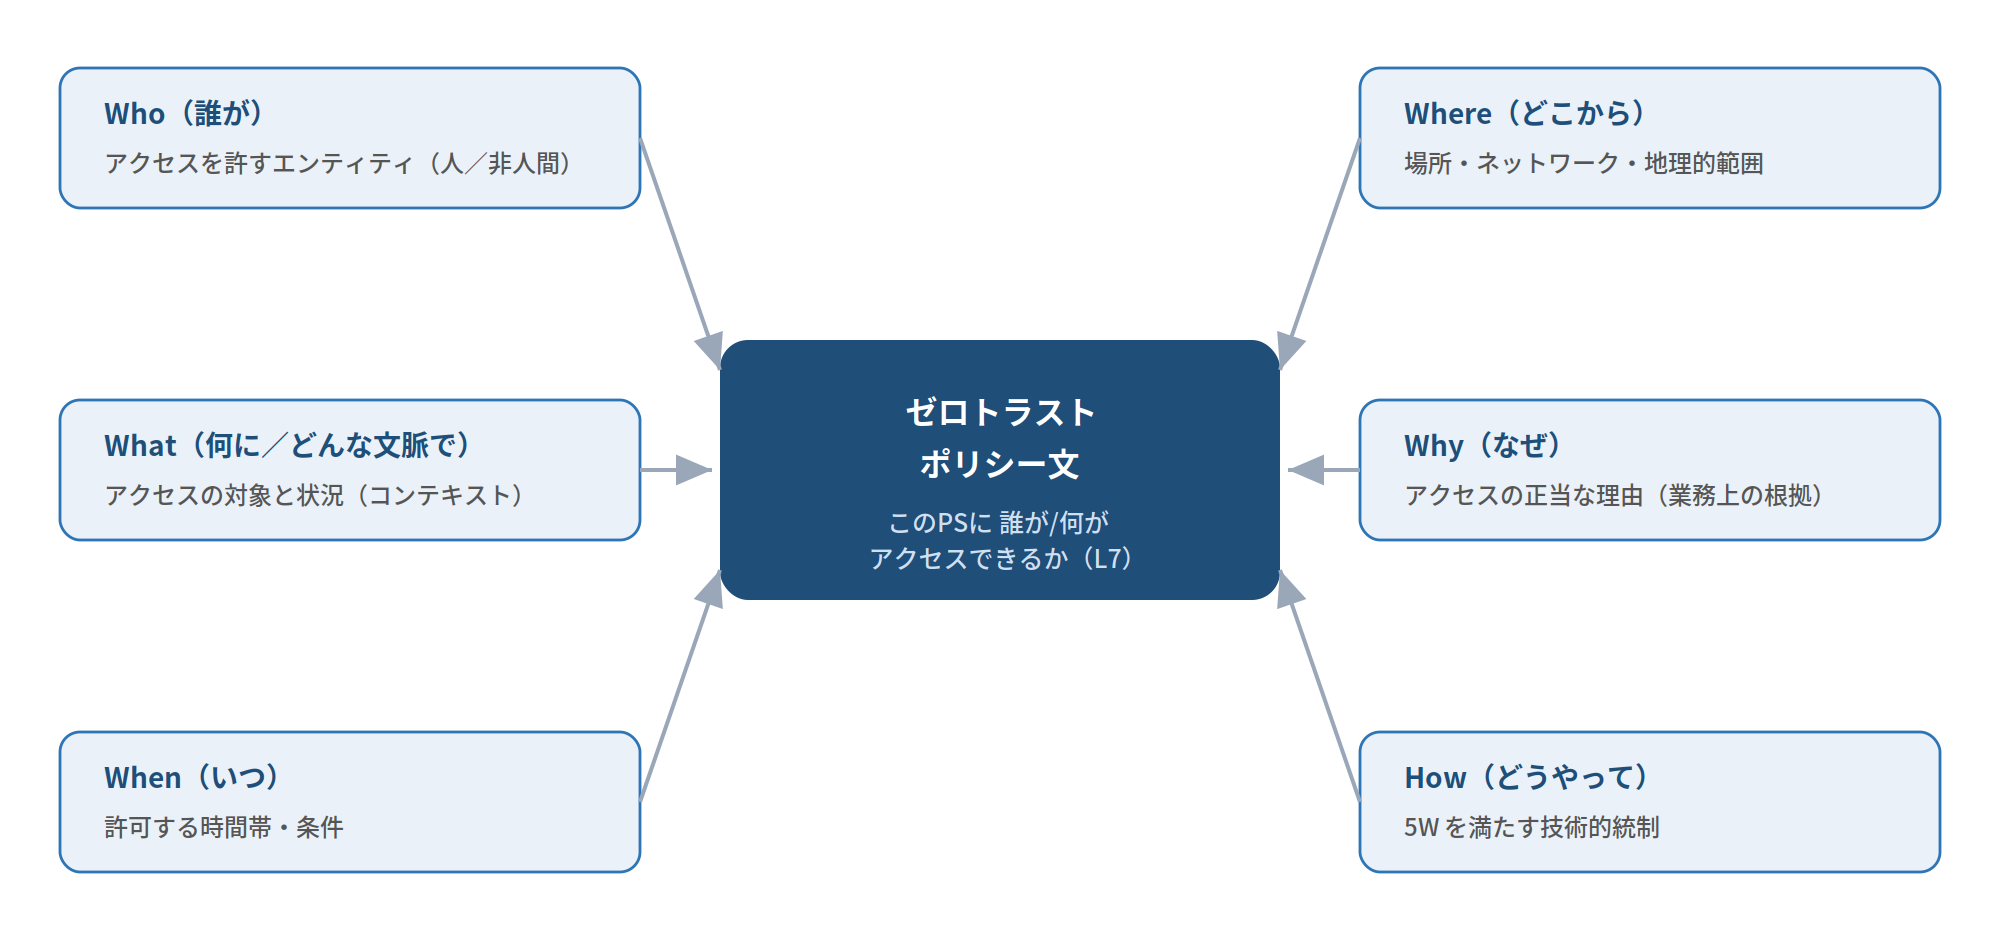
では、ポリシー文はどう書くのか。ここで用いるのがキプリングメソッドである。作家ラドヤード・キプリングの「6人の召使い(Who・What・When・Where・Why・How)」になぞらえた方法で、この6つの問いに答えることで、プロテクトサーフェスへのアクセスを許すべきエンティティを、細かい粒度で定義できる。

図3:キプリングメソッド(5W1H)でゼロトラストポリシー文を組み立てる(CSAのゼロトラスト関連ガイダンスを基に作成)

問い何を決めるか属性の例
Who(誰が)どのエンティティにアクセスを許すか(人・非人間の両方)役割、ユーザー、サービスアカウント、ボット
What(何に)何にアクセスするか/どんな文脈(コンテキスト)でアクセスするか対象リソース、操作、機微度
When(いつ)アクセスを許可する時間帯・条件営業時間、期間、頻度
Where(どこから)許可する場所・ネットワーク・地理的範囲社内/VPN、国・拠点、既知の端末
Why(なぜ)そのエンティティがアクセスする正当な理由(業務上の根拠)業務プロセス、職務上の必要性
How(どうやって)5W を満たすための技術的統制MFA、mTLS、暗号化、最小特権

表1:キプリングメソッドの6つの問い

重要なのは、Whoに人だけでなく非人間(サービス・アプリ・ボット)も含めることである。ゼロトラストでは、ワークロード同士の通信も検証の対象になるため、「決済アプリが会員データにアクセスする」といった非人間のアクセスも、同じ6つの問いで定義する。CSA文書では、これに「どれだけの時間(for how long)」を加えて、アクセスの有効期間まで定めることを勧めている。

具体例:クレジットカードのポリシー文

ここで、ポリシーとPEPの関係を正しく押さえておく。ポリシーは「PEPに対して」ではなく、「プロテクトサーフェスへの各アクセスに対して」作る。そのうえで、判断はPDP(ポリシーエンジン)が行い、経路上のPEPが適用・強制する。つまり流れは「プロテクトサーフェスに対してポリシーを作る → PDPが評価する → PEPが実行する」である。

まず、クレジットカードのプロテクトサーフェスへのアクセスを、キプリングメソッドで2つ書き下ろす。人(引受担当者)と非人間(決済アプリ)の両方を示す。

問い例1:引受担当者 → 引受審査アプリ(人)例2:決済アプリ → カード会員データ(非人間)
Who役割=引受担当者サービスアカウント=決済アプリのワークロード
What引受審査アプリで与信判定を行うカード会員データの該当レコードを読む
When営業時間内取引処理中(都度)
Where社内/VPN・管理端末想定された内部経路(同一PS内)
Why与信審査という業務上の必要決済処理に必要な参照
HowMFA+準拠端末、セッション短時間・再評価mTLS+最小権限(該当レコードのみ)

表2:キプリングメソッドによるポリシー文の例(クレジットカードのプロテクトサーフェス)

例1は「引受担当者が、社内の管理端末から、営業時間内に、与信審査のために、MFA付きで引受審査アプリを使う」という一文に相当する。例2は「決済アプリのワークロードが、取引処理中に、mTLSで、カード会員データの該当レコードだけを読む」という一文である。この条件を満たさないアクセスは、すべて拒否される。

同じ要領で、外部SaaSを使う人(営業担当)と、非人間(ATM)の例も書ける。

問い例3:営業担当 → CRM(人・外部SaaS)例4:ATM → 決済取引(非人間)
Who役割=営業担当登録済みATM(証明書で識別)
What顧客訪問の記録をCRMに登録する現金引き出しの決済取引を実行する
When営業時間内営業時間内
Where自宅可(外出先)だが会社支給端末・SASE経由登録拠点のATM網からのみ
Why訪問記録という業務上の必要利用者の引き出し要求に応じる
HowSASE経由+MFA、CRM側は自社経由のみ許可クライアント証明書+EMV認証、限度内に制限

表3:キプリングメソッドによるポリシー文の例(つづき)

例3の営業担当は、外出先の自宅からでもCRMに記録できるが、会社支給端末でSASE経由に限る。CRM(SaaS)側は自社経由のアクセスだけを通す。例4のATMは、登録拠点・クライアント証明書・EMV認証・限度額という条件で、決済取引だけを許す。人か非人間か、内部か外部SaaSかで、5W1Hの埋め方が変わるのが分かる。

これらのポリシーが、第3回で配置したどのPEPで実行されるかを対応づけると、次のようになる。プロテクトサーフェスへの各アクセス(フロー)に対してポリシーを定義し、その経路上のPEPが適用・強制する、という関係が見て取れる。

プロテクトサーフェスへのアクセス(フロー)ポリシーの要点(許可する条件・それ以外は拒否)適用・強制するPEP
顧客/営業担当 → カードWebアプリ(入口)顧客=MFA+既知デバイス/営業担当=SASE経由・会社支給端末・営業時間内入口のPEP
カードWebアプリ → 引受審査(内部)引受担当者=社内/VPN+管理端末+MFA、営業時間内、与信判定のみアプリ手前のPEP
アプリ → カード会員データ(最重要データの手前)決済アプリのサービスアカウント=mTLS+該当レコードのみ。人間の直接アクセスは拒否データ手前のPEP
引受審査 → 信用調査機関(外部接続)与信照会のトランザクションのみ(想定プロトコル・宛先)外部接続のPEP
ATM → 決済取引(非人間の入口)登録済みATM+クライアント証明書+EMV認証、限度額内ATM経路のPEP

表4:プロテクトサーフェスへの各アクセスに対するポリシーと、それを実行するPEP

たとえば「アプリ → カード会員データ」のフローには、決済アプリのサービスアカウントがmTLSで該当レコードだけを読むというポリシーを定義し、データ手前のPEPがそれを強制する。人間が直接クエリしようとしても、このPEPで拒否される。ポリシーはあくまでプロテクトサーフェス(守る対象)を主語に作り、PEPはその実行場所である、という点がここでも確認できる。

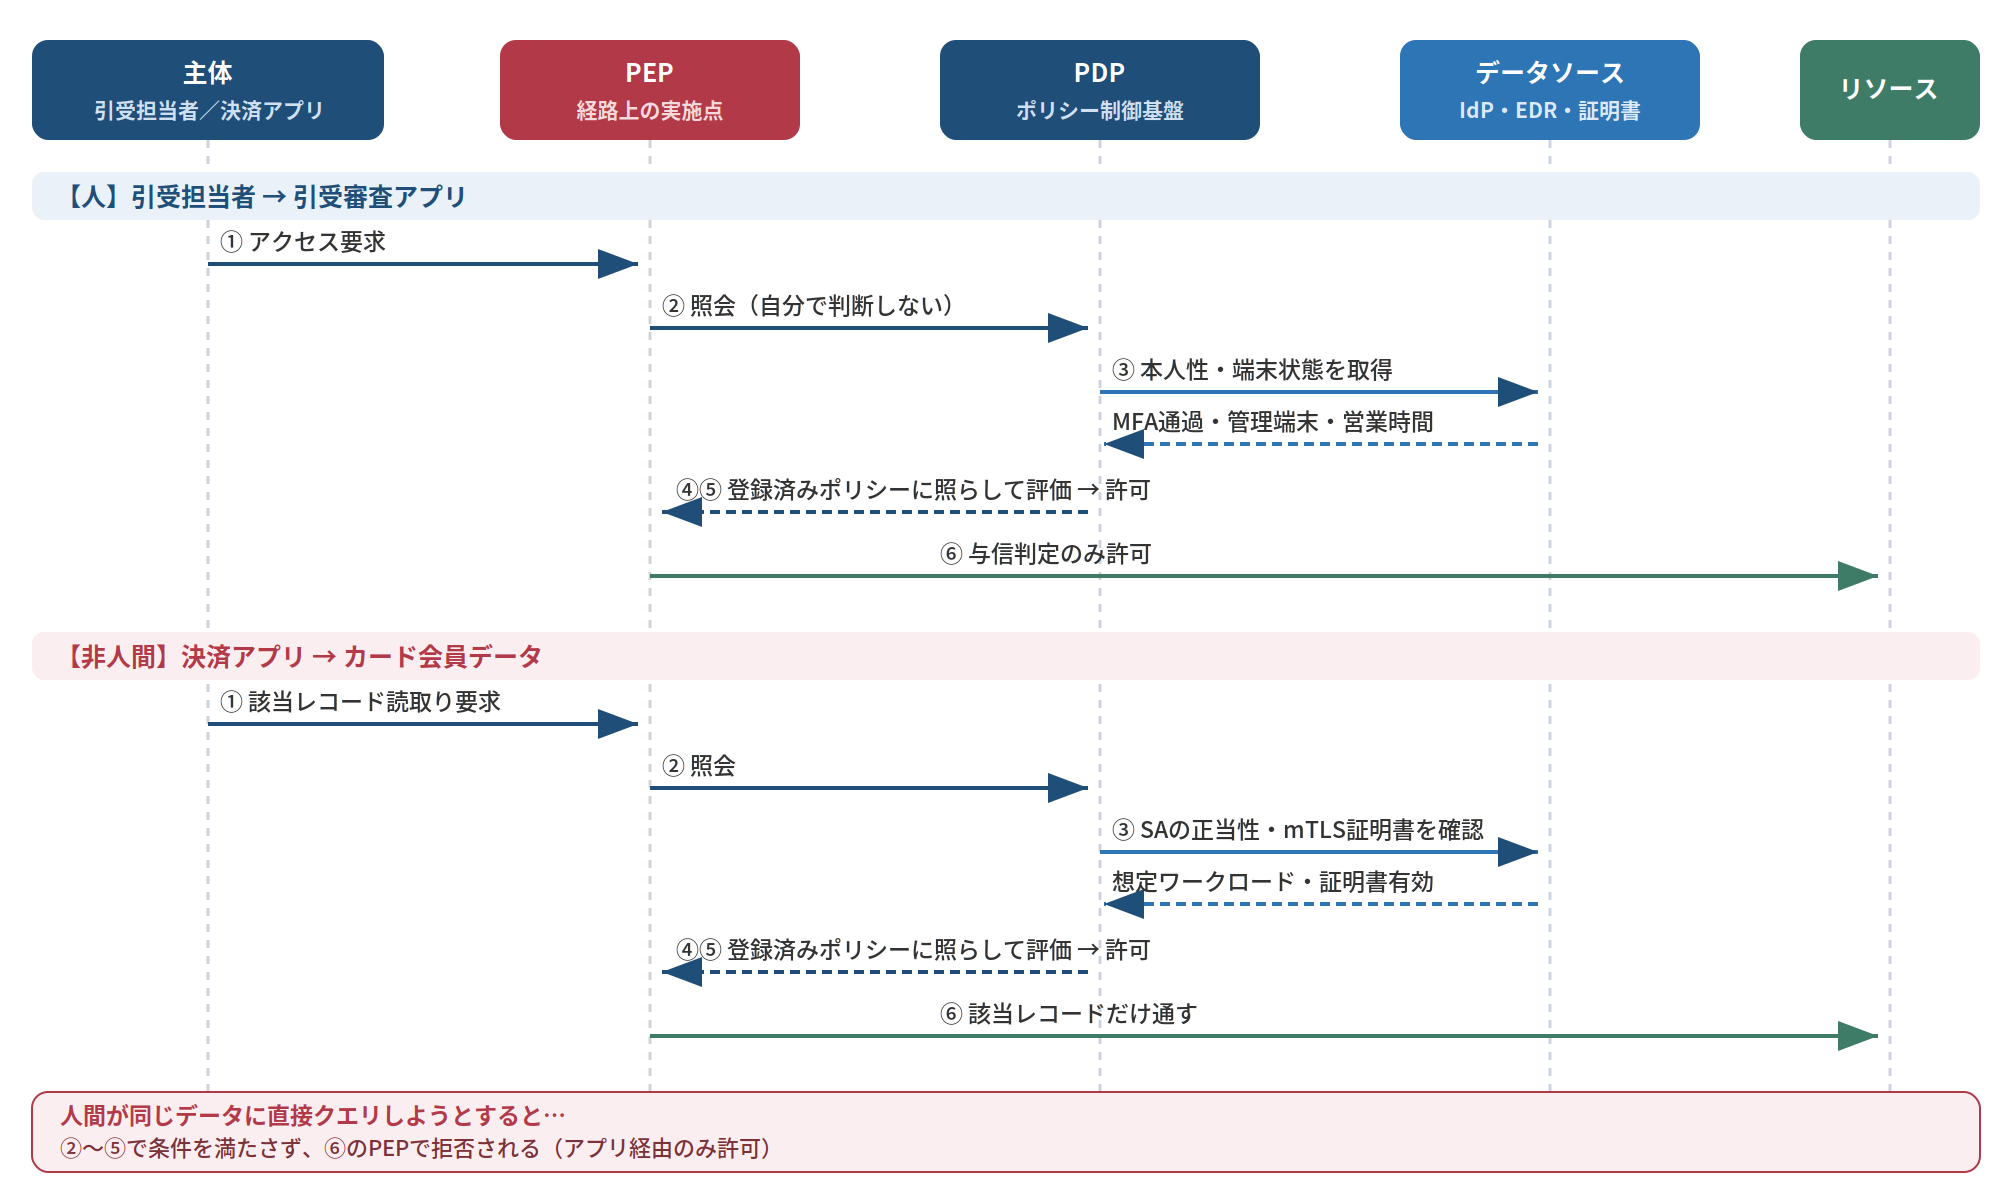
1回のアクセスがどう実行されるか — 人と非人間で追う

「配置したPEPが、PDPの判断に従ってポリシーを実行する」を、実際の1回のアクセスで具体的に追ってみる。人(引受担当者)と非人間(決済アプリ)の2本を並べると、判断材料(データソース)が違っても、流れは同じであることが分かる。

図4:1回のアクセスが実行される流れ(人・非人間の2例)

【人】引受担当者が引受審査アプリにアクセスする1回:

  • ① 要求:引受担当者の要求が、アプリ手前のPEPに届く。
  • ②③ 照会・評価:PEPは自分で判断せず、PDPに照会。PDPはデータソースで本人性(IdP/MFA通過)、端末状態(管理端末か)、時間(営業時間内か)を確認する。
  • ④⑤ 判定:ポリシー『引受担当者=社内/VPN+管理端末+MFA、与信判定のみ』に照らして許可と判定し、PEPに返す。
  • ⑥ 強制:PEPが許可を強制し、与信判定の操作だけを通す。

【非人間】決済アプリがカード会員データを読む1回:

  • ① 要求:決済アプリのサービスアカウント(SA)が、該当レコードの読取りを要求する。
  • ②③ 照会・評価:PEPがPDPに照会。PDPはSAの正当性とmTLS証明書の有効性、要求元が想定ワークロードかを確認する(ここでの判断材料は、人の場合のMFA・端末状態ではなく、証明書・ワークロードの正当性)。
  • ④⑤⑥ 判定・強制:ポリシー『決済アプリのSA=mTLS+該当レコードのみ』に照らして許可し、PEPが該当レコードだけを通す。

もし人間が同じカード会員データに直接クエリしようとすると、②〜⑤で条件(SA・mTLS・想定経路)を満たさないため、⑥のPEPで拒否される。同じデータでも、正規のワークロード経由なら通し、それ以外は止まる。これが「ポリシーをPDPが評価し、PEPが実行する」の具体像となる。

ステップ3(CBAC)とのつながり

第3回で見たCBAC(コンテキストベースアクセス制御)と、このステップ4は表裏一体である。キプリングメソッドで書いた5W1Hが、そのままCBACの評価属性になる。Whoは主体の役割、Whereは場所・ネットワーク、Whenは時間、Howは技術的統制。これらをPDPのポリシーエンジンが評価し、PEPが強制する。つまり、ステップ4で「ルールを言葉で定義」し、ステップ3のアーキテクチャで「そのルールを実行」する、という関係になる。

特権アクセス(管理者)のポリシー

ポリシー作成で、とりわけ慎重に扱うべきなのが管理者(特権)アクセスである。管理者は多くのシステムに広くアクセスできるため、攻撃者にとって格好の標的であり、ひとたび乗っ取られると内部を横移動され、影響範囲が一気に広がる。だからこそ、通常ユーザー以上に厳格なポリシーを敷く。CSA文書も特権アクセスの制御を重要な統制として挙げている。ここでも、ステップ1〜4の流れがそのまま効いてくる。

  • 踏み台を独立したプロテクトサーフェスにする(ステップ1):管理作業は、隔離できる踏み台(jump host/bastion)からのみ行う。踏み台自体を1つのプロテクトサーフェスとして定義する。
  • アイデンティティの分離(ステップ2):普段のアカウント(メール・チャット等)と管理用アカウントを完全に分ける。「山田」と「管理者・山田」は別ID・別環境とし、インターネットにつながる普段の端末から管理作業をしない。こうしないと許可すべきフローが増え、横移動が容易になる。
  • 踏み台への到達を最も固く(ステップ3・4):まずネットワークで絞る(社内の限定IP/ユーザーIDからのみ)。ネットワーク到達が無ければ攻撃者は何もできない。認証は、ID・パスワードだけでは弱いため、クライアント証明書+MFAトークンを重ねる。
  • PAM・短命セッション:特権アクセス管理(PAM)で、対象システムへの権限をその都度要求させ、短命の認証情報(短寿命のSSHトークン等)で、必要な間だけ付与する。踏み台から管理対象への接続も同様に絞る。
  • 踏み台の上でできることを絞る:メールもインターネットアクセスも不可。外部へは出させず、内部の必要な資源(ファイル共有、コンテナレジストリ等)だけに限定する。OS更新なども、ダウンロードをスキャン・ハッシュ検証するプロキシ経由で取り込み、時間帯も制限できる。最も避けたいのは、踏み台に遠隔操作ツールを仕込まれることである。
  • できれば映像のみ(KVM):最も厳格にするなら、データ転送を伴わない映像(KVM)アクセスに限る。一般にはRDPで踏み台に入る運用が多い。

狙いは、万一、踏み台が侵害されても攻撃者に何もさせないこと、つまりデータを持ち出せず、指示(マルウェア等)も送り込めない状態にする。そして、踏み台にアクセスする全員を監査する。この監査こそ、次回のステップ5(監視と保守)につながる。なお、いまは管理用アカウントを分ける組織は増えたが、依然としてインターネットにつながる普段の端末から管理作業をしている例が多く、ここは改善の余地が大きい。

インシデントの検知と対応

ステップ4は、アクセスポリシーを定義するだけではない。CSA文書は、ステップ4の活動にインシデント検知・対応メカニズムの構築も含めている。ポリシーに反するアクセスや、正常な動作からの逸脱を検知したら、アラートを上げ、遮断や再認証などの対応につなげる。第2回でマッピングしたトランザクションフローが「正常の基準」となり、そこからの逸脱が検知の手がかりになる。

ファイアウォールだけではない — ポリシーの適用先

「ポリシー」と聞くとファイアウォールのルールを思い浮かべがちだが、ゼロトラストポリシーの適用先はそれだけではない。ステップ3で選んだ各コントロールに、それぞれポリシーを与えて初めて機能する。

  • SaaS/クラウド:クラウドは「誰でも扉を叩ける」のが弱点。SASE(クラウド上のファイアウォール)で通信を自社経由に集約し、SaaS側で「自社を経由した通信だけを許可する」よう設定する。その”自社経由である”ことを伝える手段として、大きめのSaaS(Microsoft 365・Google・Salesforce等)では通信に目印を差し込むヘッダー挿入、小さめのSaaSでは自社の出口IPだけを通すIP許可リストを使う。いずれも入口が自社経由に限定され、インターネットからの直アクセスを排除できるため、アタックサーフェスが大きく下がる。
  • エンドポイント(XDR):コントロールがあっても、ポリシーがなければ何も止めない。たとえばカード会員データを扱うサーバーや引受担当者の端末で、ランサムウェア防御モジュールを有効化し、DBに触れてよいアプリを許可リストで限定する(未知のプロセスがカード会員データに触れたら遮断)。
  • アイデンティティ基盤(IdP):条件付きアクセスで、場所・時間・デバイスまで絞る。たとえば引受担当者のログインは『社内/VPN+管理端末+営業時間内+MFA』でのみ許可し、私物端末や深夜・国外からは追加認証か拒否とする。MFAも“ただ有効”では不十分で、設定を誤ると穴になる。
適用先クレジットカードでの具体例狙い
SaaS/SASE規制報告の提出ポータルや営業のCRMを、SASEで自社経由に集約し、SaaS側は『自社経由のみ許可』外部からの直接アクセスを排除
エンドポイント(XDR)カード会員データを扱うサーバーと引受担当者端末に、ランサム防御を有効化+DBに触れるアプリを許可リスト化端末・サーバー側で不正を遮断
IdP(条件付きアクセス)引受担当者は社内/VPN+管理端末+営業時間+MFAでのみログイン可。私物・深夜・国外は追加認証/拒否ログインの入口を状況で絞る

表5:ポリシーの適用先と、クレジットカードでの具体例

すべてに共通する原則は、具体的であること、そして業務上の正当性があることである。「全員がインターネットへ」のような広すぎるルールは避ける。理由(業務上の必要)がないポリシーは、そもそも作らない。

ポリシーの検証と見直し — 最も見落とされがち

ポリシーは作って終わりではない。むしろ検証(見直し)こそ最も見落とされがちな工程である。新しいアプリを動かすためにルールを足すのは自然に起きるが、アプリが廃止されてもルールは自動では消えないし、誰も困らないので放置され、ポリシーが腐敗(decay)していく。検証では、少なくとも次を確認する。

  • ステップ2と突き合わせる:そのフローは、ステップ2で「このプロテクトサーフェス間の通信は許す」と決めたものか。新たな要望なら、両プロテクトサーフェスの業務オーナー同士が合意して初めて許可する。
  • 具体的で、十分に厳格か:any/any のような広いルールを残さない。L4(ポート)ではなくL7(アプリケーション)で書き、必要ならスキャンや復号まで行う。
  • ツールの機能を使い切る:機器の自動更新で増えた新機能が未使用のまま眠りがち。たとえば新しいURLフィルタのカテゴリが追加されるとき、業務を止めないよう既定で「許可」で入ることが多い。ところがこの「許可」は、通信を通すだけでログも残さない設定になっていることが多く、その結果、該当する通信が起きていても管理者からは見えない(可視性が失われる)。更新のたびに、こうした新機能・カテゴリの設定を点検する。
  • 自動化する:PEPは多いので、変更のたび/毎日、構成を取得して整合を自動チェックするのが理想。難しければ、定期的に人が見直す。

この見直しは、5ステップを一度で終わらせず、繰り返し回していくことの一部でもある。業務オーナーの交代はステップ1、新たな通信要望はステップ2、新しいコントロールの必要はステップ3と、変化に応じて各ステップに戻る。ポリシーが「最初は静的でも、運用しながら動的に育つ」のは、この反復があるからである。まず1つのプロテクトサーフェスで作り込み、成熟させてから次へ広げる、という「練習台から本命へ」の考え方(第1回)も、ここで効いてくる。

ポリシー作成・検証の実務ポイント

  • デフォルト拒否から始め、必要なアクセスだけを明示的に足していく
  • 具体的に(広すぎる any/any を避け、L7・業務の言葉で書く)
  • 人と非人間(ワークロード・API・ボット・デバイス)の両方をWhoに含める
  • 業務上の正当性がないポリシーは作らない/廃止時はルールも消す
  • 自動で構成を点検し、更新で増えた機能・カテゴリの取りこぼしを防ぐ

まとめ

第4回では、配置したPEPにルールを与えるゼロトラストポリシーを作るステップ4を扱った。要点は次のとおりである。

  • ポリシーはアプリケーション層(L7)で、最小特権・デフォルト拒否を原則に、プロテクトサーフェスの近くで適用する
  • 書き方はキプリングメソッド(Who・What・When・Where・Why・How+どれだけの時間)。人だけでなく非人間も対象にする
  • 5W1HはそのままCBACの評価属性になり、ステップ3のアーキテクチャが実行する
  • 適用先はファイアウォールだけでなくSaaS/SASE・エンドポイント・IdPにも及ぶ。管理者アクセスは踏み台・アイデンティティ分離で特に厳格にする
  • 作って終わりにせず検証・見直しを(自動で)繰り返す。廃止時はルールも消し、静的から動的へ育てる
  • ステップ4にはインシデント検知・対応の構築も含まれる

守る対象を定め(1)、流れを可視化し(2)、アーキテクチャを構築し(3)、ポリシーを作った(4)。最終回(第5回)は、ステップ5「監視と保守」を扱う。すべてのトラフィックをアプリケーション層まで検査・記録し、そのテレメトリを使って、プロテクトサーフェスを継続的に強くしていく。ゼロトラストを「作って終わり」にしないための最後のステップである。

以上