カテゴリー別アーカイブ: ガイダンス

Microsoft 365大規模障害(2026年11月)を踏まえたクラウドレジリエンスの論点整理

2026年11月18日
ガイダンスWGメンバー 諸角昌宏

本ブログは、CSAジャパンとしての正式な見解ではなく、あくまで筆者の個人的な意見としてまとめたものである。しかしながら、この問題はクラウドセキュリティに関わる人に幅広く関係することとして、このCSAジャパン・ブログに掲載させていただく。皆さんの屈託のないご意見をいただければ幸いである。

本資料の位置づけ:本資料は2026年11月18日時点の公表情報に基づいている。11月12〜13日の障害の原因と経過は、マイクロソフトの暫定事後報告とその報道・解説に拠っている。最終版の事後報告など新たな報告が出た段階で、内容の更新を検討する。

出典の表記について:本文中の[n]は、末尾「5. 出典」の番号に対応する。事実(発表内容・報道内容・数値)には出典番号を付けた。出典番号のない記述は、それらの事実をもとにした筆者による分析・推論・提言である。

0. 要旨

  • 2026年11月12〜13日(日本時間13〜14日)のMicrosoft 365障害は、約24時間にわたり世界規模でExchange Onlineの接続とメール配送を止めた[4]。Teams、SharePoint、Copilot、Defender XDR、Purviewなども、Exchange Onlineと連携する機能に限って劣化した[9][12]。マイクロソフトの暫定事後報告(11月15日付)によると、原因は7月から展開していたゲートウェイ用Windows修正に潜んでいた不具合に、Teamsのフェイルオーバーによる負荷増と別件による容量減(約14%)が重なったことである[2][3][4][6]。
  • 論点1(基盤ソフトの保守とAIシフト):今年の主要障害は、新機能ではなく基盤の保守作業・変更(メンテナンス、証明書管理、OS修正、ネットワーク自動化)から生じている[4][20][22][23]。8月と11月はいずれもテスト環境と本番環境の差異で不具合を見逃した[2][23]。AI投資の拡大と同時にエンジニアの削減・自主退職募集が進んでいることへの批判があるが[13][16]、障害との因果関係を示す証拠は現時点ではない[13][16][17]。言えるのは、地味な保守と熟練者の知見が、障害の予防と復旧速度を支えているという構造的なリスクである。
  • 論点2(停止影響の最小化):今回は冗長化やヘルスチェックといった耐障害性の仕組みが障害を連鎖させ、数か月前の変更だったため通常のロールバックが使えず、RTOの前提が崩れた[4]。プロバイダー側では変更の安全性・容量の余裕・連鎖防止・独立した縮退モード、利用企業側では機能別の段階的な代替手段、別プロバイダーの活用、セキュリティ監視とAIエージェントの縮退設計が課題になる。
  • 論点3(クラウドサービスのRTO・RPOの評価):ISO/IEC 27017:2026は、利用者に対し、SLAなどの合意で定められたサービスレベルが自社のRTOを満たすことを確実にし、満たせない場合は他のクラウドサービスなどによる冗長化を検討するよう求めている[25]。一方、プロバイダーに求めるのは合意と情報・制約の提供であり、RTOの数値の約束までは求めていない。CSAのCCMも同様の構造である[26]。M365のように中断時のサービスレベルを合意していないSaaSでは、利用者は照合を行えず、冗長化や契約での確認で補う必要がある。

1. 11月12〜13日の障害の概要(暫定報告)

1.1 基本情報

項目内容
インシデント番号EX1550543(Exchange Online)、MO1550821(Microsoft 365全体)[9]
影響期間(暫定報告)11月12日16:20 UTC〜11月13日16:10 UTC(23時間50分)[4]。日本時間では13日01:20〜14日01:10(UTCからの換算)。なお、当初のインシデント記録(EX1550543)では開始が10:05 UTCとされており、事後報告の開始時刻と食い違っている[4](10:05 UTCを開始とすると約30時間)
復旧日本では14日13時17分に全面復旧が発表された[8]。障害開始からは約36時間
影響サービス影響の中心はExchange Online(Outlookでのメール接続・配送)で、他のサービスはExchange Onlineに依存する部分が影響を受けた[4]。Microsoftは影響範囲を「Exchange Onlineやメールサービスと連携するサービス」としている[12]。影響が挙げられたサービスはExchange以外に18に及び、個人向けのOutlook.com、OneDriveなども含まれた[9]。報道では、Teams、SharePoint Online、Microsoft 365 Copilot、Defender XDR、Planner、To Doへの影響が伝えられた[11]。他社AIサービス(ChatGPT、Claude)のMicrosoft 365コネクタにも影響した[10]
マイクロソフトの説明サイバー攻撃やAIエージェントが原因ではない[1]

1.2 3つの要因

要因内容
① 潜在的な不具合Microsoft 365のネットワークゲートウェイ(各サービスへの接続を中継するサーバー群)専用に用意したWindowsの修正に不具合が混入した[2][7]。特定の負荷条件で内部プロセスのロック競合が起き、CPUとメモリが枯渇してサーバーが応答不能になる[3]。7月から全世界に展開され、3か月以上問題なく動いていた[4][5]。この修正と不具合は、一般のWindowsには適用されない[7]
② 負荷の増加障害の約15時間前[3](11月12日01:07 UTC[4][7])、Teamsの通信が代替ゲートウェイから、Exchange Onlineも使う主ゲートウェイへフェイルオーバーした[3][4]。マイクロソフトはこれを通常運用の範囲としている[4]
③ 容量の減少前日の別件の問題で、ゲートウェイのサーバー容量の約14%が使えない状態だった[3]。単独では影響が出ない余裕があった[4]

テストで見逃した理由:負荷テストの環境と本番環境とで、通信の構成とハードウェアの種類が異なっていた[2][5]。ロック競合はコア数の多い新しいハードウェアで悪化するが、テストはコア数の少ない古いハードウェアが中心だった[4]。

1.3 障害が連鎖した仕組み

  1. 米国の利用が最も多い時間帯に、②のフェイルオーバーで負荷が増えたうえ、③で台数が減っていたため、1台あたりの負荷が高くなった。この高負荷の条件で、それまで3か月以上表に出ていなかった①の不具合(ロック競合)が初めて起き、サーバーが応答しなくなった[4]。
  2. トラフィック管理の仕組みが、落ちたサーバーの利用者を健全なサーバーへ振り替えた。振り替え先も負荷が増えて同じ不具合で落ちた[4]。
  3. 2時間足らずで不具合が全体に広がり、最悪時にはゲートウェイのサーバーの80%超が応答不能になった[4]。
  4. ゲートウェイはリージョンごとに区画(バルクヘッド)で分けられていたが、報告書で詳細が説明されていない別の問題により、障害は全世界に広がった[4]。

1.4 自動復旧が効かず、長期化した理由

  • 復帰させたサーバーは、溜まっていた通信が一気に押し寄せて、すぐにまた落ちた[4]。
  • 自動復旧の仕組みは、全体が同時に応答不能になる状態を想定していなかった[4]。
  • 原因が数か月前の変更だったため、通常のロールバック、段階展開(フライティング)、機能フラグでは素早く戻せなかった[4]。
  • 最終的には、接続処理のコードを以前の正常な状態に戻す更新を作り(11月13日07:20 UTCに最初の容量へ適用、障害開始から約15時間後)、リージョンの50%以上ずつサーバーを外して更新・再起動・復帰させた。業務時間帯に入る地域を優先した[4]。

1.5 暫定的な再発防止策

以下はいずれも暫定報告で完了済みとされた項目である[4]。

  • 接続処理のコードを以前の正常な状態に戻す更新
  • メール配送のタイムアウトの延長(公開ステータスページでは48時間)
  • 予防的な容量の追加
  • トラフィックの振り替えパターンと接続処理の健全性に関する監視の追加
  • 連鎖的な影響を防ぐための、トラフィック分配のガードレール

留意点:上記は暫後報告とその報道・解説にもとづく。詳細な事後報告は管理センター内(テナント限定)で公開されており[5]、最終版で内容が変わる可能性がある。

2. 論点1:クラウドを支える基盤ソフトの保守問題とAIシフト

2.1 2026年の主要障害は「基盤の保守」から起きている

2026年のMicrosoft 365の主要障害(規模の大きい4件)は次のとおりである。

障害引き金基盤の種類
1月22〜23日(約10時間:認識から復旧報告まで)[19]メンテナンスで容量を減らした状態に高負荷が集中[20]容量管理・メンテナンス運用
7月23日(約3時間40分:M365インシデントの開始から解決確認まで)[21]自動ネットワークメンテナンスシステムのバグで、想定より多い機器からルートを削除[21]ネットワーク運用の自動化(M365とAzureが共有するネットワーク基盤。Azureにも影響)[21]
8月31日〜9月3日(約67時間:インシデント記録の開始から解決まで)[23]証明書管理システムのコード更新で一部の新証明書が配布されず、監視の不具合も重なって失効[23]。影響はExchange Onlineの約5%で、大半の顧客には目立った影響がなかったとされる[22]証明書管理・監視
11月12〜13日(約24時間:暫定報告の影響期間)[4]ゲートウェイ用Windows修正の潜在バグに、フェイルオーバーと容量減が重なる[3][4]OS(Windows Server)の修正、負荷分散

注:本表は、2026年のMicrosoft 365の障害のうち規模の大きい4件を選んだものである。このほか、9月16日の世界的な502/503エラー[24]、10月12日のAzure Rights Managementなどの障害[25]、11月9日の欧州・中東・アフリカの一部でのOutlook on the webの障害[26]などが起きている。継続時間の基準は出典ごとに異なるため、括弧内に基準を記した。影響の規模も障害ごとに大きく異なり、継続時間だけで単純に比較することはできない。。

共通点は、いずれも利用者から見える新機能ではなく、クラウドの土台を維持するための保守作業や変更が引き金になっていることである(分析)。

2.2 今回の障害が示す基盤ソフト保守の難しさ

  • 汎用OSにクラウド専用の修正を当てている: 問題の修正は、Microsoft 365のゲートウェイサーバー専用に用意されたもので、一般のWindowsには適用されない[7]。汎用OSの上にクラウド固有の改変を重ねる運用では、その改変の検証もクラウド事業者自身が担うことになる(分析)。
  • 時限爆弾型の不具合: 3か月以上問題なく動いたあと[5]、特定の条件の組み合わせで初めて表面化した[4]。展開直後の異常を前提とする段階展開では検出できない(分析)。8月の証明書障害も、既存の証明書が失効した時点で初めて表面化しており[22]、同じ型である。
  • テスト環境と本番環境の差異の再発: 8月は.NETのバージョン差[22]、11月はハードウェアと通信構成の差[2][5]で、いずれも本番との違いが原因で不具合を見逃した。8月の再発防止策には「テスト環境と本番環境の差異解消(2026年10月目標)」が挙がっていた[22]が、別の形の差異で再び障害が起きた。
  • ハードウェアの世代交代: ロック競合はコア数の多い新しいハードウェアで悪化した[4]。マイクロソフトの9月四半期の設備投資は約30%増えている[13]。設備更新が急速に進む中で、既存ソフトウェアが新しいハードウェアの特性で想定外の動きをするリスクが増している(分析)。
  • 古いシステムと新しいサービスの重層化: マイクロソフトの基盤は、数十年来のシステムと新しいAIサービスが組み合わさっており、AIの層が加わるほど複雑で脆弱になり、障害の予防や封じ込めが難しくなるという指摘がある[16]。

2.3 AIシフトの中で起きていること

  • 投資配分の変化: マイクロソフトの9月四半期の設備投資(ファイナンスリースを含む)は452億ドルで約30%増えた一方、営業費用の伸びは9%に抑えられる見通しである[13]。
  • エンジニア人員の縮小: 2026年は、春の早期退職制度(米国で約8,750人が対象、30%超が応諾)、7月6日の約4,800人(従業員の約2.1%)の削減に続き、10月26日には自主退職募集を発表した。対象は米国・カナダ・英国・インドの参加チームのレベル70以下の社員で、約6万人に上る(財務・人事なども含み、一部のエンジニアリング部門は除外)[13]。インタビュアーのGergely Orosz氏は、ソフトウェアエンジニアの大半を対象とする募集は同社史上初めてだとしている。ただしマイクロソフトは、大半のソフトウェアエンジニアが対象であることを確認しておらず、対象チームの一覧も公表していない[13]。
  • 若手採用の鈍化: ナデラCEOは、新卒・若手の採用の鈍化を、チームが規模や役割を見直し、人員とAIの利用コスト(トークン予算)を比べていることと結びつけて説明し、鈍化は一時的だとの見方を示した[13]。これに対し[13]は、鈍化が続けば将来の熟練エンジニアの層が薄くなると指摘している。
  • 組織の位置づけ: 今回の根本原因の要約を公表したのは、Copilot・エージェント・プラットフォームを担当する執行副社長(EVP)のCharles Lamanna氏だった[5][14][6]。
  • 批判の内容: 障害の最中から、SNSでは「基盤を作った熟練エンジニアを削減し、地味な信頼性の仕事を評価しない」といった批判が拡散した[15]。ただし投稿の真偽は確認されていない。報道では、人員削減によってシステムの癖や古い不具合を知る経験者(組織の暗黙知)が失われると、障害時の対応が難しくなるという論点が示されている[16]。

2.4 評価:何が言えて、何が言えないか

言えないこと

  • 人員削減やAI投資が今回の障害を直接引き起こした、という証拠はない[13][16]。
  • AIが生成したコードが原因だという説も、根拠のない推測にとどまる[17]。マイクロソフトはAIエージェントが原因ではないと説明している[1]。

構造的なリスクとして言えること(分析)

  • 障害の予防: テスト環境の本番同等性、容量の余裕、ヘルスチェックの設計といった地味な保守は、新機能やAIと比べて評価されにくく、投資や人員の配分で後回しになりやすい。今年の障害は、まさにこの領域から起きている(2.1参照)。
  • 復旧の速度: 今回は、以前の正常な状態に戻す更新を最初の容量に適用するまでに約15時間かかった[4]。通常の手順で戻せない障害では、システムの内部を深く理解した人の判断が復旧時間を左右する。熟練者の減少は、障害の発生頻度より先に復旧時間に表れる可能性がある。
  • 複雑性の増大: AIサービスとそのコネクタが、既存の基盤の上に依存関係を増やしている。今回もCopilotや他社AIのコネクタが、Exchange Onlineと連携する部分で影響を受けた[9][10]。
  • 確認すべき先行指標: 利用企業は、ベンダーの事後報告で再発防止策が実際に完了しているか、同じ型の原因(テスト環境と本番の差異、潜伏型の不具合)が繰り返されていないかを追うことで、ベンダーの保守能力を評価できる。

3. 論点2:サービス停止の影響を抑える策とクラウドレジリエンスの課題

3.1 今回明らかになった課題

  • 耐障害性の仕組みが障害を広げた: ゲートウェイは独立した2系統で運用されていたが[2]、片方へのフェイルオーバーが負荷要因になった[3]。落ちたサーバーの利用者を健全なサーバーへ振り替える仕組みが、障害を全体に連鎖させた。リージョンごとの区画分けも機能しなかった[4]。
  • RTOの前提が崩れた: 復帰したサーバーが溜まった通信で再び落ち、原因が数か月前の変更だったため通常のロールバックも使えなかった[4]。原因を取り除いても戻らない状態(メタステーブル障害)の典型である(分析)。
  • 共通の障害領域: Microsoftは影響範囲を「Exchange Onlineやメールサービスと連携するサービス」としており[12]、Teams、SharePoint、Copilot、Defender XDR、Purviewなど、別々の製品がExchange Onlineとの連携部分で同時に影響を受けた[10]。Gartnerは、多くの企業でMicrosoft 365がID、端末のコンプライアンス、セキュリティ、AIのワークフローをつなぐ「結合組織」になっていると指摘している[19]。業務、AI、セキュリティを1つのプラットフォームに集約すると、製品ごとの継続計画では捉えにくい同時障害が生じる(分析)。
  • セキュリティの空白: Defender XDRやPurviewといったセキュリティ・コンプライアンスの製品も影響を受けた[10][11]。守るべきシステムと、それを監視する仕組みが同時に劣化しうる(分析)。
  • AIへの波及: Copilotに加え、他社AIサービス(ChatGPT、Claude)のMicrosoft 365コネクタにも影響が及んだ[10]。メールやカレンダー、ファイルに届かないAIアシスタントは回答の根拠を得られず、複数のAI事業者を使っていても、読みに行く先が同じM365であれば同時に影響を受ける(分析)。
  • 復旧後のリスク: Microsoftはメール配送のタイムアウトを延長して遅延メールを保護した[4]。その結果、復旧時には滞留していたメールが一斉に届くため、メールを起点にした自動化やAIエージェントが、重複した処理や古い情報にもとづく処理を行うおそれがある(分析)。また、Microsoftの脅威インテリジェンス部門は、今回の障害に便乗したフィッシング攻撃を確認したと公表している[14]。
  • SLAの限界: マイクロソフトのSLAでは、サービスクレジットが可用性の問題に対する唯一の救済手段とされ、請求には期限があり、補償額は利用料に対する割合で決まる[22]。SLAは補償の仕組みであって、業務を継続させる手段ではない(分析)。
  • 障害期間の定義はベンダーが決める: 今回、当初のインシデント記録と暫定事後報告とで開始時刻が食い違っている[4]。SLAの請求や社内の評価には、ベンダーの発表ではなく、自社で記録した影響時間を使う必要がある(分析)。

3.2 クラウド事業者・SaaSプロバイダー側の対策

以下は、今回の障害で明らかになった課題(1.2〜1.5、3.1)に対する対策の整理である(提言)。

課題対策
潜伏型の不具合段階展開に加え、長期間の経過後も古い変更を素早く巻き戻せる仕組み(変更ごとの既知の正常状態の保持)
テスト環境と本番の差異ハードウェアの世代・通信構成を本番と揃えた負荷試験、本番トラフィックの複製による試験
容量の余裕フェイルオーバーで負荷が移る先を含めて、容量の一部が欠けた状態でも耐えられるN+1の計画
連鎖的な拡大ヘルスチェックで同時に切り離せる容量の上限、振り替え量の上限、ロードシェディングと受け入れ制御。マイクロソフトもトラフィック分配のガードレールを追加している[4]
区画分けの実効性リージョン間のバルクヘッドが実際に機能するかを障害訓練で検証
全体同時停止からの復旧溜まった通信を少しずつ戻す段階的な復帰手順を自動化し、訓練しておく
全面停止時の継続主系とは別の実装・別の基盤で動く最小限の縮退モード(同じソフトウェアの複製では同じ不具合で止まる)
情報提供障害の状況や事後報告を、サインインが必要な管理画面の中だけで提供しない。管理画面は障害の影響で使えなくなることがある(8月の障害では、管理者が管理センターにサインインできない可能性があり、公開ステータスページが代わりの情報源になった)[23]。障害と同時に止まらない別の場所(サインイン不要の公開ステータスページなど)でも、同じ情報を提供する

3.3 利用企業側の対策

以下では、事実には出典番号を付け、それにもとづく対策は「(提言)」と明記した。

  1. 業務影響分析と機能別のRTO(提言)
    • 業務ごとに、M365が何時間止まると致命的かを定義する。今年の実績(約4時間〜約67時間、2.1参照)から、数時間・24時間・72時間の3つのシナリオで評価する。
    • 会議のようにその時間に価値がある業務では、ベンダーの復旧時間ではなく、代替手段への切り替え時間をRTOとして定義する。
  2. 段階的な代替手段(提言)
    • Teamsの中で切り替える: アプリ(デスクトップ・ブラウザ・スマートフォン)、回線(社内LAN・モバイル回線)、入り方(予定表ではなく控えた会議リンク)、電話参加、サインアウトしない
    • M365の別機能で代替する(会議基盤だけが止まった場合): チャットや共同編集での議論、メールでの決裁
    • 別プロバイダーの手段に移る: 別ベンダーの会議ツール(ログインとホスティングがマイクロソフトから独立していること)
    • クラウドに依存しない手段に移る: 社内の電話設備、拠点間のテレビ会議装置、携帯電話の通話
    • 対面・延期: 延期できる会議は延期し、意思決定が必要なものは対面や電話で進める
  3. 別プロバイダーの活用
    • クラウドセキュリティのBCDRの考え方では、別のクラウドプロバイダーをBCDRサイトにする構成が選択肢の1つとされている(一般的な考え方)。ISO/IEC 27017:2026も、他のクラウドサービスやICT環境による冗長化の検討を利用者に求めている(4.2参照)[27]。利用企業にとっては、別ベンダーのSaaSが、基盤・ソフトウェア・運用のすべてでM365から独立しており、どの種類の障害にも効く(分析)。
    • データへの依存が小さい機能(会議、チャット、緊急連絡)から始める。ID基盤とデータの独立性を優先して確保すれば、ベンダーロックイン対策も兼ねられる(提言)。
  4. セキュリティ監視の縮退設計(提言)
    今回は、Defender XDRやPurviewといったセキュリティ・コンプライアンスの製品も影響を受けた[10][11]。これを踏まえ、次の対策を取る。
    • 検知と記録の経路を、M365の外にも少なくとも1つ持つ(M365の外にあるSIEMやログ保管基盤など)。
    • セキュリティ製品の管理画面が使えない状態を想定し、縮退時の手順書を作る。警告をどこで確認するか、メールやリンクの検査が止まった場合に利用者へどう注意を促すか、復旧後に欠けたログをどう補うかを含める。
  5. AIと自動化の設計(提言)
    今回は、Copilotや他社AIサービスのMicrosoft 365コネクタも影響を受け[10]、復旧時には延長されたタイムアウトの間に滞留したメールが配送された[4]。これを踏まえ、次の対策を取る。
    • AIアシスタントやエージェントは、M365に接続できないときに、根拠のない回答を作らず、接続できないことを利用者に明示する設計にする。
    • メールを起点にした自動化やエージェントには、メッセージの受信時刻の確認と、同じ処理を繰り返しても結果が変わらない設計(冪等性)を入れ、復旧時の一斉配送で重複処理が起きないようにする。
  6. 情報と連絡の独立
    • Gartnerは、障害を検知する監視ツールの導入と、主要な連絡経路とは別の連絡手段(帯域外の連絡手段)と代替手段の確立を推奨している[18]。
    • 8月の障害では、管理者が管理センターにサインインできない可能性があり、公開ステータスページが代わりの情報源になった[23]。マイクロソフトの障害情報は、管理センターだけでなく、公開ステータスページや外部の監視サービスなど、M365の外でも受け取れるようにしておく(提言)。
    • 障害対応チームの連絡手段と連絡先を、M365の外(SMS、電話、安否確認システム、紙)に持ち、定期的にテストする(提言)。
  7.  契約とリスク管理
    • 月間稼働率ではなく、1回の停止時間や停止の頻度に応じた補償・解約権、独立した縮退モード、依存関係の開示を求める(提言)。
    • Gartnerは、多くの企業でMicrosoft 365がID、セキュリティ、AIのワークフローなどをつなぐ存在になっていると指摘し、メールや認証などでの単一ベンダーへの集中リスクを監査するよう推奨している[18]。リスク台帳では「マイクロソフト」を1つの委託先として扱うだけでなく、その下にある共通の依存先(メール配送、ID基盤など)まで把握する(提言)。
    • プロバイダーとの合意と自社のRTOの照合、RTO・RPOの開示については、4章で詳しく扱う。
    • EUの金融機関には、DORA(デジタル・オペレーショナル・レジリエンス法)により、ITの外部委託先への集中リスクの評価と、撤退計画の策定が求められている[35]。

3.4 冗長化の手段と効く障害の整理(分析)

冗長化の手段効く障害効かない障害
同じクラウドの中での冗長化(アベイラビリティゾーン、リージョン)データセンター・リージョンの障害共通基盤の障害、ソフトウェアの不具合(今回のように冗長系への切り替え自体が負荷要因になることもある[3])
SaaSベンダーのマルチクラウド(同じソフトウェア)クラウド事業者全体のインフラ障害ソフトウェアの不具合(今回のWindows修正の不具合は、別のクラウドでも同じく起きる)
独立した縮退モード(別の実装・別の基盤)上記に加え、主系のソフトウェアの不具合縮退モードと共通の依存先の障害
利用企業による別プロバイダーの活用(別SaaS)M365側のほぼすべての障害両方に共通する依存(認証、DNS、CDNなど)

4. 論点3:クラウドサービスのRTO・RPOをどう評価するか(ISO/IEC 27017)

今回の障害は、利用企業がクラウドのBCDRを評価する際の基準、特にRTO(目標復旧時間)とRPO(目標復旧時点)の扱いについて問題を提起している。本ブログでは、クラウドサービスの情報セキュリティ管理策の国際規格であるISO/IEC 27017:2026を中心に、CSAのCloud Controls Matrix(CCM)v4.1と比較しながら整理する。

4.1 問題の所在

  • BCPの原則として、RTOは業務の最大許容停止時間(MTPD)以下でなければならない(MTPD ≧ RTO)。SaaSを利用する企業にとって、システムのRTOはプロバイダーの復旧時間に依存する。
  • しかし、主要なクラウド事業者のRTO・RPOの扱いはまちまちである(4.3)。Microsoft 365は稼働率のSLAを約束する一方、データ復旧のRTO・RPOは定めていないと解説されている[29]。
  • プロバイダーのRTOが合意や開示で示されていなければ、利用企業は「プロバイダーの復旧時間で自社のRTOを満たせるか」を確認できない。今回のように約24時間〜約67時間の障害が起きても(2.1参照)、それが想定の範囲内か範囲外かを判断する基準がない。

4.2 ISO/IEC 27017:2026における要求

ISO/IEC 27017:2026は、箇条5.30「事業継続のためのICTの備え」について、ISO/IEC 27002:2022の5.30の管理策・目的・ガイダンスをそのまま適用したうえで、クラウドサービス向けのガイダンスを追加している[27]。その内容は次のとおりである(要旨)[27]。

当事者ガイダンスの内容
CSC・ クラウドSLAなどの合意で定められた、サービスの中断・障害に関するサービスレベルが、CSCが定めたRTOを満たしていることを確実にする
・ CSCに提供されるクラウドサービスのバックアップ機能が、事業の中断・障害時にCSCのICT戦略が必要とするデータ復旧のRPOを満たせることを確実にする
・ 他のクラウドサービスやICT環境の利用などによる冗長化を検討する
CSP・ CSCにクラウドSLAなどの合意を提供する・クラウドサービスの事業継続のためのICTの備えに関する情報と制約をCSCに提供する

また、クラウドSLAに関する情報はISO/IEC 19086シリーズが提供するとしている[27]。

この要求が意味すること(分析)

  1. RTOの照合先は「合意」である:CSCは、SLAなどの合意で定められたサービスレベルと、自社のRTOを照合することが求められる。プロバイダーの非公式な目安や過去の実績ではなく、合意が照合の対象になる。
  2. 照合の責任はCSCにある:RTOを定め、それを満たしていることを確実にする責任は、利用者の側に置かれている。CSPの責任は、合意と情報・制約を提供することである。
  3. 満たせない場合の手段が示されている:合意が自社のRTOを満たさない場合に備え、他のクラウドサービスやICT環境による冗長化の検討が明示されている。これは、本資料3.3③の「別プロバイダーの活用」と同じ考え方である。
  4. CSPには「制約」の提供も求められている:復旧目標の適用条件(たとえば災害の宣言を前提とするか)、論理障害が復旧の対象になるか、といった制約は、利用者が合意を評価するうえで欠かせない情報である。

4.3 主要なクラウド事業者の状況と、27017の要求との照合

事業者区分RTO・RPOの扱い27017の要求との照合(分析)
Microsoft 365SaaS公的な約束はない。SLAは月間稼働率のみ[29]。データセンター喪失時のRTO 1時間という数字が過去に紹介されたことはあるが、新しい公式文書は確認されていない[30]SLAが中断の長さを定めていないため、CSCは「合意のサービスレベルが自社のRTOを満たす」ことを確実にできない。冗長化の検討が必要になる
SalesforceSaaS災害復旧計画の目標として、災害宣言から12時間以内のサービス復旧(RTO)と、最大4時間のデータ損失(RPO)を掲げる[31]照合の材料はある。ただし「災害宣言後」という条件は、27017のいう「制約」として確認が必要。合意(契約)に含まれるかも確認が必要
AzureIaaS・PaaS機能ごとに目安を示すが、保証はしない(例:ストレージのリージョン間フェイルオーバーはRTO通常1時間未満、SLAなし)[32]目安は合意ではないため、照合の根拠としては弱い。利用者が自らの構成でRTOを設計する
AWSIaaS・PaaS責任共有モデルにより、AWSは「クラウドの」レジリエンス、利用者は「クラウドの中の」レジリエンスを担う。RTO・RPOは利用者が定めて設計する[33]利用者がRTOを満たす構成を自ら組む。照合の対象は、利用する個々の機能のSLAと仕様
Google CloudIaaS・PaaSDR計画は業務影響分析から始まり、そこでRTO・RPOを定めるとする[34]同上

IaaS・PaaSでは、利用者が自らの構成でRTOを設計できる。SaaSでは復旧の仕組みがすべて事業者の中にあるため、合意や開示がなければ、27017が求める照合を利用者が行えない(分析)。

4.4 CCMとの比較

CSAのCCM v4.1でも、実施ガイドラインでRTO・RPOが扱われている[25]。

CCMの実施ガイドラインの主な記述

注意: 実施ガイドライン(Implementation Guideline)の推奨事項であり、管理策そのものではない。

管理策対象記述(要旨)
BCR-02 事業影響分析CSP・CSC各当事者が独自にBIAを行い、RTOやRPOなどのパラメータを定義する[28]
BCR-03・04 事業継続戦略・計画CSP重要なプロセス・活動ごとにRTOとRPOを定義し、RTO内に復旧する手順を定める[28]
BCR-03 事業継続戦略CSC重要な業務機能についてRTOとRPOを設定する。それを達成するためにマルチクラウド戦略を選択できる[28]
BCR-09 災害対応計画CSPCSCは、RPOとRTOを含むCSPの災害対策・復旧能力について情報提供を受ける必要がある[28]
BCR-10 対応計画の演習CSCCSPのRTOとRPOがCSCの要件に準拠していることを検証する[28]

27017とCCMの比較

観点ISO/IEC 27017:2026(5.30)CCM v4.1(実施ガイドライン)
CSPに求めることSLAなどの合意と、ICTの備えに関する情報・制約の提供[27]RTO・RPOの定義と、CSCへの情報提供(BCR-03・04・09)[28]
CSCに求めること合意のサービスレベルが自社のRTOを満たすこと、バックアップ機能が自社のRPOを満たせることを確実にする[27]CSPのRTO・RPOが自社の要件に準拠していることを検証する(BCR-10)[28]
照合の対象SLAなどの合意CSPが定義・開示したRTO・RPO
別プロバイダーの活用他のクラウドサービスやICT環境による冗長化を検討する[27]目標達成のためにマルチクラウド戦略を選択できる(BCR-03)[28]
文書上の位置づけ5.30の管理策に対するクラウド向けガイダンスとして、規格本文に記載実施ガイドラインに記載。実施ガイドラインは網羅的でも規範的でもない推奨事項とされる[28]
管理策・質問票での扱い—管理策(BCR-09・10)、監査ガイドライン、CAIQの質問は、計画の確立、年1回の更新・演習を求めるが、RTO・RPOの数値には触れていない[28]

比較から言えること(分析)

  • 27017は「合意」、CCMは「開示」を軸にしている:27017は、CSCがSLAなどの合意と自社のRTOを照合する構造である。CCMは、CSPがRTO・RPOを定義・開示し、CSCが検証する構造である。27017のほうが、契約上の約束との照合を求める点で踏み込んでいる。
  • CCMでは、実施ガイドラインと管理策・CAIQとの間に差がある:CSPが管理策やCAIQの観点で準拠していても、RTO・RPOを開示していないことは起こりうる。STARの自己評価や認証で準拠が確認されていても、利用者がBCR-10の検証を行えるとは限らない。
  • 両者に共通する限界:どちらも、CSCにはRTOとの照合・検証を求める一方、CSPに求めるのは合意や情報・制約の提供、またはRTO・RPOの定義・情報提供にとどまる。RTOの数値を合意(SLA)として約束することまでは、どちらも求めていない。そのため、SaaSの利用者は、照合や検証の責任を負いながら、その材料を得られないことがある。

4.5 利用企業に対する提言

  1. 合意と自社のRTOを照合する:ISO/IEC 27017(5.30)に沿って、SLAなどの合意で定められたサービスレベルが自社のRTOを満たすかを確認する。M365のように稼働率のSLAしかない場合、合意には「1回の中断が何時間以内に復旧するか」が書かれていない。そのため、合意を根拠に「自社のRTOを満たす」とは言えない。この場合は、評価の結果を「RTOを満たすかどうか確認できない(未達として扱う)」と記録し、下記3の冗長化の検討に進む。
  2. 情報と制約の提供を求める:RTO・RPOの数値に加え、その適用条件(災害の宣言の有無、論理障害が対象になるか)を、27017のCSPのガイダンス(情報と制約の提供)とCCMのBCR-09を根拠に確認する。CAIQの回答や認証だけで判断しない。
  3. 照合できない場合は冗長化を検討する:27017のいう他のクラウドサービスやICT環境による冗長化(CCMのBCR-03のマルチクラウド戦略)で補うか、残るリスクとして受け入れるかを経営層が判断する。
  4. 契約交渉では、クラウドSLAの規格を参照する:クラウドSLAについてはISO/IEC 19086シリーズが情報を提供するとされており[27]、中断時のサービスレベルを合意に盛り込む際の参照にできる。

5. まとめ(分析)

  • 今回の障害の本質は、基盤ソフトの保守の中で生じた潜伏型の不具合と、耐障害性の仕組み自体が障害を連鎖させたことにある[4]。どちらも、ベンダー内部の冗長化やマルチクラウドでは防げない種類の障害である。
  • AIシフトに伴う人員と投資の配分の変化が障害を引き起こしたという証拠はない[13][16]。しかし、今年の障害が繰り返し基盤の保守の領域から起きていること、同じ型の原因(テスト環境と本番の差異)が再発していること[2][22]は、地味な保守と熟練者の知見への投資が問われていることを示している。
  • クラウドレジリエンスは、ベンダー任せにできない。プロバイダー側は変更の安全性・容量の余裕・連鎖防止・独立した縮退モードに、利用企業側は機能別の段階的な代替手段・別プロバイダーの活用・セキュリティとAIの縮退設計・独立した連絡手段に、それぞれ取り組む必要がある。
  • クラウドのBCDRを評価する基準としてのRTO・RPOについては、ISO/IEC 27017とCCMのいずれも、利用者に照合・検証を求める一方、プロバイダーにRTOの数値の約束までは求めていない。SaaSの利用企業がMTPD ≧ RTOを確認できるようにするには、合意と自社のRTOの照合、情報と制約の確認、冗長化の検討を利用者が行うとともに、規格や枠組みの側でも開示を促す仕組みが求められる。

6. 出典

11月の障害の原因・経過

[1]マイナビニュース「Microsoft 365大規模障害、なぜ復旧に時間がかかった? Microsoftが原因を説明」(2026年11月16日) https://news.mynavi.jp/techplus/article/20261116-5335439/

[2]ITmedia NEWS「『Microsoft 365』大規模障害、7月の修正で混入した不具合が原因 負荷増と容量減が重なり世界に波及」(2026年11月17日) https://www.itmedia.co.jp/news/article/2611/17/2000003245/

[3]PC Watch「Microsoft 365の大規模障害、原因はサーバーの潜在的なバグ」(2026年11月17日) https://pc.watch.impress.co.jp/docs/news/2157036.html

[4]IncidentHub「The November 12, 2026 Microsoft 365 Outage」(暫定事後報告の詳細な要約) https://blog.incidenthub.cloud/microsoft-365-outage-nov-12-2026

[5]Charles Lamanna氏(Microsoft)のX投稿(根本原因の要約) https://x.com/clamanna/status/2122209697226948729

[6]ZDNET Japan「マイクロソフトの幹部、大規模障害を引き起こした3つの原因を公表」(2026年11月17日) https://japan.zdnet.com/article/35254976/

[7]Office Watch「Microsoft 365 outage: what went wrong, in plain English」 https://office-watch.com/2026/microsoft-365-outage-explained/

[8]アイエスシーエヌ「Microsoft 365で大規模障害(11月13日)」 https://www.iscn.co.jp/microsoft-365-outage-20261113/

[9]System Design Academy「Microsoft 365 outage Nov 2026: what broke and why」 https://www.systemdesign.academy/explained/microsoft-365-outage

[10]Data is CITY「Microsoft 365の世界的な障害、回復が続き長めの経過観察へ」 https://teleport.jp/dataiscity/news-microsoft-365-outage/

[11]マイナビニュース「Microsoft 365で大規模障害、Outlookに接続できず TeamsやCopilotにも影響の可能性」(2026年11月13日) https://news.mynavi.jp/techplus/article/20261113-5313393/

[12]Control Plane「What Caused the Microsoft 365 Outage of November 12, 2026」 https://controlplane.com/blog/post/microsoft-365-outage-november-2026-cause

AIシフト・人員・信頼性をめぐる議論

[13]24/7 Wall St.「Microsoft Is Making Voluntary Exit Offers to Engineers for the First Time」(2026年11月17日) https://247wallst.com/investing/2026/11/17/microsoft-is-making-voluntary-exit-offers-to-engineers-for-the-first-time/

[14]FourWeekMBA「Microsoft 365 Root Cause: Latent Bug Behind 36-Hour Outage」 https://fourweekmba.com/ai-microsoft-365-root-cause-latent-bug-behind-36-hour-outage/

[15]X投稿(The Quiet Engineer、真偽未確認の批判の例) https://x.com/tQuietEngineer/status/2121249906132390024

[16]Fast Company「Microsoft’s massive outage puts its AI-driven layoffs under scrutiny」 https://www.fastcompany.com/91642223/microsofts-massive-outage-puts-its-ai-driven-layoffs-under-scrutiny

[17]Capital and Compute「Did AI-Generated Code Cause the Microsoft 365 Outage?」 https://capitalandcompute.net/blog/did-ai-generated-code-cause-the-microsoft-365-outage/

レジリエンス・集中リスク

[18]CIO Dive「Microsoft 365 outage underscores enterprise resiliency issues」(Gartnerの見解を含む) https://www.ciodive.com/news/microsoft-outage-enterprise-resiliancy/874695/

2026年のその他の障害

[19]The Register「Microsoft 365 outage drags on for nearly 10 hours」(2026年1月23日) https://www.theregister.com/2026/01/23/microsoft_365_outage/

[20]ケータイ Watch「Microsoft 365で障害か、北米中心にOutlook送受信不可やTeams機能制限など」(2026年1月23日) https://k-tai.watch.impress.co.jp/docs/news/2080316.html

[21]BleepingComputer「Microsoft blames massive Microsoft 365 outage on maintenance bug」(2026年7月24日) https://www.bleepingcomputer.com/news/microsoft/microsoft-blames-massive-microsoft-365-outage-on-maintenance-bug/

[22]Pro IT NW「Microsoft 365 outage, August 2026: what the SLA pays」(8月障害の事後報告の要約) https://www.proitnw.com/blog/microsoft-365-outage-august-2026-service-credit/

[23]StatusStack「You Can’t Debug Microsoft 365 From Microsoft 365」(8月障害のタイムライン) https://statusstack.com/blog/microsoft-365-august-2026-outage

[24]Cybersecurity News「Microsoft 365 Hit by New Outage」(MO1472904) https://cybersecuritynews.com/microsoft-365-hit-by-new-outage/

[25]UptimeRobot「Microsoft 365 outage on 2026-10-12」 https://uptimerobot.com/is-it-down/microsoft-365/2026-10-12/

[26]IsDown「Some users may experience errors or failures when accessing their mailbox via Outlook on the web」(2026年11月9日) https://isdown.app/status/microsoft365/incidents/683602-some-users-may-experience-errors-or-failures-when-accessing-their-mailbox-via-outlook-on-the-web

規格・枠組み、RTO・RPO関連

[27]ISO/IEC 27017:2026 箇条5.30(事業継続のためのICTの備え)、Table 17(規格本文のためURLなし)

[28]Cloud Security Alliance「Cloud Controls Matrix v4.1.0」日本語版(CSAジャパン、2026年1月13日生成版)のImplementation Guidelines、Auditing Guidelines、CAIQ、Introductionの各シート  https://csajc1.sharepoint.com/:x:/s/CSAJapanMaterial/IQDee971SIJuQIPh-jSKxoUNAQtYZB8FMGQg9AP7m3QX-ds?e=tkAKUG

[29]AvePoint「What Are RTO and RPO? Why the Cloud Changes Everything」 https://www.avepoint.com/blog/backup/what-are-rto-and-rpo-cloud

[30]Microsoft Q&A「Exchange Online RTO/RPO」(2016年) https://learn.microsoft.com/en-us/answers/questions/4896084/exchange-online-rto-rpo

[31]Flosum「Trust Center Support」(Salesforceの災害復旧目標の紹介) https://docs.flosum.com/support/service-level-agreement/flosum-devops-data-migrator-and-trust-center-support

[32]Microsoft Tech Community「Understanding Azure Storage Redundancy Offerings」 https://techcommunity.microsoft.com/blog/azurestorageblog/understanding-azure-storage-redundancy-offerings/1431700

[33]AWS「Shared Responsibility Model for Resiliency」 https://docs.aws.amazon.com/whitepapers/latest/disaster-recovery-workloads-on-aws/shared-responsibility-model-for-resiliency.html

[34]Google Cloud「Disaster recovery planning guide」 https://docs.cloud.google.com/solutions/disaster-recovery-cookbook

[35]Regulation (EU) 2022/2554(デジタル・オペレーショナル・レジリエンス法、DORA)(法令のためURLなし)

以上
大阪公立大学 情報基盤システム障害 ~ 事例の概要とCSAクラウドセキュリティガイダンスに基づく分析

2026年11月15日
ガイダンスWGリーダー 諸角昌宏

本ブログは、CSAジャパンとしての正式な見解ではなく、あくまで筆者の個人的な意見としてまとめたものである。しかしながら、この問題はクラウドセキュリティに関わる人に幅広く関係することとして、このCSAジャパン・ブログに掲載させていただく。皆さんの屈託のないご意見をいただければ幸いである。

本資料の位置付け

本資料は、大阪公立大学が公表した第6報および添付資料を一次情報として事案の概要を整理し、CSAのセキュリティガイダンスv5とクラウドコントロールマトリックス(CCM)v4.1.0の観点から、関連する管理領域と確認事項を対応付けたものである。 公表された事実、CSAガイダンスに照らした分析・確認事項、現時点で不明な事項を区別する。公表資料で確認できない対策の有無や責任分担については、事実として断定しない。

エグゼクティブサマリー

  • 攻撃の起点として、NECの再委託先事業者の端末への不正アクセスが確認された。
  • 再委託先端末およびNEC管理のクラウドストレージから大学関連情報が漏えいした形跡があり、その後、NEC・再委託先が業務で使用する正規アカウント(管理者アカウントを含む)とパスワードを用いた大学システムへの不正アクセスが確認された。
  • NEC管理のクラウドストレージから、学生・教職員等の個人情報約17万名分が漏えいした。うち約1,400名分には銀行口座番号、健康関連情報、パスポート画像、旅券番号等が含まれていた。
  • 機密性の高い情報の多くは、2021年度のシステム移行作業で使用されたデータであり、作業完了後もストレージ上に保存されていた。
  • 大学自身の情報システムから個人情報が漏えいした明確な事実は第6報時点で確認されていない。ただし、不正アクセスとシステム暗号化があったため、漏えい可能性は否定されていない。
  • CSAの観点では、データセキュリティとプライバシーのライフサイクル管理(DSP)、アイデンティティとアクセス管理(IAM)、サプライチェーンの管理・透明性・説明責任(STA)、ガバナンス・リスク・コンプライアンス(GRC)が中心的な分析領域となる。

1. 事案の概要(公表内容)

1.1 攻撃・情報漏えいの経緯

関係を整理すると、「大阪公立大学 → NEC(受託事業者) → 再委託先事業者」という構造である。再委託先は、大学から直接委託を受けた事業者ではなく、NECが大学から受託した業務の一部をさらに委託した事業者を指す。

ただし、第6報から確認できるのは業務上の委託関係までであり、再委託先の企業名、NECとの資本関係(子会社・関連会社等であるか)、具体的な担当業務の範囲は公表資料から特定できない。したがって、資本関係や担当範囲を推測して記載しない。

大学の第6報によれば、大学は情報基盤システムの構築および運用保守業務をNECに委託していた。NECの再委託先事業者の端末が不正アクセスを受け、その端末およびNECが管理するクラウドストレージ上から、大学に関する大量のデータが漏えいした形跡が確認された。

さらに、その記録時刻の直後に、NECおよび再委託先が委託業務で使用する正規アカウントとパスワード(システム管理者アカウントを含む)を用いた大学システムへの不正アクセスが確認された。専門調査会社の調査では、再委託先への侵入と大学への侵入が同一攻撃者によるものと判断できる複数の証跡が確認された。

大学は、攻撃者が再委託先端末への侵入を通じてNEC管理のクラウドストレージから窃取したアカウント情報・パスワード等を悪用し、大学システムに侵入してサイバー攻撃を行ったものと判断している。

時系列で見ると、再委託先は2026年9月下旬にサイバー攻撃を受け(NECの2026年10月20日付公表による)、10月2日未明に大学の情報基盤システムで大規模な障害が発生した(大学の障害情報ページによる)。その後、11月12日にNECから大学へ漏えい内容に関する追加報告があり、第6報で漏えいした情報の内容と件数が公表された。

段階時期第6報・別紙2で示された内容
① 再委託先端末2026年9月下旬不正アクセスを受け、端末から情報が流出。クラウドストレージへのアクセス方法も漏えいしたと考えられる。
② NEC管理のクラウドストレージ公表資料では時期は示されていない(11月12日にNECが大学へ追加報告)大学のシステム関連重要情報、管理者アカウント・パスワード、個人情報等が漏えい。2021年度のデータ移行業務に使用した機密情報も含まれる。
③ 大学システムへの侵入②の記録時刻の直後窃取した情報を利用した可能性が非常に高いとされ、NEC・再委託先が使用する正規アカウントで不正アクセス。
④ システム暗号化2026年10月2日未明に障害発生大学の仮想化基盤、各種サーバー、バックアップデータ等が暗号化された。

1.2 漏えいした情報

NEC管理のクラウドストレージから漏えいした情報として、大学は次の内容を公表している。数値はいずれも大学公表の概数である。機密性の高い情報(銀行口座番号、健康関連情報、パスポート画像、旅券番号)の内訳を単純に合計すると約1,420名分となり、大学が公表する約1,400名分と概数として整合する。

情報の区分公表された規模補足
学生・教職員等の個人情報約17万名分ID、氏名、メールアドレス、生年月日等を含む
銀行口座番号約20名分機密性の高い個人情報
健康関連情報約200名分2018~2021年度に在籍した教職員・学生
パスポート画像約200名分2018~2021年度に留学した外国籍の方
旅券番号約1,000名分2018年度〜2021年度に在籍した学生の中で、JCSOS(海外渡航者)の対象者

機密性の高い情報の多くは、2021年度に実施したシステム移行作業で使用したデータであり、作業完了後もNEC管理のクラウドストレージに保存されたままだったと大学は説明している。大学は、長期間削除されず、多くのNEC・再委託先関係者が利用するストレージに保管されていたことを重大な問題と認識している。

1.3 大学システムからの情報漏えいと暗号化

第6報時点で、大学の情報システムから個人情報が漏えいした明確な事実は確認されていない。一方、不正アクセスがあり、多くのシステムが暗号化されていることから、漏えいの可能性を完全には否定できないとしている。

別紙2では、仮想化基盤、各種サーバー、バックアップデータ等が暗号化されたと説明されている。したがって、バックアップを含む復旧環境への影響が確認されているが、具体的な復旧可能性や復旧手順の詳細は、第6報だけからは評価できない。

2. CSAガイダンスの枠組み

本分析では、CSAセキュリティガイダンスv5をクラウドセキュリティ上の論点を整理する上位ガイダンスとして用い、CCM v4.1.0 日本語版を具体的な管理策・評価項目を検討するための管理策フレームワークとして用いる。

CSAセキュリティガイダンス v5は12ドメインで構成される。CCM v4.1.0は17ドメイン・207の管理策で構成され、クラウドサービスプロバイダ(CSP)とクラウドサービス利用者(CSC)を含むクラウドサプライチェーン上で、どの主体がどの管理策を実施するかを評価・整理するために利用できる。

2.1 クラウドセキュリティの観点から見た本件の問題

本件は、クラウド基盤やクラウドサービスの脆弱性が原因と確認された事案ではない。クラウドセキュリティの観点で問題となるのは、クラウド事業者が提供する基盤そのものではなく、クラウドサービスを「どう使い、誰が管理していたか」という運用の部分である。

各主体の立ち位置は、ISO/IEC 22123-1:2023(用語)および22123-2:2023(概念)の役割区分(CSP、CSC、クラウドサービスパートナー〔CSN〕)を用いると、次のように整理できる。表の「役割」は、公表された事実にこの区分を当てはめた分析上の位置付けであり、公表資料に記載された事実ではない。CSNは、CSPやCSCを支援する事業者を指し、システムの構築・運用を請け負う事業者などが含まれる。役割は会社ごとではなく関係ごとに決まるため、同じ主体が相手によって異なる役割を持つことがある。

主体本件での役割(分析上の位置付け)公表資料で確認できること公表資料で確認できないこと
大学CSCに相当(データの持ち主)情報基盤システムの構築・運用保守をNECに委託。自らのデータがNEC管理のストレージに保管されていた。当該ストレージの契約に大学が当事者として関与していたか。
NEC大学に対してはCSNに相当情報基盤システムの構築・運用保守の受託者。第6報で「NEC管理」とされるクラウドストレージの管理者。ストレージに関する立場。他社のストレージサービスを契約していたなら基盤事業者に対するCSC、自社のクラウドサービスとして提供していたならCSPとなる。
再委託先NECの下でのCSNに相当NECから業務の一部を再委託されていた。端末が侵入の起点となった。企業名、NECとの資本関係、担当業務の範囲、ストレージへのアクセス権限の範囲。
ストレージの基盤事業者CSPに相当―事業者名、サービスモデル(IaaS/PaaS/SaaS)、NECとの契約関係。

この整理のうち、公表資料で確認できる事実は、NECが大学から情報基盤システムの構築・運用保守を受託していたこと、および問題のストレージが「NEC管理」とされていることである。NECを大学に対するCSNと位置付けるのは、この事実に基づく分析上の当てはめであり、大学のシステムがクラウドを利用していたかどうかも公表資料からは特定できない。一方、NECがストレージについてCSPであったか、他社サービスの利用者(CSC)であったかは、第6報からは判断できない。このため、本資料ではNECを当該ストレージのCSPと断定しない(責任分担の評価上の留意点は第5章で述べる)。

クラウドでは、運用を委託してもデータに対する責任は利用者側に残る。本件では、大学はデータの持ち主として説明責任を負う立場にあり、当該ストレージの日常的な管理(アクセス権の付与・見直し、データの削除)は、ストレージを管理していたNECが担っていたと考えられる。ただし、契約上の責任分担は公表されていない。

用語について:CCM v4.1.0は、CSPとCSCの二者を基本に責任分担を整理しており、CSNという用語は用いていない。委託先・再委託先との関係は、CCM上は主にSTAドメイン(サプライチェーンの管理、透明性、説明責任)で扱っている。

以上を踏まえ、公表資料に基づくと、本件の問題は次の5点に整理できる。

  1. クラウドストレージのデータライフサイクル管理が機能していなかった可能性:クラウドストレージは、関係者間でデータを簡単に共有でき、容量の制約もほとんどない。そのため、作業用データが業務終了後も削除されずに残りやすい。本件では、2021年度の移行作業で使われた機密性の高いデータが、作業完了後も長期間、多くのNEC・再委託先関係者が利用できるストレージに残っていた。大学自身もこの点を重大な問題と認識しており、保管期間、削除、アクセス範囲の管理が十分に機能していなかったことが、漏えいの重大性につながった可能性がある。(関連:DSP)
  2. アイデンティティが事実上の境界となる構造:クラウドサービス一般では、インターネット経由で利用するストレージや管理機能へのアクセスは、ネットワークの内側か外側かよりも、正しい認証情報を持っているかどうかで決まる。本件の当該ストレージや大学システムへのアクセス経路は公表されていないが、再委託先端末からストレージへのアクセス方法が漏えいし、さらにストレージに保管されていた管理者アカウント・パスワードが大学システムへの侵入に使われた。認証情報そのものの保護、保管場所、多要素認証の有無が、防御の要となる構造である。(関連:IAM)
  3. 責任共有の範囲が委託・再委託先に広がり、管理主体が見えにくかった:クラウドの責任共有モデル(SSRM)は、CSPと利用者の二者関係として説明されることが多い。本件のストレージは「NEC管理」とされ、大学、NEC、再委託先が関与していた。誰がアクセス権を付与・見直し、誰がデータの削除を確認し、誰が設定を監査するのかが、委託元である大学から見えにくい構造だった可能性がある。第6報では、ストレージの基盤提供者や契約関係は明らかにされていない。(関連:STA、GRC)
  4. 委託先が管理するクラウド環境は、委託元からの可視性が限られる:大学のデータを保管していても、委託先が契約・管理するクラウドストレージのアクセスログや設定は、大学が直接確認できないことが多い。大量ダウンロードや通常と異なる端末からのアクセスがあっても、委託元が自ら検知することは難しい。ログの取得・保存・共有と、異常時の報告義務を契約や手順で定めておくことが重要になる。(関連:LOG、SEF)
  5. 管理者権限の奪取がバックアップにまで及ぶリスク(一般論):仮想化基盤やクラウドの管理機能は、1つの管理者アカウントで多数のシステムを操作できる。一般に、バックアップが本番環境と同じ認証情報・管理経路に依存していると、管理者権限を奪われた際にバックアップまで失われるおそれがあり、これはクラウドかオンプレミスかを問わず仮想化・クラウド環境に共通するリスクである。本件では管理者アカウントによる侵入の後、仮想化基盤、サーバー、バックアップデータ等が暗号化されたが、バックアップがどの認証経路で管理されていたかは公表されていない。このため、本資料ではこの点を確認事項として扱う(4.4参照)。(関連:I&S、BCR)

留意点:大学の情報基盤システム自体がクラウド上にあったか、オンプレミスの仮想化基盤であったかは、第6報からは特定できない。上記は、委託先が管理するクラウドストレージを中心に、クラウドセキュリティの考え方を当てはめた分析上の整理であり、各主体の対策の不備を断定するものではない。

3. 事案とCSAの主要領域との対応

以下は、事案との関連性が高いCCM v4.1.0 日本語版のドメインを中心に整理したものである。対応付けは分析上の整理であり、当該管理策に違反したことを意味するものではない。

優先順位の意味:ここで示す「最優先」「高」「中~高」は、本事案を筆者の観点から分析する際の検討順序を示すものである。公式な重要度や、CCM管理策の適合性評価・リスク評価を示すものではない。

CCMドメイン事案との関係確認・評価すべき事項分析上の優先順位
DSP:データセキュリティとプライバシーのライフサイクル管理機密性の高い情報の多くを占める移行データが業務完了後もクラウドストレージに残存し、漏えい。データ分類、保管目的・期間、保存場所、アクセス範囲、削除・消去確認、委託終了時のデータ処理。最優先
IAM:アイデンティティとアクセス管理正規アカウント・パスワード(管理者アカウントを含む)が悪用され大学システムへ侵入。MFAの適用状況、特権ID管理、最小権限、認証情報の保護・共有、アクセス経路制限、アカウント棚卸し。最優先
STA:サプライチェーンの管理、透明性、説明責任再委託先端末への侵入が、委託先のストレージ情報窃取と大学への侵入につながった。再委託先の把握・評価、契約上のセキュリティ要求、アクセス権限、監査・報告、委託先の継続的モニタリング。最優先
GRC:ガバナンス、リスク、コンプライアンス大学・NEC・再委託先間の管理責任、業務完了後のデータ保持管理が論点。責任分担、リスク評価、委託・再委託の統制、業務終了時の確認、監査証跡、例外承認。高
LOG:ロギング&モニタリング正規アカウントの悪用や大量データアクセスを検知・追跡できるかが論点。認証・管理操作・ストレージアクセスのログ、異常なダウンロード、アクセス元・端末の変化、ログ保全と相関分析。高
UEM:ユニバーサルエンドポイント管理再委託先の端末が侵入起点となった。端末の資産管理、パッチ・EDR等の保護、端末準拠性、ローカル保存・認証情報保存の制御、遠隔隔離。高
SEF:セキュリティインシデント管理、Eディスカバリ、およびクラウドフォレンジック侵入調査、情報漏えい範囲の特定、証拠保全が必要。インシデント対応計画、委託先との連絡・協力、証拠保全、フォレンジック、報告・通知、再発防止。高
BCR:事業継続管理と運用レジリエンス仮想化基盤、サーバー、バックアップデータ等が暗号化。バックアップの分離・保護、復旧優先順位、復旧テスト、代替運用、復旧目標と依存関係。高
I&S:インフラストラクチャセキュリティ仮想化基盤や各種サーバーが暗号化対象となった。管理プレーン保護、管理ネットワーク分離、ハイパーバイザー・管理者権限、ワークロード間分離。中~高

4. 重点分析テーマ

4.1 データセキュリティとプライバシーのライフサイクル管理(DSP)

最も明確な論点は、漏えいした機密性の高い情報の多くを占める2021年度の移行作業用データが、作業完了後も委託先管理のクラウドストレージに残存していたことである。クラウド上のデータは、保存中の暗号化だけでなく、利用目的、保管期間、アクセス主体、複製・転送、アーカイブ、削除までをライフサイクルとして管理する必要がある。

  • 移行作業完了時に、作業用データの削除・返却が契約・手順で定義されていたか。
  • 削除対象、削除期限、削除実施者、削除証跡の確認方法が明確だったか。
  • ストレージへのアクセス権が業務上必要な関係者に限定され、定期的に見直されていたか。
  • 個人情報・健康関連情報・旅券情報等の機密性に応じて、保存場所やアクセス条件を分けていたか。

4.2 アイデンティティとアクセス管理(IAM)

今回の侵入では、正規アカウントとパスワードが使用された。したがって、認証が成功したかどうかだけでなく、誰が、どの端末から、どの経路で、どの権限を用いて、何を実行したかを検証する必要がある。

  • 管理者アカウントの利用者・利用目的・利用時間を限定していたか。
  • MFA、特権アクセス管理、必要時のみの権限付与、セッション監視がどの範囲に適用されていたか。
  • 委託先・再委託先の端末やネットワークから大学環境へ接続する際の条件が定義されていたか。
  • 認証情報が端末や共有ストレージに平文・再利用可能な形で保存されないよう管理されていたか。

留意点:第6報はMFAの適用状況、特権アクセス管理の詳細、具体的なログ監視設定を明らかにしていない。したがって、これらは確認事項であり、未実施・不備とは断定できない。

4.3 サプライチェーンの管理・透明性・説明責任(STA)とガバナンス・リスク・コンプライアンス(GRC)

大学、NEC、再委託先という複数主体が関与する構造では、委託元が直接管理できない端末・アカウント・保管環境が、委託元システムへの侵入経路となり得る。STAおよびGRCの観点では、委託先の評価だけでなく、再委託先の把握、アクセス経路、契約条件、監査権、事故報告、業務終了時のデータ処理までを一連の統制として扱う。

  • 再委託先を含むサプライチェーンの構成・役割・データアクセス範囲を可視化していたか。
  • 再委託先に対するセキュリティ要求事項が契約に反映され、履行状況を確認していたか。
  • 委託業務終了時のデータ返却・削除、アカウント停止、認証情報更新を確認するプロセスがあったか。
  • 大学・NEC・再委託先・ストレージ提供者の責任分担とインシデント時の協力義務が明確だったか。

4.4 ロギング&モニタリング・セキュリティインシデント管理・事業継続管理と運用レジリエンス(LOG/SEF/BCR)

正規アカウントの悪用は、単純な認証失敗の監視だけでは検知できない場合がある。認証ログ、特権操作ログ、ストレージのダウンロード・共有ログ、接続元端末情報を組み合わせた監視が重要となる。また、大学の仮想化基盤、サーバー、バックアップデータ等が暗号化されたとされるため、バックアップの保護と復旧訓練を含むレジリエンス評価が必要である。

  • 異常な大量アクセス・ダウンロードや、通常と異なる端末・接続元からの管理者アクセスを検知できるか。
  • ログが攻撃者によって改ざん・削除されないよう保護され、調査に利用できる期間保存されているか。
  • 委託先・再委託先からの初報、証拠保全、影響範囲調査、顧客・本人への通知の役割分担が定義されているか。
  • バックアップが本番環境と同じ認証・管理経路に依存していないか。隔離・イミュータブル化(不変化)・復旧テストが実施されているか。

5. クラウド責任分担を評価する際の留意点

本件では「NEC管理のクラウドストレージ」と公表されているが、第6報だけでは、当該ストレージの基盤提供者、サービスモデル(IaaS/PaaS/SaaS)、契約関係、管理権限の所在を特定できない。

したがって、NECを当該ストレージのCSPと断定したり、大学をそのサービスのCSCと単純に位置付けたりすることは避ける。実際の責任分担は、契約、サービス構成、管理権限、データ管理の実態を確認した上で整理する必要がある。

CCM v4.1.0 日本語版のSTAドメイン(STA-02「SSRMポリシーと手順」~STA-07「SSRM管理策の実施」)およびIntroductory Guidanceで示されるセキュリティ責任共有モデル(SSRM)の考え方を用い、CSP・CSCだけでなく、委託先・再委託先を含む各主体について、管理策ごとに実施主体、確認主体、証跡を明確にすることが望ましい。なお、管理策番号はCCM v4.1.0 日本語版の「CCM_V41」シートによる。v4.1ではSTA-01に新たな管理策が追加されたためSSRM関連の番号が繰り下がっているが、Introductory Guidanceの本文には、SSRMの案内をSTA-01~STA-06とする旧番号表記が残る箇所がある。

6. 事実と未確認事項の区別

第6報で確認・公表された事項第6報だけでは確定できない事項
・再委託先端末への不正アクセス・大学システムから個人情報が実際に漏えいしたか(明確な事実は未確認)
・NEC管理ストレージからの大学関連情報の漏えい形跡・MFAの適用状況・特権ID管理の具体的内容
・正規アカウント・パスワード(管理者アカウントを含む)による大学システムへの不正アクセス・ストレージのサービスモデル、基盤提供者、契約関係
・NEC管理ストレージから個人情報約17万名分、機密性の高い情報約1,400名分が漏えい・各主体間の最終的な責任分担・契約上の責任
・機密性の高い情報の多くは2021年度の移行データで、作業完了後も保存されていた・バックアップの復旧可能性、復旧に要する時間・範囲
・大学の仮想化基盤、サーバー、バックアップデータ等の暗号化・各管理策が実施されていたか、または不備があったか

7. まとめ、分析の方向性

7.1 事案の全体像

本件は、クラウド基盤自体の脆弱性が原因であったと確認された事案ではない。公表資料から読み取れるのは、①再委託先端末への侵入、②委託先が管理するクラウドストレージからの情報窃取、③窃取した正規の認証情報(管理者アカウントを含む)による大学システムへの侵入、④仮想化基盤・サーバー・バックアップデータ等の暗号化、という4段階の連鎖である。

この連鎖は、大学が直接管理していない再委託先の端末と、委託先が管理するストレージを起点としている。また、侵入には正規アカウントが使われたため、大学側の境界防御だけでは防ぎにくい。一方で、委託先アカウントの接続条件、MFA、特権アクセス管理は大学側でも設定し得る対策であり、4.2で確認事項に挙げたとおり、委託先アカウントのアクセス経路の統制は大学側の論点でもある。本件は、委託元・委託先・再委託先を通じたデータと認証情報の管理が問われた事案といえる。

被害の重大性に大きく影響したと考えられるのは、機密性の高い情報の多くを占める2021年度の移行データが、作業完了後も長期間、多くの関係者が利用できるストレージに残っていたことである。この移行データが削除されていれば、攻撃の起点が同じでも、銀行口座番号や健康関連情報、旅券情報といった機密性の高い情報の漏えいは大きく限られた可能性がある。なお、約17万名分の個人情報全体が移行データであったとは公表されていない。

7.2 CSAの観点から見た論点の整理

CCM v4.1.0 日本語版のドメインに照らすと、本件の論点は次のように整理できる。いずれも公表資料に基づく分析上の対応付けであり、特定の管理策の不備を断定するものではない。

  • DSP(データセキュリティとプライバシーのライフサイクル管理):業務完了後のデータ削除・返却、保管期間とアクセス範囲の管理。機密性の高い情報の漏えいに最も直接関係する論点。
  • IAM(アイデンティティとアクセス管理):正規アカウントと管理者権限の悪用。認証情報の保管方法、MFA、特権アクセス管理、接続経路の制限が論点。
  • STA/GRC(サプライチェーンの管理、透明性、説明責任/ガバナンス、リスク、コンプライアンス):再委託先を含む関係者の把握、契約上のセキュリティ要求、SSRMに基づく責任分担、業務終了時の確認プロセス。
  • LOG/UEM/SEF/BCR/I&S:正規アカウント悪用の検知(LOG)、侵入の起点となった端末の管理(UEM)、インシデント対応と証拠保全(SEF)、バックアップを含む復旧(BCR)、仮想化基盤の保護(I&S)。被害の検知・拡大防止・復旧を評価する補完領域。

7.3 委託元組織にとっての示唆

本件は、外部事業者にシステムの構築・運用を委託する多くの組織に共通する課題を示している。委託元として、少なくとも次の点を確認することが望ましい。

  • 委託先・再委託先が、自組織のどのデータと認証情報を、どこに、いつまで保持しているかを把握しているか。
  • 業務やプロジェクトの終了時に、データの削除・返却、アカウントの停止、認証情報の変更を確認し、証跡を残しているか。
  • 委託先が使う管理者アカウントに、MFA、利用時間・接続元の制限、操作の記録・監視を適用しているか。
  • バックアップが本番環境と同じ認証情報・管理経路で破壊されないよう、分離やイミュータブルの措置をとり、復旧を検証しているか。
  • インシデント発生時に、委託先・再委託先からの報告、証拠保全、本人への通知までの役割分担が契約・手順で決まっているか。

7.4 今後の分析の方向性

今後、より詳細な分析を行う場合は、CCM v4.1.0 日本語版の個別管理策の記述(管理策、実装ガイドライン、監査ガイドライン、CAIQ)と照合し、各管理策について「適用主体」「実施主体」「確認主体」「必要な証跡」「公表資料で確認できる事実」を整理する。

第6報の時点では、MFAの適用状況、ストレージのサービスモデルや契約関係、各主体の責任分担など、評価に必要な情報の多くが公表されていない。このため、現時点で公表資料から個別の管理策を不適合として対応付けることは避け、大学や関係事業者の今後の公表内容を踏まえて分析を更新する。

参考資料

注記:CCM v4.1.0は17ドメイン・207管理策で構成される。本資料のドメイン名・用語(管理策、クラウドサービス利用者、セキュリティ責任共有モデル等)は、CCM v4.1.0 日本語版の訳語に基づく。v4.0のIVS(Infrastructure & Virtualization Security)は、v4.1.0ではI&S(インフラストラクチャセキュリティ)として整理されており、仮想化セキュリティもI&S-01等の管理策に含まれる。個別管理策の番号・文言は、同日本語版の「CCM_V41」シート等を参照すること(Introductory Guidanceには旧番号表記が残る箇所がある)。

以上

日本のIaaS/PaaS事業者への問題提起 ~ 重大脅威の傾向は国内インフラ事業者にも当てはまるか ― IDCFクラウドとお名前.com デスクトップクラウドの事案から

2026年10月29日
ガイダンスWGリーダー 諸角昌宏

本ブログは、CSAジャパンとしての正式な見解ではなく、あくまで筆者の個人的な意見としてまとめたものである。しかしながら、この問題はクラウドセキュリティに関わる人に幅広く関係することとして、このCSAジャパン・ブログに掲載させていただく。皆さんの屈託のないご意見をいただければ幸いである。

要旨

2026年10月の2件の事案は、事業者起因の脅威が重大脅威の上位から外れたという傾向が、日本の国内IaaS/PaaS事業者にはそのまま当てはまらない可能性を示した。どちらも、利用者の設定ミスではなく、事業者側のシステムに起因する侵害である。

  • CSAの重大脅威調査では、2019年以降、事業者の責任範囲の脅威は順位を下げ、設定ミスやIAMなど利用者側の脅威が上位を占めている。また、主戦場はSaaSに移っている。
  • IDCFクラウドでは、顧客向けポータルの認証システム(OSS)の脆弱性から管理コンソールを経て仮想化基盤の管理者権限が奪われ、495の企業・自治体の仮想サーバーが暗号化された。事業者が管理する共通管理基盤が破られた事案である。
  • お名前.com デスクトップクラウドでは、GMOが自社システムのセキュリティ上の問題を認め、顧客情報の外部持ち出しを確認したと公表した。不正プログラムが確認されたのは一部の顧客の環境で、全プランの停止は被害拡大防止のための措置である。侵入経路と破られた層は公表されていない。
  • クラウド環境における責任範囲として「ゲストOSから上は利用者」とする分担は、事業者が共通管理基盤を守り切ることを前提とする。その前提が崩れると、利用者側の対策では防ぎきれない。

このブログが扱う事案はIaaSとVPSだが、PaaSも事業者の管理基盤の上で提供されるため、管理基盤に関する論点は同様に当てはまる。このブログは、管理プレーンの到達性と分離、特権の持ち方、外部部品の脆弱性管理、共通要素の個別化、復旧手段の分離と既定値、透明性と第三者保証の範囲、下流への説明責任の7点を、国内インフラ事業者への問いとして整理する。

1. 前提:CSA重大脅威の推移

CSAの重大脅威調査は、2019年版以降「事業者起因の脅威は重要度を下げ、利用者起因の脅威が中心になった」という傾向を一貫して示している。CSAジャパンの日本語資料集の14「重大脅威関連資料」に、各版の日本語訳が掲載されている。

版上位の脅威事業者起因の脅威の扱い
2019年版(11の悪質な脅威)1位 データ侵害、2位 設定ミスDoS、共有技術の脆弱性、事業者によるデータ消失などが順位を下げた
2022年版(パンデミックイレブン)1位 IAM同じ傾向が継続
2024年版1位 設定ミスと不十分な変更管理、2位 IAM、3位 安全でないインターフェースとAPICSAは事業者に関わる従来型の課題が引き続き重要度を下げていると説明

あわせてCSAジャパンの資料集では、SaaSセキュリティの調査やガバナンス資料が続けて公開され、関心の重心はSaaSに移っている。

ただし、この調査は専門家へのアンケートに基づく世界的な傾向である。国内の中堅インフラ事業者にもそのまま当てはまるかどうかは、この傾向からは分からない。

2. 逆行する2つの事案

2件とも、利用者の設定ではなく事業者側のシステムの問題が原因であり、多数の利用者がサービスを使えなくなった。

項目IDCFクラウド(IDCフロンティア)お名前.com デスクトップクラウド(GMOインターネット)
サービスの性格汎用IaaS(仮想サーバー、RDB等)Windows ServerのVMを1利用者1台割り当てるWindows VPS相当
侵入経路顧客向け「IDCFクラウドポータル」の認証システムで使うOSSの脆弱性 → 管理コンソール経由で仮想化基盤の管理者権限を取得(第7報)未公表。GMOは「システムにセキュリティ上の問題が存在」したとする(第4報)。攻撃者は「全VM共通の管理者アカウント」などを突いたと主張(未確認)
破られた層顧客向けの入口から管理コンソールを経て、ハイパーバイザー管理へ未公表
確認された被害東日本リージョン1の4ゾーン、495の企業・自治体の仮想サーバーが停止・暗号化。最大71社の登録情報への不正照会一部の顧客のサーバー環境で不正プログラムの設置を確認(第1報)。顧客情報の外部持ち出しを確認(第4報。情報の種類と件数は未公表)
予防的な措置全リージョンのポータルを停止し、外部とのネットワークを遮断被害拡大防止のため全プランを停止(第1報)。影響の可能性があるサーバーは26,739件(第2報)
下流への波及メール配信事業者等を経由し、JR各社、自治体、物流など利用者のその先の顧客まで停止や漏えい可能性の公表が相次いだVM内に保存されたFX口座のログイン情報が不正利用された可能性
復旧従来環境での復旧は困難。スナップショット機能の利用者194顧客のバックアップ取り出しが可能と判明し(第5報)、その後206顧客に増えた(第7報)現行基盤をそのまま再開せず、独立したクラウド基盤上の代替サービスへの移行を案内(第4報)
事業者の認識自社開発部分には脆弱性診断ツールを使っていたが、外部のソフトウェアには適用していなかった(NHK報道)社内のホワイトハッカーが事前に課題を指摘していたが、対応の深さと速さが十分でなかったとGMOグループ代表が説明(代表ブログ、報道経由)

IDCFの第7報は、再開に向けてポータルへの接続を顧客IPアドレスに制限し、多要素認証を必須化し、認証システムを外部IdPに刷新するとしている。裏返せば、事案前のポータルはインターネットの任意の送信元から到達でき、多要素認証も必須ではなかったと読める。

出典:IDCFは第5報、第7報、piyologのまとめ。GMOは第1報、第2報、第4報、週刊アスキーの報道。

3. 共通管理基盤が破られるとき

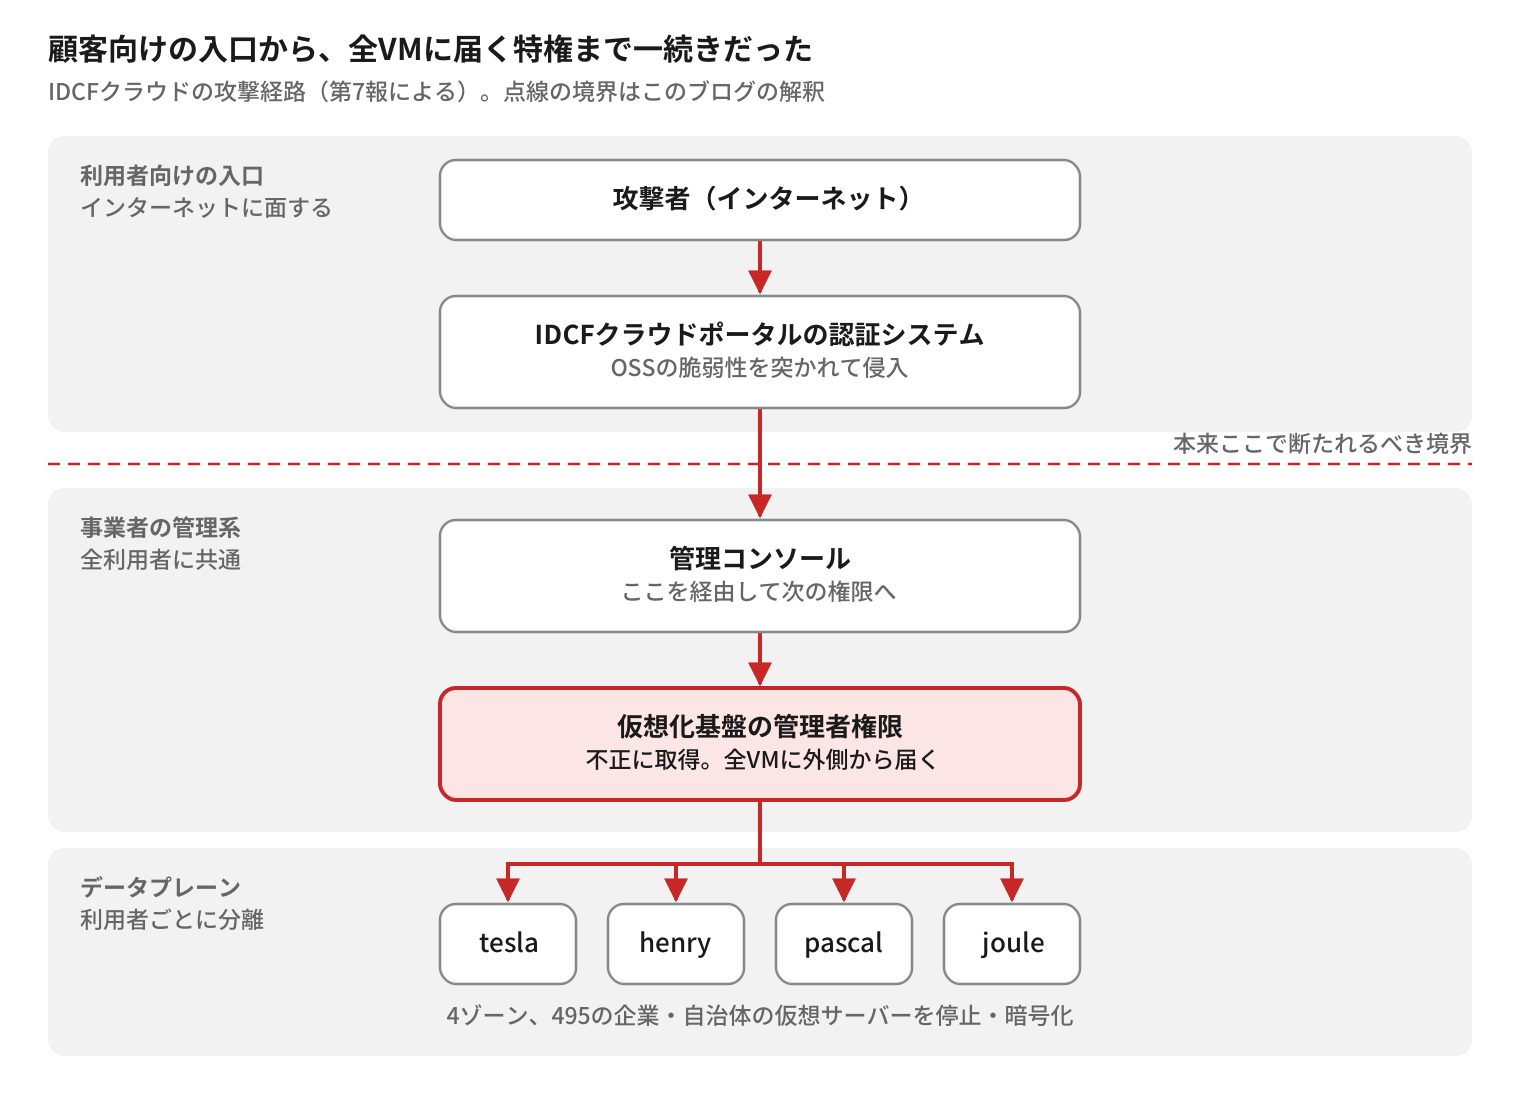
IDCFでは、顧客向けの入口から全利用者に届く特権まで攻撃経路がつながっており、経路の上で分離が実効力を失っていた。分離の欠落がネットワーク、認証、権限のどこにあったかは公表されていない。

利用者向けの入口を破った攻撃者が、事業者の管理系を経て、全VMに外側から届く権限に達した。点線は、本来そこで経路が断たれるべき境界である。

このブログでは共通管理基盤を、次の3つのプレーンと共通要素で捉える。

層誰の操作を受け付けるか範囲侵害されたとき
コントロールプレーン(顧客ポータル、API)利用者画面は利用者ごと、裏の仕組みは全体共通認可不備で他人のリソースを操作される
マネジメントプレーン(運用者の管理系)事業者の運用者全体共通特権で全VMに届く
ハイパーバイザー・共通テンプレート—全体共通VMの外側からディスクや実行に届く
データプレーン(各VM)利用者利用者ごとに分離その利用者だけ

IDCFでは、利用者向けの入口(コントロールプレーン側)を突破した攻撃者が、管理コンソールを経てハイパーバイザーの管理者権限に到達した。つまり、利用者向けの入口から運用者級の特権まで、一続きの経路が存在していた。第7報はこの「管理コンソール」が運用者用かどうか、どのネットワークに置かれていたかを明示していない。

GMOでは、破られたのがどの層かは公表されていない。全プランの停止は被害拡大を防ぐための措置で、不正プログラムが確認されたのは一部の顧客の環境である。共通管理基盤や共通要素が使われたかどうかは、現時点では分からない。

IDCFでは「各利用者の環境は分離されているが、それを束ねる管理層は一つ」という構造が、そのまま影響範囲(blast radius)になった。管理層への到達経路を絞り、権限をゾーンやセル単位に分けることが、事業者にしかできない対策である。

4. 責任共有モデルの前提が崩れるとき

なお、ここでは責任共有モデルを、事業者と利用者がどこまでを担うかという責任境界の観点から扱う。責任共有モデルには、事業者が機能や情報を公開し、利用者がそれを使って検証するという面もある。この面については、第5章の論点6(透明性と第三者保証の範囲)と第6章の調達時の確認で取り上げる。

「VM内は利用者の責任」という分担は、事業者が共通管理基盤を適切に管理することを前提とする。共通管理基盤が侵害されると、利用者がVM内で行える対策だけでは防ぎきれない場合がある。

  • IDCF: 攻撃者はハイパーバイザー側から仮想サーバーを停止し、仮想サーバー自体を暗号化した。ゲストOSのパッチ、EDR、パスワード管理をどれだけ徹底しても、VMの外側からの暗号化は防げない。
  • GMO: 自動売買を無人で動かすには、口座のログイン情報をVM内に保存せざるを得ない。事業者側のシステムが破られれば、この情報を利用者が守る手段はほぼない。

利用者にできるのは、侵入を防ぐことではなく、被害を小さくすることである。管理基盤から独立したバックアップ、別の基盤での再構築手順、口座側の多要素認証や出金制限がこれに当たる。IDCFの事案では、シックス・アパートが別基盤(Google Cloud)に置いていたバックアップで翌日中に暫定移行を終え(同社第3報)、サイバー大学も独自に取得していたバックアップで別基盤に再構築した(同大学第3報)。

ここから導かれるのは、責任共有モデルを「利用者はここから上」という線引きだけで説明することの限界である。線の下を事業者がどう守っているかが示されなければ、利用者は自分の分担を果たしても安全を評価できない。

5. 日本のIaaS/PaaS事業者への問題提起

世界の調査では事業者起因の脅威が重大脅威の上位から外れ、利用者起因の脅威が重大になっている一方で、国内では事業者側のシステムに起因する侵害が1か月に2件起きた。この差を個別の事業者の問題として扱うのではなく、業界全体の課題として次の問いを検証すべきである。

#論点事案で見えたこと事業者への問い
1管理プレーンの到達性と分離IDCF:インターネットに面した顧客ポータルの認証から、ハイパーバイザー管理者権限まで到達できた顧客向けの入口と運用者の管理系は、ネットワークと認証の両方で分離されているか。運用者の管理系はインターネットから到達できないか
2特権の持ち方IDCF:仮想化基盤の管理者権限を奪われた結果、1リージョンの4ゾーンが同時に停止・暗号化された特権はゾーンやセル単位に分け、必要なときだけ付与し、フィッシング耐性のある多要素認証と操作監査をかけているか
3外部部品の脆弱性管理IDCF:診断の対象は自社開発部分で、OSSは対象外だった。再発防止策でSBOM化を挙げた管理基盤を構成するOSSや商用製品を含め、部品を把握して脆弱性情報と突合できているか。公開から悪用までが短くなるAI時代の速度に間に合うか
4共通要素の個別化GMO:攻撃者は全VM共通の管理者アカウントを突いたと主張(未確認)VMイメージの初期アカウント、管理エージェント、接続設定をVMごとに個別化しているか
5復旧手段の分離と既定値IDCF:バックアップの取り出しが可能と判明したのは206顧客。有償バックアップのイミュータブル機能は申請制で、初期状態では無効管理基盤が破られても残る復旧手段を、既定で提供しているか。その分離の程度を利用者に説明しているか
6透明性と第三者保証の範囲両社とも、管理基盤の統制は事案後まで利用者から見えなかった管理プレーンの統制をCAIQやSTAR、ISMAPなどで開示し、監査の範囲に含めているか
7下流への説明責任IDCF:利用者の公表が事業者の第1報より先行した。利用者のその先の顧客まで漏えい可能性の公表を強いられた利用者が自らの顧客へ説明できる速さと粒度で、情報を出せる体制があるか

ここで問うべきは、個別の対策の有無よりも、事業者起因の脅威を「重大ではない」水準に抑えていると、国内事業者が利用者に示せるかどうかである。IDCFは自社サイトでIDCFクラウドを「ソブリンクラウド」として打ち出している。国内事業者の価値が「国内にあること」にあるなら、その信頼は管理基盤の統制で裏付けられている必要がある。

6. 利用者・調達側への示唆

第5章で見たように、事業者起因の脅威が「重大ではない」水準に抑えられているかどうかは、現状では利用者から確かめにくい。事業者がそれを示せるようになるまでは、利用者は、事業者の管理基盤が破られる事態を「想定外」ではなく、設計上の前提として扱う必要がある。あわせて、事業者が示す情報を調達時に確かめることが、利用者の側からできる働きかけになる。

  1. 管理基盤から独立した復旧手段を持つ。 事業者のバックアップサービスでも、別拠点への保管、イミュータブル機能の有効化、論理的な分離といった条件を満たし、本番環境の管理系が破られても消されないものであればよい。条件を満たせない場合は、別の事業者に保管する。いずれの場合も、別基盤での再構築を訓練しておく。
  2. 調達時に管理プレーンを尋ねる。 CAIQでは、IVS-06(区分と分離)、IAM-09・IAM-10(特権の分離と期限付き付与)、IAM-14(強固な認証)が事業者の担当とされているか、実装の説明が記入されているかを確認する。CAIQは自己評価なので、第三者監査の報告書で、監査の範囲に顧客ポータルや運用者の管理系などの管理基盤が含まれているかも確認する。第5章の問いは、CAIQで足りない部分を補う追加質問として使える。
  3. 委託先のその先を把握する。 IDCFの事案では、メール配信などの委託先がIDCFを使っていたことを、多くの利用企業が事案後に知ったとみられる。
  4. 認証情報はできるだけVMに保存しない。 パスワード、APIキー、外部サービスや取引口座のログイン情報などは、VM内に保存しないことが望ましい。管理基盤が破られると、VM内の情報は外側から読み取られうるためである。自動売買のように保存せざるを得ない場合は、その情報が盗まれてもできることを、接続先のサービス側で絞っておく(権限の分離、接続元IPの制限、出金先の固定など)。

SaaSが主戦場であることに変わりはない。ただし国内SaaSには国内IaaSの上で動くものも少なくなく、IaaSの管理基盤の侵害はそのままSaaSの停止として現れる。今回のIDCFの事案がその実例である。

7. まとめ

CSAの重大脅威調査が示すのは、事業者起因の脅威がなくなったことではない。脅威としては残っているが重大度の上位から外れ、相対的に利用者起因の脅威が重大になった、ということである。2026年10月のIDCFクラウドとお名前.com デスクトップクラウドの事案は、この傾向が日本の国内IaaS/PaaS事業者にもそのまま当てはまるかを問い直している。

2件に共通するのは、利用者の設定ではなく事業者側のシステムの問題が原因だったことである。IDCFでは、利用者ごとに分離された環境を束ねる共通管理基盤が破られ、多数の利用者に一斉に影響が及んだ。共通管理基盤が侵害されると、利用者がVM内で行える対策だけでは防ぎきれない。クラウド環境における責任範囲として「VM内は利用者の責任」とする分担は、事業者が共通管理基盤を適切に管理することを前提としている。

国内事業者に求められるのは、この前提が成り立っていることを利用者に示すことである。具体的には、管理プレーンの分離と到達経路の制限、特権の分割、外部部品を含む脆弱性管理、共通要素の個別化、管理基盤から独立した復旧手段、そして管理基盤の統制の開示である。

利用者と調達側は、事業者の管理基盤が破られる事態を設計上の前提として扱い、復旧手段の独立性と管理基盤の統制を調達時に確認する必要がある。主戦場がSaaSに移った今も、その足元にあるインフラの管理基盤は、事業者と利用者の双方が改めて点検すべき対象である。

付録:事実関係の確度

このブログの記述区分根拠
ポータル認証システム(OSS)の脆弱性 → 管理コンソール → 仮想化基盤の管理者権限公式に確認済みIDCF第7報
IDCFがOSSを脆弱性診断の対象にしていなかった報道NHK(piyolog経由)。第7報の再発防止策(診断対象をOSSに拡大)と整合
IDCFでバックアップの取り出しが可能と判明したのは206顧客公式に確認済みIDCF第5報(194顧客)、第7報(206顧客)。取り出し可能と判明した数で、復旧が完了した数ではない
GMOで不正プログラムが確認されたのは一部の顧客の環境。全プラン停止は被害拡大防止の措置公式に確認済みGMO第1報
GMOで顧客情報の外部持ち出しを確認公式に確認済みGMO第4報。情報の種類と件数は未公表
GMOが独立したクラウド基盤上の代替サービスへの移行を案内公式に確認済みGMO第4報
GMOで社内から事前に課題が指摘されていた代表の説明熊谷代表のブログ(10月25日)。週刊アスキーの報道経由で確認
GMOの侵入経路、破られた層未公表GMOは「システムにセキュリティ上の問題が存在」とするのみ
攻撃者の主張(IDCF:7分で暗号化、239台のハイパーバイザー等。GMO:全VM共通の管理者アカウント等)未確認いずれも事業者は裏付けていない。本文では数字を根拠に使っていない
IDCFバックアップのイミュータブル機能は申請制で初期無効公式文書筆者が以前に確認したサービス範囲記述書。今回は再確認していない
重大脅威の傾向が国内事業者にもそのまま当てはまるとは限らない仮説2件の事案からの問題提起。業界全体を比較したデータはない

出典

CSA・CCM/CAIQ

IDCFクラウド

お名前.com デスクトップクラウド

以上

お名前.com デスクトップクラウド ~ クラウドサービスとしての位置づけと責任分界の整理

2026年10月28日
ガイダンスWGリーダー 諸角昌宏

本ブログは、CSAジャパンとしての正式な見解ではなく、あくまで筆者の個人的な意見としてまとめたものである。しかしながら、この問題はクラウドセキュリティに関わる人に幅広く関係することとして、このCSAジャパン・ブログに掲載させていただく。皆さんの屈託のないご意見をいただければ幸いである。

本ブログの位置づけ

2026年10月、GMOが提供する「お名前.com デスクトップクラウド」(以下「本サービス」)において、不正アクセスが公表された[10]。「クラウド」という名称を付けていることもあり、クラウドセキュリティの観点からそもそもどのようなサービスモデルなのか、また、責任範囲は事業者と利用者でどうなるのかを考えてみたい。そこで、公開されている告知等をもとに、本サービスの構造とセキュリティ上の責任分界を技術面から整理してみる(2026年10月27日時点の公開情報にもとづく)。なお、利用規約の条文は確認しておらず、契約上の責任を確定するものではない。このため、本ブログでいう「責任」「管理範囲」は、各層を誰が設定・運用・保護する立場にあるかという技術面での分担を指し、契約上の義務や法的な賠償責任を意味しない。

本ブログで用いる用語と表記は次のとおりとする。

  • 共通管理基盤:事業者が全VMに対して特権的に操作できる仕組みと、全VMに共通して配布・適用される要素の総称。本ブログでは、マネジメントプレーン、コントロールプレーン、ハイパーバイザー、全VM共通のVMイメージ、管理エージェント(存在する場合)を含む(3章)。
  • 利用者:本サービスの契約者。
  • 根拠の表記:本文中の[番号]は巻末の出典に対応する。番号のない記述は一般論または本書の想定である。

要点

  • 位置づけ:本サービスは、確認できる範囲では1利用者に1台のWindows Server VMを割り当て、リモートデスクトップで操作する形態であり、「仮想デスクトップ用途向けのWindows VPSに近いサービス」と整理できる(1章)。
  • 責任分界:物理基盤と共通管理基盤は事業者、ゲストOSやMT4の更新の適用、EA、保存した認証情報、データは利用者が担うと整理できる。このうち緊急のセキュリティ更新の適用とOS提供終了時の再インストールは、告知で利用者に求められている(2章)。
  • 前提:この分担は、事業者が共通管理基盤を適切に管理していることを前提とする。共通管理基盤が侵害されるとVM内の対策は迂回されうるため、この前提が成り立たなくなり、被害を抑える手段は取引口座側の対策が中心になる(3章)。

1. 「お名前.com デスクトップクラウド」のクラウドサービスとしての位置づけ

「お名前.com デスクトップクラウド」はGMOの商品名であり、VDIやDaaSのような技術・提供形態の分類用語ではない。分類を検討する際は名称だけでなく、提供機能、管理機能、利用者が管理する範囲を確認する必要がある。

確認できる範囲では、本サービスは1利用者に1台のWindows Server VMを割り当て、利用者がリモートデスクトップで接続して操作する[1][3]。GMOは料金改定の告知で本サービスを「FX専用VPS」と表記しており[3]、緊急のセキュリティ更新の適用[8]やOS提供終了時の再インストール[9]は利用者に求められている(詳細は2.1、2.2)。本ブログでは、これらの特徴をもとに、本サービスがクラウドのサービスモデルの中でどこに位置づけられるかを整理する。

1.1 用語の整理

用語意味
VDIデスクトップ環境をサーバー上の仮想マシンで動かし、手元の端末から画面を操作する技術・仕組み。オンプレミスでも構築でき、それ自体はクラウドとは限らない
DaaSVDIを事業者がサービスとして提供する形態(Azure Virtual Desktop、Windows 365、Amazon WorkSpacesなど)
VPS事業者の物理サーバー上の仮想マシンを1台単位で貸すサービス。用途は利用者次第
IaaS仮想マシン、ネットワーク、ストレージなどのインフラをサービスとして提供する形態(AWS、Azure、GCPなど)
SaaSアプリケーションの機能をサービスとして提供する形態。利用者はOSに触れない

1.2 VDI・DaaSとSaaSの関係

VDIはデスクトップ環境を仮想化して利用する技術・仕組みであり、それ自体がSaaSを意味するわけではない。クラウドでデスクトップ環境をサービス提供する形態は一般にDaaSと呼ばれる。IaaS・DaaS・SaaSの一般的な責任分界は下表のとおりである。ただし、責任分界はサービスごとに異なり、DaaSだからOS管理を一律に利用者が担う、または事業者が担うとは限らない。利用する際に、責任範囲を明確にすることが必要である。

層IaaSDaaS(典型的)SaaS
物理基盤・仮想化基盤事業者事業者事業者
接続の仲介・認証ゲートウェイ利用者が構成(部品は事業者が提供)事業者事業者
デスクトップのOS・パッチ利用者製品により事業者か利用者事業者
アプリ・データ・アカウント管理利用者利用者利用者(データとアカウント)

1.3 VPSとDaaSの違い

DaaSには一般に、接続仲介、利用者・セッション管理、イメージ管理、コピー&ペーストや印刷等の制御機能が含まれることがある。ただし、機能の有無は製品・サービスによって異なる。Windows VPSにRDPで接続する形態は見た目がデスクトップサービスに似ていても、管理機能や責任分界が同一とは限らない。

1.4 VPSとIaaSの関係

VPSとIaaSは、仮想マシンを借りて利用者がOSから上を管理する点で共通する。IaaSではAPI、仮想ネットワーク、ロードバランサー、マネージドDB、IAM、監査ログ、鍵管理等の機能が提供されることが多い。これらは一般的な傾向であり、VPSとIaaSの境界は事業者およびサービスによって異なる。

1.5 「お名前.com デスクトップクラウド」はクラウドか(NISTの定義との照合)

NIST SP 800-145[11]はクラウドの必須の特徴を5つ挙げている。公開情報で確認できる範囲で本サービスを当てはめると次のようになる。

NISTの特徴内容本サービス(公開情報上)
オンデマンド・セルフサービス事業者とやりとりせず、利用者が自分でリソースを用意できる一部確認できる(OS再インストールを利用者がコントロールパネルから行える[9]。申し込み、起動・停止は未確認)
幅広いネットワークアクセスネットワーク経由で様々な端末から使える満たす(PC・タブレット・スマートフォンから接続できる[3])
リソースプール複数の利用者で物理リソースを共有し、動的に割り当てる共有はうかがえる(サーバーの収容効率に触れた告知がある[2])が、動的な割り当ては未確認
迅速な弾力性必要に応じて素早く拡大・縮小できる。場合によっては自動で未確認(プラン変更の可否、即時性、自動化の有無を確認していない)
計測可能なサービスリソースの使用量を計測し、管理・報告できる未確認(料金は契約期間ごとの定額[5]。使用量の計測・報告機能は確認できない)

未確認の項目があるため、公開情報だけでは本サービスがNISTの定義を満たすかどうかは判定できない。ただし、迅速な弾力性は自動であることを必須とせず、計測可能なサービスも従量課金そのものを求めていないため、仮にこれらが限定的であっても、それだけで直ちに定義から外れるわけではない。VPSとクラウドの関係はグレーゾーンにあり、実務上の区別は、定義から外れるかどうかより、弾力性・API・周辺サービスの充実度の差によるところが大きい。

1.6 本サービスの位置づけ

  • GMO自身が料金改定の告知で「FX専用VPS」と表記している[3]。
  • DaaSに一般にみられる管理機能(接続の仲介、組織アカウントとの連携、イメージの一括管理等)は、公開情報からは確認できない。緊急のセキュリティ更新の適用[8]や、OS提供終了時の再インストール[9]は利用者に求められている。
  • 以上から、本ブログでは「お名前.com デスクトップクラウド」は「仮想デスクトップ用途向けのWindows VPSに近いサービス」と整理する。

2. 「お名前.com デスクトップクラウド」の責任分界

2.1 サービスのアーキテクチャ

  • 提供形態:GMOインターネットが保有するデータセンター内のサーバー上に仮想のWindowsデスクトップを構築し、PC・タブレット・スマートフォンからリモートデスクトップで接続する[3]。
  • 割り当て方式:1VMを1利用者に割り当てる[1]。複数の利用者で1台のOSを共有する形態ではない。
  • OS・ストレージ:2019年のリニューアルで全プランがSSD、OSはWindows Server 2019となった[2]。その後、2020年3月に「for MT4 ver2.0」、2021年8月に「デスクトップクラウド」が提供開始され[4]、2024年5月には新プランに改められた[5]。現行プランのOSは本ブログでは確認できていない。
  • プラン:2019年のリニューアルでFX自動売買向けの「for MT4」が設けられた[2]。ビジネス向けの「for Biz」は2020年3月5日以降の申込分からグローバルIPが標準となった[3][12]。for MT4とfor Bizはいずれも新規受付を終了しており[6][12]、2024年5月30日以降はメモリ容量別の新プラン(StartUp・Standard・Premium)が提供されている[5]。2024年10月にはオプションの「高負荷通知サービス」にMT4/MT5の稼働監視機能が追加されており[7]、MT4/MT5での利用が想定されている。
  • 管理系:契約管理のお名前.com Naviと、VMを操作するコントロールパネル。利用者がコントロールパネルからOSを再インストールできることは告知で確認できる[9]。起動・停止などその他の機能は本ブログでは確認できていない。
  • 接続方法:リモートデスクトップ(RDP)で接続する。接続時のドライブ共有等の既定設定は公開情報からは確認できない。

注意:提供形態と割り当て方式の根拠は2012年〜2020年の記事・告知であり、2024年5月の新プラン以降も同じ形態かは確認できていない。ハイパーバイザーの種類、ネットワーク分離方式、ディスク暗号化の有無など、内部構成の詳細は公開されていない。

2.2 セキュリティの責任分界

下表の「根拠」列は、告知等で確認できるものを「告知あり」、一般的な考え方から本ブログが想定したものを「想定」、想定のうち一部の場面だけ告知で確認できるものを「想定(一部告知あり)」とする。対象が2019年版のプランに限られる行は、項目名にその旨を記した。

レイヤー主な管理範囲根拠補足
物理DC・ハードウェア・ネットワークGMO告知ありGMOインターネットが保有するデータセンターで運用[3]
共通管理基盤(3章)GMO想定利用者からは直接管理・監視できない層
VMの初期イメージ(共通テンプレート)GMO想定全VM共通の初期設定(初期アカウント、接続設定等)。不備があれば全VMに影響しうる
ゲストOS(Windows Server)の緊急のセキュリティ更新の適用利用者告知あり2019年8月の告知で、緊急度の高い脆弱性について、利用者にWindows Updateによる早急な適用を求めている[8]
ゲストOSの通常の更新利用者想定通常時の更新について告知は確認していない。管理者権限を持つ利用者がVM内で行う運用と想定
OSの提供終了への対応利用者(一部は事業者)告知あり2022年12月の告知で、提供終了までに利用者自身がコントロールパネルからOSを再インストールするよう求めている。別途、事業者側でサーバー移行を行う場合もある[9]
MT4のプリインストール(2019年版for MT4)GMO告知あり主要FX会社4社のMT4をプリインストールして提供[2]。新プランでの扱いは未確認
MT4本体の脆弱性修正・更新版の提供FX会社・MetaQuotes社想定MT4はMetaQuotes社が開発[2]。各FX会社が自社向けに配布する形が一般的
VM上のMT4への更新の適用利用者想定更新版をVM上で適用・再起動する運用は利用者が管理すると想定(プリインストール版を含む)
EAの選択・導入・設定・運用利用者想定EAは利用者が自分で導入する
取引口座のログイン情報の保存・管理利用者想定無人で自動再開させる運用では、VM内に保存せざるを得ないことが多い
データのバックアップ利用者想定(一部告知あり)OS再インストール時は、必要なデータを利用者が事前に保存するよう求められている[9]
接続元の端末(PC・スマートフォン)利用者想定端末自体の保護は利用者。ただし、事業者が提供した接続設定を通じて端末に被害が及んだ場合は、この整理がそのまま当てはまらない可能性がある

注意:2019年版のライトプランは、ブラウザや他のアプリのインストール機能を省き、MT4の稼働に機能を絞っていた[2]。これは製品仕様であり、上表には含めていない。

2.3 VPSとIaaSのセキュリティ上の違い

責任分界の基本はどちらも同じで、違いは利用者が使える防御の道具の多さと、事業者の透明性に出てくる。下表は一般的な傾向であり、本サービスの実装を確認したものではない。VPSでも二段階認証やパケットフィルターを備えるものはある。

観点VPS(一般的な傾向)IaaS(AWS・Azure・GCPなど)
管理画面へのログインID・パスワードのみ、または簡易的な二段階認証MFAを強制できる、SSO連携、細かい権限設定(IAM)
権限の分割契約者アカウント1つでほぼ全権限人・用途ごとに最小権限を付与できる
ネットワーク制御簡易なファイアウォール、またはなし。RDP/SSHが直接公開されがちVPC、セキュリティグループ、プライベートサブネット、踏み台・VPN経由
監査ログ利用者が見られる操作ログはないか限定的利用者側の管理操作ログ(CloudTrailなど)、フローログ
暗号化・鍵管理事業者任せで利用者から見えないことが多いディスク暗号化、利用者管理の鍵(KMS)
秘密情報の保管専用サービスは標準で付かず、VM内のファイルに置く運用になりがち(外部の秘密情報管理サービスをAPIで呼ぶ構成は可能)Secrets Managerなどの専用サービス
物理的な分離共有ホストが中心専有ホスト・専有インスタンスを選べる
事業者の透明性内部構成や第三者認証の情報が少ない責任共有モデル、SOC 2・ISO認証、文書を公開

注意:

  • IaaSが常に安全というわけではない。機能が多いぶん設定ミス(ストレージの誤公開、アクセスキーの流出など)が起きやすい。
  • 事業者側の共通管理基盤が侵害されることは、VPSでもIaaSでも起こりうる。ただし、発生の確率や影響範囲が同じとは限らない。
  • IaaSの監査ログに残るのは主に利用者側の操作であり、事業者内部の管理基盤やハイパーバイザーの侵害は利用者のログに残らないことが多い。共通管理基盤の侵害については、VPSでもIaaSでも、事業者の調査と公表に頼る部分が大きい。

3. 共通管理基盤の構造と、侵害されたときに起きること

2章の責任分界は、事業者が共通管理基盤を適切に管理していることを前提に成り立つ。本章では、共通管理基盤の構造と、それが侵害されたときに何が起きるかを整理する。

本ブログでは、ネットワーク機器の3プレーンの考え方を借りて共通管理基盤を整理する。なお、ここでの定義は、SDNでの定義(RFC 7426)とは一致せず、クラウド事業者の用法に近い。以下はGMOの実際の内部構成を示すものではなく、各要素の存在・配置は公開情報から確認できない。

3.1 本ブログでのプレーンの定義

プレーン本書での定義本サービスでの例(一般論、実構成未確認)範囲
マネジメントプレーン事業者の運用者が、設定・監視・保守のために基盤へアクセスする経路運用者用管理画面、保守用ログイン、監視基盤、運用アカウント全体共通
コントロールプレーン利用者や管理画面からの指示を受け、VMの作成・停止・再インストール等を実行する仕組みコントロールパネルの裏側で動くAPIやオーケストレーション全体共通(画面は利用者ごと)
データプレーン実際の処理や通信各VM、Windows、MT4、RDPの通信利用者ごとに分離

マネジメントプレーンとコントロールプレーンの違いは、誰の操作を受け付ける経路かにある。前者は事業者の運用者、後者は利用者(およびその指示を受ける管理画面)の操作を受け付ける。クラウド事業者の用語は揺れており、AWSはリソース操作API群を「コントロールプレーン」と呼び、Azureは「管理レイヤー」とも説明するが、本書では上記の定義で用いる。

3.2 プレーン以外の共通要素

  • ハイパーバイザー:VMを実行する基盤層。プレーンではないが、全VMに対して特権を持つため、共通管理基盤に含める。
  • VMの初期イメージ:全VMに共通して配布される初期設定(初期アカウント、接続設定、導入済みソフトウェア)。操作する仕組みではないが、不備があれば全VMに同じ弱点が及ぶため、共通管理基盤に含める。
  • 管理エージェント(存在する場合):VM内で動き、管理側からの指示を受ける仕組み。VM内にあっても事業者側の要素とみなす。なお、本サービスでの存在は確認できていない。

3.3 共通管理基盤が侵害される典型的なパターン

  • コントロールプレーンの不具合:利用者向けAPI等の認可不備により、ある利用者が他人のVMを操作できるケース。外部の利用者の立場から攻撃されうる。主な対策は認可設計とAPIの検証。
  • マネジメントプレーンの侵害:運用者アカウントや保守経路が侵害され、VMに特権でアクセスされるケース。主な対策は運用アカウントの多要素認証、保守経路の分離、操作の監査。
  • 共通要素の不備:VMイメージに共通のアカウントや管理エージェントの脆弱性などにより、全VMに同じ弱点が及ぶケース。主な対策はVMごとの認証情報の個別化と、エージェントの更新管理。

いずれも全VMに影響が及びうる点は同じだが、主な対策の方向が異なるため、区別して考える必要がある。

3.4 共通管理基盤が侵害されたときに起きること

共通管理基盤が侵害されると、攻撃者はVMの外側からディスクを読んだり、VM内でプログラムを動かしたりできる場合がある。このとき、VMにログインするためのWindowsパスワード(認証)は迂回される。データを読まれずに済むか(秘匿)は、ディスク暗号化の有無、鍵の置き場所、VMが稼働中かどうかで変わる。鍵を事業者が管理している場合や、稼働中のVMに入り込まれた場合は、暗号化があっても防げないことがある。本サービスのディスク暗号化の状況は公開されていない。

自動売買に使う取引口座のログイン情報は、無人で自動再開させる運用ではVM内に保存せざるを得ないことが多く、侵害時のリスクになる。

「VM内は利用者の責任」という一般的な分担は、事業者が共通管理基盤を適切に管理することを前提とする。共通管理基盤が侵害されると、利用者がVM内で行える対策だけでは防ぎきれない場合がある。また、RDP接続時にドライブやクリップボードを共有していると、VMが侵害された場合に接続元端末へ影響が及ぶ経路になりうる。

3.5 利用者への注意事項

共通管理基盤が侵害されうることを踏まえ、本サービス(および同種のWindows VPS)を利用する際の注意事項を整理する。

3.5.1 管理者としての認識

  • 管理する立場であることを認識する:GMOは告知のサービス説明で、本サービスを「面倒な設定などは不要」で「ハイスペックなセカンドパソコン」として使えると案内している[3]。一方で、緊急のセキュリティ更新の適用やOS提供終了時の再インストールは利用者に求められており[8][9]、利用者はWindowsサーバーを管理する立場にある。通常の更新、MT4・EAの更新の適用、保存した認証情報、データのバックアップも、利用者の管理範囲と想定される(2.2)。
  • 事業者の告知を確認する:脆弱性への対応やOSの提供終了など、利用者の作業を求める告知が出されることがある[8][9]。登録メールアドレスへの連絡や公式サイトの告知を確認する。
  • VMに置くものを絞る:共通管理基盤が侵害されるとVM内の対策は迂回されうるため、「VMに置いたものは読まれうる」と考え、VMに置く認証情報やファイルを必要最小限にする。

3.5.2 取引口座の対策(FX会社が提供している場合)

注意:以下は各FX会社の提供機能に左右される。二段階認証、IP制限、取引用と出金用の認証の分離を提供していない会社もある。

  • 口座の保護機能を使う:二段階認証、ログイン元IPの制限、ログイン通知、出金先の固定を設定する。
  • 権限を分ける:取引用と出金用で認証を分けられる場合は、出金用の認証をVMに置かない。
  • 資金を絞る:自動売買口座には必要な証拠金だけを入れる。
  • 異常に早く気づく:約定通知やログイン通知をVMとは別の端末で受け取る。
  • Web画面のセッションも切る:FX会社の会員ページ・口座管理画面では、パスワードを変えても既存のログインセッションが残る場合がある。パスワード変更時は全セッションの切断も行う(MT4自体のログインとは別)。

3.5.3 メール・Webアカウントの対策

  • 使い回さない:VMに置いたパスワードを他のサービスで使わない。
  • 連携・転送設定を点検する:心当たりのない連携アプリ、メール転送設定、ブラウザ拡張機能、登録端末がないか定期的に確認する。

3.5.4 接続元端末の対策

  • 共有を絞る:RDP接続ではドライブ・クリップボード等の共有を必要なときだけ有効にする。
  • 端末を分ける:可能であれば、取引・出金に使う端末とVPS接続用の端末を分ける。

3.5.5 異常の検知と契約条件の確認

  • 自分で異常に気づく:共通管理基盤の侵害は、利用者が見られるログには残らないことが多い(2.3)。異常に気づく手段は、取引口座の通知や取引履歴・残高の確認が中心になるため、定期的に確認する。
  • 契約条件を確認する:免責の範囲、補償の条件、データの扱い(解約後のデータ消去を含む)は利用規約で確認する。なお、本ブログは利用規約を確認できていない。別のサービスへ移る場合も、申し込み前に責任分界と条件を確認する。
  • 事故の際は公式の案内で動く:事故が起きた場合は、事業者の公式サイトや登録メールアドレスへの連絡で状況を確認する。パスワードや認証コードを尋ねる連絡、「被害金を取り戻す」などの名目で費用を求める連絡には応じない。

4. まとめ

サービスの位置づけ:公開情報からは「仮想デスクトップ用途向けのWindows VPSに近いサービス」と評価できる。VPSがクラウドにあたるかはNIST SP 800-145の定義に照らしてもグレーゾーンにあり、個々のサービス機能で判断する必要がある。

責任分界:物理基盤と共通管理基盤は事業者、ゲストOSの更新、EAの運用、保存した認証情報、データ等は利用者が担うと整理できる。2019年版for MT4ではMT4のプリインストールにGMOが関与し、MT4の更新版の提供はFX会社・MetaQuotes社、VM上での適用は利用者が担う。

共通管理基盤の侵害:「VM内は利用者の責任」という分担は、事業者が共通管理基盤を適切に管理することを前提とする。共通管理基盤が侵害されるとVM内の対策は迂回されうるため、利用者の管理範囲で防ぐという前提そのものが成り立たなくなる。このとき被害を左右するのは、責任分界ではなく、事業者による共通管理基盤の管理と、取引口座側で被害を抑える対策である。

教訓:利用者は、取引口座の保護機能、権限の分離、資金の限定、別端末での通知確認、接続設定の見直しなどで被害を抑えられる。サービスを選ぶ際は、名称ではなく提供機能、責任分界の明確さ、監査ログの有無、事業者の説明と透明性を確認することが重要である。

出典

  • [1]@IT 2012年10月10日の記事(仮想デスクトップ市場とお名前.com デスクトップクラウドの紹介) https://atmarkit.itmedia.co.jp/ait/spv/1210/10/news008.html
  • [2]お名前.com「お名前.com デスクトップクラウド」フルリニューアルのお知らせ(2019年1月23日) https://www.onamae.com/news/article/10792
  • [3]お名前.com FX専用VPS「お名前.com デスクトップクラウド(for Biz/for MT4)」料金改定のお知らせ(2020年3月5日) https://www.onamae.com/news/article/10780
  • [4]お名前.com デスクトップクラウド 価格改定のお知らせ(2024年3月ご利用分から。対象プランとして「for MT4 ver2.0(2020/3/5提供開始)」「デスクトップクラウド(2021/8/24提供開始)」を記載) https://www.onamae.com/news/article/10738
  • [5]お名前.com デスクトップクラウド 新プラン提供開始のお知らせ(2024年5月30日) https://www.onamae.com/news/article/10734
  • [6]お名前.com 新規受付終了サービス:デスクトップクラウド for MT4 https://www.onamae.com/server/closed/dc2-mt4/
  • [7]お名前.com デスクトップクラウド 高負荷通知サービス機能アップデート(MT4/MT5の稼働監視、2024年10月17日) https://www.onamae.com/news/article/10724
  • [8]お名前.com「Windows Server OSにおける緊急度の高い脆弱性に関するお知らせ」(2019年8月28日) https://www.onamae.com/news/article/11007
  • [9]お名前.com「Windows Server 2008 R2 / 2012 R2 をご利用のお客様へ」(2022年12月22日) https://www.onamae.com/news/article/6293
  • [10]GMOインターネット「第三者による不正アクセスに関するお詫びとお知らせ」(第1報、2026年10月21日) https://www.onamae.com/news/article/11584
  • [11]NIST SP 800-145 The NIST Definition of Cloud Computing https://csrc.nist.gov/pubs/sp/800/145/final
  • [12]お名前.com 新規受付終了サービス:デスクトップクラウド for Biz https://www.onamae.com/server/closed/dc2-biz/

以上

クラウドサービスにおけるバックアップの責任分担と復旧可能性 ~ IDCフロンティアのセキュリティ事故とAWSの契約条件を踏まえた考察

2026年10月28日更新
2026年10月15日更新
2026年10月11日
ガイダンスWGリーダー 諸角昌宏

【第7報反映】IDCフロンティアが公表した第7報では、IDCFクラウドポータルの認証システムで使用されていたオープンソースソフトウェアの脆弱性が悪用され、仮想化基盤の管理者権限が不正取得されたことなど、事故の経緯が明らかにされた。また、バックアップデータを取り出すことが可能とされた利用者数は206に更新された。しかしながら、本ブログの主題であるバックアップの責任分担と復旧可能性という観点では、バックアップデータを取り出せることと、個々の顧客のシステムが正常に復元できたことは区別する必要がある。第7報だけでは、個別の復元結果や、契約上の責任が履行されたかどうかを一律に判断することはできない。このため、第7報は事故に関する事実関係を更新するものではあるが、本ブログの基本的な論旨を変更するものではない。

【第5報反映】改訂箇所の表示:赤色マーカーおよび「【第5報反映】」は、2026年10月14日付第5報を受けた追記・修正を示す。

要旨

【第5報反映】IDCフロンティアの事故では、当初はデータの取り出し・復元が困難とされたが、10月14日付第5報により、影響を受けた495の企業・自治体のうち、スナップショット機能を利用する194の利用者についてバックアップデータを取り出せることが確認された。ただし、復元の可否は引き続き確認中である。

背景

2026年10月、IDCフロンティアが提供するクラウドサービス「IDCFクラウド」において、ランサムウェアによる被害が発生し、一部の顧客の仮想マシンやデータの利用に影響が生じた。この事故は、クラウドサービスにおけるデータ保護やバックアップのあり方、特にクラウドサービスプロバイダ(CSP)とクラウドサービスカスタマ(CSC)の責任分担について、改めて考える契機となる。

クラウドサービスでは、一般に責任共有モデルに基づき、CSPとCSCがそれぞれの責任を負う。しかし、バックアップについては、「クラウドに保存したデータはCSCが自らバックアップしなければならない」という理解がある一方、CSPがバックアップ機能を提供し、その取得・保存・復元処理を実施するサービスも存在する。このため、CSPが提供するバックアップ機能を利用している場合にも、CSCが独立したバックアップを取得する必要があるのか、また、バックアップの取得・保存・復元に関して、CSPとCSCはそれぞれどのような責任を負うのかという点を整理する必要がある。

本ブログでは、IDCフロンティアの事故を検討の契機として、ISO/IEC 27017における責任分担の考え方、IDCフロンティアおよびAWSの公開資料、データ耐久性とバックアップの違いなどを整理し、CSCがバックアップをどのように確保すべきかを考察する。

なお、本ブログは、IDCフロンティアの事故原因、同社のセキュリティ対策の適否、契約違反の有無、法的責任の所在を判断するものではない。事故に関する記述は公開情報に基づくものであり、今後の調査結果によって変更される可能性がある。

注)本ブログでは、ISO/IEC 27017で用いられている用語に従い、クラウドサービスプロバイダを「CSP(Cloud Service Provider)」、クラウドサービスカスタマを「CSC(Cloud Service Customer)」と表記する。なお、契約条件や公表資料からの引用については、原文の表記を維持する。

要旨

CSCが、必ず自らバックアップを取得しなければならないとは言い切れない。CSCは必要なデータ保護要件を定義し、それが満たされるように確保・確認する責任を負う。一方、バックアップ取得・保持・復元の実行は、契約と設定に応じてCSPが担い得る。IDCフロンティアの事故では、複数ゾーンの顧客データの取り出し・復元が困難とされた点が重大であるが、独立した有料バックアップサービスの保存データが失われたか、契約どおりに復元できたかは現時点では未確定である。

1.基本概念:責任と作業の区別

「CSCにバックアップ確保責任がある」ことは「CSCが独自の別システムを構築してバックアップを実行する義務がある」ことと同義ではない。また、CSPにバックアップ処理を委ねても、CSCによる要件定義・契約評価・設定確認の責任が当然に消滅するわけではない。整理すると以下の表になる。

区分意味典型的な担当
要求事項の定義・確保責任保護対象、RPO、RTO、保存期間、攻撃耐性を定め、充足を確認CSC
取得・保存の実施責任設定された計画に基づきバックアップを取得・保持契約・サービス仕様に応じてCSPまたはCSCが実施
バックアップの保護責任削除・改ざん・権限侵害からの保護契約・サービス仕様に応じてCSPとCSCが分担
復旧と検証復元手順、定期試験、代替環境への復旧契約・設定による分担

2. ISO/IEC 27017の要件

ISO/IEC 27017では、CSCに対して以下の2点を要求している(なお、ここの記述はISO/IEC 27017の手引きの記載内容を意訳したものである):

  1. CSPがバックアップ機能を提供している場合、CSCはその仕様を要求することが望ましい。CSCはその仕様が自らの要求事項を満たすことを検証する。
  2. CSPのバックアップ機能がCSCの要求事項を満たさない場合、CSCがバックアップ機能の導入に責任を負う。

これらはCSPによるバックアップ機能の提供を想定し、機能が提供されないあるいは機能が要求事項を満たさない場合のCSCの責任を明確化している。一方、「CSPが機能を提供すればCSPが全責任を負う」と結論することはできない。機能の有無、実際の有効化・取得、保存・復元条件、契約上の役割分担を確認する必要がある。

3.クラウドバックアップの技術要件

クラウドバックアップの技術的な要件は以下のようになる。

観点検証ポイント
保護対象仮想ディスクだけでなく、アプリケーション、データベース、設定、鍵、復元に必要なメタデータを含んでいるか
独立性本番とは別の障害領域、管理権限、可能なら別アカウント・別拠点に分離されているか
耐改ざん性イミュータブル保管、削除防止、保持期間、特権ID侵害時の防御があるか
復旧可能性実際に復元できるか、整合性・RPO・RTOを満たすか、定期試験があるか
責任と透明性バックアップ機能の仕様、除外範囲、前提設定、障害時の制約がCSCに明示されているか

したがって、スナップショットは迅速な復旧に有効だが、管理基盤の侵害から独立していなければ、ランサムウェアに対する十分な復旧手段とは限らない。保存先の物理的分離と、削除・改ざん権限の分離は別の要件である。

4.IDCフロンティアの公開仕様・契約条件

IDCフロンティアの公開情報には、標準IaaSで顧客の責任の下にバックアップ等を行う旨のサービス提供条件がある。また、スナップショット機能と、別拠点のストレージを利用する「IDCFクラウド バックアップ」を区別して提供している。公開FAQでは、スナップショットにはランサムウェア対策がない一方、バックアップサービスにはイミュータブルストレージがあると説明している。

このため、標準IaaSでの顧客のバックアップ確保責任は確認できるが、バックアップサービスを別途契約・設定していた顧客に対するCSPの個別の履行責任は、サービス仕様書・約款・個別契約を併せて検討しなければならない。

なお、IDCフロンティアの契約には、顧客データの消失などによる損害について、同社が賠償責任を負わない旨の免責条項がある。しかし、免責条項が存在するからといって、すべての事故について同社が責任を免れるとは限らない。実際に免責が認められるかどうかは、事故原因、同社の過失の有無や程度、適用される契約条件などによって判断される。特に、故意または重大な過失があった場合には、免責条項の効力が制限される可能性がある。

5.AWSの契約・サービスとの比較

AWS Customer Agreement 第2.3条(Your Security and Backup)は、顧客がサービスを適切に設定・利用し、アカウントと顧客コンテンツの保護・バックアップのため適切な措置を講じる責任を定めている。AWS Backupでは顧客がバックアップ計画・対象等を設定し、AWSがマネージドサービスとして取得・保存・復元機能を提供する。Vault Lock、クロスアカウント・クロスリージョンコピー、復元テスト等の機能もある。

論点IDCフロンティアAWS
標準IaaSのバックアップ確保責任原則として顧客原則として顧客
CSP提供のバックアップスナップショット、別拠点バックアップEBSスナップショット、AWS Backup等
保護機能別拠点・イミュータブル機能(サービス別)Vault Lock等(構成・サービス別)
CSPのサービス履行責任個別仕様・約款の検証が必要契約・サービス条件の検証が必要

AWSであっても顧客による適切な設定や復元試験は重要であり、AWSの機能があること自体は、いかなる事故でもデータが失われないという保証ではない。

6.IDCフロンティア事故:確認事項と未解明事項

公開情報から確認されている事項

【第5報反映】2026年10月7日からの不正アクセスによる障害は、東日本リージョン1のtesla、henry、pascal、jouleの4ゾーンに影響した。当初IDCフロンティアは、対象データの取り出し・復元が困難との見通しを示していた。しかし10月14日付第5報では、影響を受けた495の企業・自治体のうち、スナップショット機能を利用していた194の利用者について、バックアップデータの取り出しが可能と確認したと公表した。取り出したデータの復元可否と提供方法は引き続き確認中である。これは本番環境の停止に加え、事故後のデータ回収・復元能力がCSCの事業継続に直結することを示している。

【第5報反映】第5報による情報流出の調査結果:IDCフロンティアは、対象4ゾーンの仮想サーバー内データについて、外部持ち出しを示す痕跡等は確認されず、流出はなかったと判断した。一方、クラウドポータルでは48社の登録情報への不正な照会を確認しており、仮想サーバー内データとポータル登録情報を区別して評価する必要がある。

未解明であり、断定してはならない事項

【第5報反映】第5報時点で、スナップショットデータの「取り出し可能」と「実際に正常復元できる」は同義ではない。また、194という数字はスナップショット利用者についての公表値であり、残る301の利用者にバックアップがない、または復元できないと断定できない。スナップショットと別サービスの「IDCFクラウドバックアップ」も区別する。侵入経路の全容、攻撃者の破壊主張の真偽、バックアップサービスの個別契約に対する履行状況については、追加の証拠が必要である。

未解明の論点評価に必要な証拠
4ゾーンに被害が及んだ経路侵入経路、共通管理プレーン、特権ID、ゾーン間の権限・障害分離
スナップショットの被害194利用者分のスナップショットデータは取り出し可能。復元可否は確認中
別拠点バックアップの健全性別サービスの「IDCFクラウド バックアップ」の状況は区別して確認
有料バックアップ利用顧客の復元実績契約・設定状況、RPO/RTO、復元成功率・所要時間
責任分担と契約履行事故当時の適用約款、サービス仕様書、個別契約、保証・免責条件

【第5報反映】第5報により、一部のスナップショットデータを取り出せる可能性が具体的に確認された点は、当初の復旧見通しを更新する重要な事実である。一方、復元成功、RPO・RTOの達成、別途契約されたバックアップサービスの履行状況は、この発表だけでは確定できない。したがって、CSP提供バックアップが一律に機能しなかったとも、十分に機能したとも断定できない。

なお、攻撃者が主張した破壊件数や容量は、事業者が裏付けた確定事実とは扱わない。また、4ゾーンに影響が出たことだけから、テナント分離の破綻やバックアップ基盤の共通障害を断定することはできない。

まとめ

  1. 「CSCは自らバックアップを取得しなければならない」との一律の表現は不正確である。
  2. 「CSCが必要なバックアップを確保・確認する責任を負う」は一般的なIaaS契約と整合する。
  3. CSPが提供するバックアップ機能がCSCの要求事項を満たし、適切に契約・設定され、バックアップの取得・保存・復元が可能であれば、CSCが別途、独立したバックアップを取得することは必ずしも必要ではない。
  4. この場合、CSCは必要なバックアップの要件を定め、実際に復元できることを確認する責任を負い、CSPは契約に従ってバックアップサービスを提供する責任を負う。また、CSPには、バックアップサービスの提供に加えて、クラウド基盤そのものを適切に保護する責任もある。

IDCフロンティアについては、4ゾーンの本番データが復元困難となったこと自体が重大である。一方、CSPが提供した独立バックアップが契約どおり機能しなかったと断定するには、バックアップ利用顧客の復元実績と事故時点の適用契約の確認が不可欠である。

8.クラウドサービスカスタマへのバックアップ推奨事項

基本原則:CSPのバックアップ機能がCSCの要求事項を満たし、適切に契約・設定され、必要なバックアップが実際に取得・保持され、復元可能であることが検証されているなら、CSCが独立したバックアップを必ず追加する必要はない。これは「独立したバックアップは不要」という一般論ではなく、リスク評価に基づく条件付きの判断である。

CSCは、バックアップ処理を自ら実施することと、必要なデータ保護・復旧能力を確保する責任を区別する。CSPに実施を委ねる場合でも、要件定義、契約・設定確認、復元可能性の検証は必要である。

推奨する確認事項

以下の確認事項は、CSCが独立したバックアップを取得することを前提とするものではなく、CSPが提供するバックアップ機能によってCSCの要求事項を満たせるかを確認するためのものである。要求事項が満たされ、残余リスクも許容できる場合には、CSCが独立したバックアップを追加することは必須ではない。

  • 保護対象:仮想マシン、ディスク、データベース、設定、暗号鍵、認証情報など、復旧に必要な要素を漏れなく特定する。
  • 復旧目標:許容データ損失(RPO)、目標復旧時間(RTO)、保存期間、世代数、データ整合性を明確にする。
  • 契約・仕様:CSPが取得・保持・保護・復元のどこまでを担うか、除外事項、SLA、免責、障害時の支援を確認する。
  • 設定・運用:バックアップ対象の割当て、スケジュール、保持設定、失敗通知、アクセス権限を点検する。
  • 攻撃耐性:本番環境との管理権限の分離、削除・改ざん防止(イミュータビリティ)、別拠点・別アカウント等の必要性をリスクに応じて評価する。
  • 復元検証:バックアップの存在確認だけでなく、定期的な復元試験でデータ整合性、復元時間、代替環境への復旧を検証する。
  • 残余リスク:CSPの管理基盤への不正アクセス、リージョン全体の障害、契約終了時のデータ移行、特定事業者への依存などのリスクを評価する。その結果、CSPが提供するバックアップ機能だけではCSCの要求事項を満たせない場合や、追加の保護が必要と判断される場合には、CSPから独立したバックアップの導入を検討する。

独立した追加バックアップの要否を判断する基準

追加が必須とは限らない例:CSP提供機能で必要なRPO・RTO、保持、改ざん防止、管理権限分離、復元試験が満たされ、想定脅威に対する残余リスクを組織が受容できる場合。

追加を検討すべき例:CSP提供機能が本番環境と同じ侵害経路に依存する場合、復元試験ができない場合、リージョン全体の喪失やCSP管理基盤の侵害を想定する場合、法令・契約上の独立保管要件がある場合。

【第5報反映】IDCフロンティア事故への適用:第5報ではスナップショット利用者194のバックアップデータについて取り出し可能と確認されたが、復元の可否は確認中である。CSCの要件設定・検証責任と、CSPの基盤保護・契約サービス提供責任を区別する。別サービスの「IDCFクラウド バックアップ」の個別復元実績を、このスナップショットの報告からはわからない。

IDCフロンティア事故への適用:標準IaaSのバックアップ確保責任と、契約済みバックアップサービスの履行責任を分けて評価する。バックアップサービス利用顧客の復元実績、保存データの健全性、管理権限分離が未公表である限り、サービス自体の失敗も成功も断定しない。

参考:AWS Backupの公式資料では、クラウドサービスカスタマがバックアップ計画と対象リソースを適切に設定し、定期的に復元可能性を検証する責任を負うことが明記されている。一方、バックアップの取得・保持や復元テストの実行については、AWS Backupの自動化機能を利用できる。したがって、カスタマがすべてのバックアップ処理や復元テストを自ら実施する必要はない。ただし、バックアップの対象、保持期間、復旧目標、復元結果などが組織の要求事項を満たしていることを確認する責任はカスタマに残る。
https://docs.aws.amazon.com/ja_jp/wellarchitected/latest/framework/rel_backing_up_data_secured_backups_data.html

9.データ耐久性(11ナイン)とバックアップの関係

AWSがAmazon S3 Standardについて公表する99.999999999%(イレブンナイン)は、年間のオブジェクト耐久性に関する設計上の数値である。これはサービスの可用性、バックアップの取得状況、過去の正常な状態への復元可能性、または損害賠償を保証する数値ではない。

耐久性は、保存済みデータがストレージ障害等によって失われにくい性質を指している。一方、バックアップは、誤削除、論理的な破損、悪意ある変更、ランサムウェア攻撃などを想定し、必要な過去時点のデータを保持して復元するための手段である。複数のアベイラビリティゾーン(AZ)にデータを分散して保存していても、誤削除やランサムウェア攻撃によって変更されたデータが他のAZにも反映される場合がある。そのため、複数AZへの冗長配置だけでは、障害や攻撃が発生する前の正常なデータに復元できるとは限らない。

CSCへの推奨事項

CSCは、CSPが公表する耐久性の数値のみを根拠に、バックアップが不要と判断してはならない。データの重要度、誤削除・改ざん・管理権限侵害・リージョン障害等の想定事象、必要な保存世代、RPO・RTOを定義し、提供されるバックアップ機能の保護範囲と復元手段を評価する必要がある。

一方、CSPのバックアップ機能がCSCの要求事項を満たし、適切に契約・設定され、バックアップが実際に取得・保持され、想定する障害・攻撃に対して復元可能であることを検証できる場合、CSCがCSPとは独立したバックアップを必ず追加する必要はない。追加バックアップの要否は、共通管理権限への依存、削除・改ざん耐性、別アカウント・別リージョンでの保管、復元試験の結果、リスク許容度に応じて判断する。

【第5報反映】第5報は、ストレージの耐久性、バックアップデータの取り出し可能性、業務システムの復元成功が別々の評価項目であることを示している。スナップショット利用者194のデータが取り出せると確認された一方、復元の可否は確認中である。CSPのバックアップ機能が要求事項を満たすかは、正常な復元の実績、RPO・RTO、保護設定、管理権限の独立性などで評価する。

IDCフロンティア事故との関係

今回の事故の評価では、ストレージの耐久性に関する数値と、侵害後に正常なバックアップから復元できるかを混同すべきではない。重要なのは、各バックアップ方式が本番環境や管理プレーンの侵害からどの程度独立し、契約・仕様に沿って復元可能だったかである。事故におけるバックアップデータの実際の被害範囲と復元実績は、公開情報だけでは確定できない。

10. 免責事項

本ブログは、公開時点で入手可能な公表資料、契約条件、技術文書および関連規格に基づき、クラウドサービスにおけるバックアップの責任分担とデータ保護の考え方を整理したものである。

特定のクラウドサービスプロバイダの事故原因、セキュリティ対策の適否、契約違反の有無、法的責任の所在などについて、断定的な評価を行うことを目的とするものではない。

本ブログに記載した事実関係は公開時点の情報に基づいており、今後の調査結果や新たな情報の公表によって変更される可能性がある。また、ISO/IEC規格や各種ガイドラインに関する記述は、筆者による解釈・考察を含むものであり、規格制定機関等の公式見解を示すものではない。

本ブログは一般的な技術情報および制度上の考察を提供するものであり、個別の契約に関する法的助言や、特定のシステムに対するセキュリティ対策の有効性を保証するものではない。具体的な判断にあたっては、適用される契約条件、サービス仕様および組織の要求事項を確認し、必要に応じて専門家に相談すること。

11. 参考資料

以上