作成者別アーカイブ: 諸角昌宏

ゼロトラスト追補(2) ~ ZTNAだけでは十分でない理由、SASE/SSE・IdPと組み合わせても残る課題

2026年9月28日
ゼロトラストWGリーダー 諸角昌宏

背景

ゼロトラスト実装の5ステップ(NSTACモデル)入門シリーズについての質問で、ZTNAとZTAの違いを詳しく説明してほしいという意見がある。特に、ZTNAの導入ではZTを実現したとは言えないというのはどういうことかという質問が寄せられている。

そこで、本ブログでは、ZTNAだけでは十分でない理由、および、SASE/SSE・IdPと組み合わせても残る課題について掘り下げてみる。

はじめに

Zero Trust Network Access(ZTNA)は、VPNの代替として急速に普及している。「ゼロトラスト実装の5ステップ」シリーズ第3回でも、SDPと並ぶ代表的な実装パターンの一つとして紹介した。しかし、「ZTNAを導入した=ゼロトラストを実現した」という理解は誤解である。

本シリーズが依拠するNSTACの5ステップは、ゼロトラストという抽象的な原則(「決して信頼せず、常に検証する」)を、組織が実際に手を動かして実装していくための、実践的な進め方である。ZTNAやSASE/SSEといった技術は、この5ステップのうち主にステップ3(アーキテクチャの構築)を実現する手段の一つにすぎず、5ステップ全体を代替するものではない。

今回は、ZTNAだけでは十分でない理由を整理し、そのうえでSASE/SSEやIdP(アイデンティティプロバイダー)と組み合わせた場合に何が改善し、何が改善しないのかを検討する。

ZTNAだけでは十分でない理由

ZTNAは、ZTA(ゼロトラストアーキテクチャ)を構成する要素の一つであり、ネットワークアクセス制御に特化した技術カテゴリである。つまりZTNAは、ZTAという大きな設計図の一部分にすぎない。具体的には、次の理由がある。

① 単独では、5本柱を包括的にカバーしない

ZTNAは、CISAのゼロトラスト成熟度モデルにおけるネットワークの柱を中心に、アイデンティティ、デバイス、アプリケーションへのアクセス制御にも関係する。接続を許可するにはユーザーを認証する必要があり、多くの製品はデバイスの状態も判断材料に含め、制御の単位もネットワーク全体ではなくアプリケーション単位である。しかし、ZTNAだけで5本柱および3つの横断的能力(可視化と分析・自動化とオーケストレーション・ガバナンス)を包括的に実現できるわけではない。データの分類・保護や、エンドポイントの詳細な健全性管理などは、別の仕組みで補う必要がある。

② 「入口」は絞れても、「入った後」の制御には限界がある

多くのZTNA製品は、接続開始時にユーザー/デバイスを検証して「このアプリへのアクセスを許可するか」を決めることに主眼を置いている。しかし、いったんアクセスが許可された後、そのセッションの中で何が行われるかまでは見ていないことが多い。真のゼロトラストは、一度きりの検証ではなく、継続的な検証を要求している。

③ ラテラルムーブメント(横移動)対策は「軸」によって効き方が違う

従来型VPNでは、接続後のアクセス範囲を適切に制限していない場合、広範なネットワークリソースへの到達が可能となり、横移動のリスクが高まる。一方ZTNAは、アクセス対象をアプリケーション等の単位に限定することで、このリスクを低減する。常に検証し、最小権限による制御を前提とする設計であることも、この違いを支えている。

ただし、ここには以下の2つの異なる軸がある。

軸何の話かZTNAの役割
A:ユーザー→アプリの横移動(VPN文脈)アクセス範囲が適切に制限されていない場合、リモートユーザーが広範なネットワークリソースに到達できてしまう問題ZTNAはアクセス対象をアプリ単位に限定し、このリスクを低減する
B:サーバー・ワークロード間の横移動(マイクロセグメンテーション文脈)攻撃者がいったん社内の1台に侵入した後、サーバー間・サービス間を東西(east-west)に動き回る問題ZTNAは通常ここまでは踏み込まない。別の技術(マイクロセグメンテーション)の役割である

表1:ZTNAが効く横移動と、効かない横移動

Target社の事件では、外部委託先の認証情報を悪用した侵入後、内部ネットワークでの横移動が発生した。本ブログでの分類では、特に軸Bに相当する問題を示す事例である。

④ 非人間アイデンティティへの対応が弱い

多くのZTNA製品は、人間のユーザーがアプリにアクセスする場面を想定して設計されており、サービスアカウントやAPI、ワークロード間の通信、AIエージェントのような非人間の主体に対するコントロールは、そのままでは不十分なことが多い。「Whoには人だけでなく非人間も含める」という、シリーズ第4回で説明した原則が、ZTNA単体では十分にカバーしきれない領域である。

⑤ 通信内容の脅威検査は、別の機能に委ねられる

アクセス制御を主機能とするZTNAは、マルウェアやゼロデイ攻撃を通信内容から検出・防御すること自体を主目的としていない。こうした脅威に対応するには、ZTNAと連携する脅威検査機能やエンドポイント保護等が必要になる。

⑥ 5ステップで言えば「ステップ3の一部」にすぎない

ZTNAは、5ステップのうちステップ3(アーキテクチャの構築)で選べる実装パターンの一つにすぎない。ZTNAをどれだけ高度に導入しても、プロテクトサーフェスの定義(ステップ1)を飛ばしていれば何を守るべきか曖昧なままであり、トランザクションフローのマッピング(ステップ2)がなければポリシーの中身がスカスカになり、監視と保守(ステップ5)がなければ時間とともにポリシーが陳腐化する。ZTNAという「箱」を導入しただけでは、その中身(ポリシー、プロテクトサーフェスの定義、継続的な運用)が伴わなければ機能しない。

ZTNAとIdPを組み合わせるとどうなるか

ZTNAの限界を踏まえると、「IdP(アイデンティティプロバイダー)と組み合わせればどうか」という発想が浮かぶ。これは第3回で説明した「ZTNAという枠組みに、IdPをデータソースとして接続する」という構成そのものであり、実務でも広く行われている。

ただし、ここで前提を一つ補足しておきたい。ZTNAをSSEやSASEの構成要素として提供するベンダーが存在し、SWGやCASB等との統合が進められている。SASE(Secure Access Service Edge)は、SD-WAN等のネットワーク機能とクラウド提供型のセキュリティ機能を統合するアーキテクチャである。一方、SSE(Security Service Edge)は、SASEのセキュリティ機能部分に相当し、ZTNA、SWG、CASB等を中心に構成される。ZTNAは、このSSEに含まれる機能の一つにすぎない。なお「ZTNA 2.0」は、SASEやSSEという製品カテゴリを指す言葉ではなく、ZTNAという機能自体を、継続的検証やインライン脅威検査まで含めてより高度に実装したものを指す、ベンダー側の呼称である。三者は並列の同義語ではなく、ZTNAはSASE/SSEを構成する機能の一つである。ZTNA 2.0は、そのZTNA機能を高度化したものを指すベンダー提唱の概念であり、SASE/SSEの実装に組み込まれる場合がある。

こうした統合が進むベンダーの構成を踏まえ、以下では「ZTNA単体+IdP」ではなく、「SASE/SSE+IdP」という組み合わせで、先の課題がどこまで解消するかを見直してみる。結論から言えば、かなり改善するが、埋まらない穴は変わらず残ると考えられる。

ZTNA単体の課題
ZTNA単体の課題SASE/SSE + IdP改善の程度(構成条件による)
① 5本柱を単独では包括的にカバーしないアイデンティティの柱をIdPが補強し、SASE/SSEはネットワーク以外の柱にも機能を広げる○
② 接続時の検証だけで、その後は見ないIdPとSASE/SSEの連携により、リスク変化の検出と接続後のコントロールを強化できる。ただし、実現範囲は製品・構成に依存する◎
③-A ユーザーの横移動(VPN文脈)ZTNAによるアプリケーション単位のアクセス制御により、広範なネットワーク到達に伴う横移動リスクを低減する◎
③-B サーバー・ワークロード間の横移動マイクロセグメンテーションはSASE/SSEとは別の機能・製品として提供される場合があり、別途対応が必要となることがある△
④ 非人間アイデンティティに弱いIdP側の対応範囲拡大に加え、SASE/SSE側も進みつつあるが発展途上△
⑤ 通信内容の脅威検査は、別の機能に委ねられるSSEに含まれるSWG等の機能が脅威防御を、DLPが機密情報の持ち出し制御を担う。ただし対象通信・構成は製品によって異なる○
⑥ 5ステップのうちステップ3の一部にすぎないステップ4(ポリシー)の判断に利用できる情報が拡充する。ただし、ステップ1・2・5は製品によって支援・自動化できても、組織の責任そのものは代替できない△

表2:ZTNA単体の課題と、SASE/SSE+IdPを組み合わせた場合の改善の程度
凡例:◎=大きく改善する、○=一定程度改善する、△=限定的な改善にとどまる

⑤はかなり埋まる。ただし条件と構成に依存する

SSEに含まれるSWG等の機能により、対応する通信についてマルウェア検査や脅威防御を実施できる。また、DLPによって機密情報の不適切な持ち出しを検出・制御できる。ただし、TLS復号の可否、検査対象となる通信、適用されるセキュリティポリシーは製品や構成によって異なる。これにより、ZTNA単体では扱えなかった「通信内容の脅威検査」は、条件が整えば大きく前進する。

特に注意したいのは、同じベンダーの製品であっても、ZTNAを担うサービスと脅威検査を担うサービスは、別々に設計・提供されていることが多いという点である。両者を連携させる設定を明示的に行わなければ、ZTNA経由の通信が脅威検査を自動的に通るとは限らない。

「SASE/SSEを導入した」だけでは足りず、構成として正しくつなぎ込まれているか、対象通信・ポリシーが意図どおりかの確認が要る。

③-Bは、SASE/SSEに広げても、なお埋まりにくい

一方、マイクロセグメンテーション(サーバー・ワークロード間の横移動対策)は、SASE/SSEとは別の機能・製品として提供される場合があり、導入時には両者の機能範囲や連携状況を確認する必要がある。

つまり、「SASE/SSEまで導入したから安心」という判断は早計であり、Target社事例のような内部の横移動対策は、依然として別の検討が必要である。

特に効くのが②:継続的なリスク評価

これが一番の実質的な進歩である。一部のIdP製品は、認証後もユーザーやセッションのリスク変化を検出・評価する機能を備えている。ただし、リスク評価と既存セッションのコントロールは別の機能である。IdPの評価結果をZTNAやSSEのアクセス制御に反映し、必要に応じて再認証・アクセス制限・セッション終了を実行できるよう、製品間の連携とポリシーを適切に構成する必要がある。こうした連携によって、接続時だけでなく、接続後の状況変化にも対応できる。

これはまさに、第3回で説明したCBAC(コンテキストベースアクセス制御)が目指す「セッション中も継続的に再評価する」という原則を、実装レベルで具体化したものである。

それでも、組織の責任そのものは代替できない

ここが本ブログの核心である。ベンダーがZTNAの機能を、SASE・SSEというプラットフォームや「Zero Trust Platform」といった上位概念に組み込み、どれだけ機能を束ねて上位概念に昇華させても、以下の3点は製品によって支援・自動化できるが、組織の責任そのものは代替できない。

  • プロテクトサーフェスの定義(ステップ1)
  • トランザクションフローのマッピング(ステップ2)
  • 監視と保守(ステップ5)

資産管理ツールやCMDBは棚卸しを助け、フロー可視化ツールはマッピングを助け、SIEMやアクセスレビュー自動化ツールは監視・保守を助ける。しかし、「何を守るべきか」「どこにコントロールを置くべきか」という最終的な判断と責任は、組織にしかできない仕事である。むしろ、ベンダーが機能を統合すればするほど、「それでも組織の責任は残る」という結論が、より際立って正しく見えてくる。

「組織の責任は代替できない」ことで、実際に何が起きるか

ここは、単に「代替できない」と言うだけでは足りない。放置すると、具体的に次の3つの問題が起きる可能性がある。

  1. 高機能な製品を入れても、「何を守るか」を考えていなければ意味がない
    プロテクトサーフェスの定義(ステップ1)を組織自身が行わなければ、何を重点的に保護すべきかが曖昧となり、保護すべき対象がアクセス制御の対象から漏れる可能性がある。また、保護対象に応じた適切なアクセス制御を設計できず、業務への影響を避けるために広すぎるアクセス許可を敷いてしまう場合もある。その結果、高機能なプラットフォームを導入していても、本来守るべき重要な資産が十分に保護されない状態になりかねない。
  2. ポリシーの中身がスカスカになる
    トランザクションフローのマッピング(ステップ2)がなければ、「誰が・どこへ・何のためにアクセスするか」の実態が分からないままポリシーを書くことになる。フローのマッピングはポリシーの“下書き”であり、下書きがなければポリシーは推測や慣習で書かれ、必要なアクセスを誤って止めて業務が止まるか、逆に不要なアクセスを許してしまうことになる。
  3. 導入時は良くても、時間とともに劣化する
    監視と保守(ステップ5)がなければ、業務やシステムが変化してもポリシーは自動では更新されず、ポリシーの腐敗がそのまま進行する。最新のプラットフォームを入れた初日は良い状態でも、1年後には形骸化している、という事態になる。

この問題について以下のよく知られた事件を5ステップの観点から分析し整理してみる。なお、これらは各社の公式な原因発表そのものではなく、5ステップという枠組みに照らして整理した分析である点に留意されたい。

事例関連するステップ何が起きたか
Capital One(2019年)ステップ1、4攻撃者は設定上の脆弱性を悪用して不正アクセスし、過大な権限を持つIAMロールを利用してS3上の情報を取得した。米国約1億人、カナダ約600万人が影響を受けた。保護対象の特定(ステップ1)だけでなく、アクセス権限の最小化と設定管理(ステップ4)の重要性を示す事例と解釈できる
Colonial Pipeline(2021年)ステップ5攻撃者は、当時使用されていなかったものの有効な状態だったVPNアカウントを悪用した。当該レガシーVPNではMFAが適用されていなかった。アカウントのライフサイクル管理、アクセス権限の定期的な見直し、MFA適用という、継続的な運用(ステップ5)の重要性を示す事例と解釈できる
Equifax(2017年)ステップ5既知のApache Strutsの脆弱性に対するパッチ適用が行われていなかった。また、ネットワーク監視に利用する証明書が約19か月間期限切れとなっており、暗号化通信の監視に支障が生じていた。攻撃による侵害は約76日間継続し、約1億4,800万人の個人情報が影響を受けた

表3:組織的な作業の観点から分析した主な事例

いずれも、高度なセキュリティ製品の有無とは別の次元で、組織的な判断・継続的な運用という観点から解釈できる事件である。

一言でいえば、「製品が高機能かどうか」と「その製品が正しく機能するかどうか」は別問題である。SASE/SSEは、正しいポリシーを、正しく強制する道具にすぎない。「何を・なぜ・どのように守るか」という中身は、組織が用意しなければならない。「組織の責任は代替できない」ことの本当の問題は、「良い製品を買えば安心」という誤った安心感を生み、実際にはザルなポリシーのまま運用されてしまうリスクがあるということである。

ZTNAやSASE/SSEは、ZTAにおけるアクセス制御やポリシーの実施を担う技術として利用できる。また、IdPはアイデンティティ情報や認証結果を提供し、アクセス判断を支える。ただし、これらの製品を組み合わせても、組織として何を保護対象とし、どの通信経路にどのようなコントロールを適用するかが自動的に決まるわけではない。第3回で説明したとおり、PEは、組織が定めたポリシーと各種データソースから得られる情報に基づいてアクセスを判断する。しかし、その判断の基礎となる保護対象の定義やアクセス方針を策定する責任は、組織にある。そのポリシーの中身は、プロテクトサーフェスの定義とトランザクションフローの理解に基づいて、業務オーナーとセキュリティ担当が作り込むものであり、これを用意するのは、あくまで組織の仕事である。

さらに、いったん作ったポリシーも、業務やシステムの変化に応じて陳腐化していく。ステップ5の監視と保守、つまりマッピングと実態の突き合わせ、ポリシーの検証と見直しを継続しなければ、どれほど高機能な製品を導入していても、ポリシーはやがて「腐敗」する。ZTNA・IdP・SASE/SSEをはじめ、あらゆる技術的な対策は、この組織的な土台があって初めて意味を持つことになる。

まとめ

SASE/SSE+IdPの組み合わせは、「誰が」という軸(アイデンティティ)と「通信の脅威検査」という軸の両方を大幅に強化し、しかも一度きりでなく継続的に検証できるようにする、という点で非常に理にかなっている。ただし、以下の点はこの組み合わせでも埋まらない。

  • 内部の横移動対策(マイクロセグメンテーション): SASE/SSEだけでは対応範囲が十分でない場合があり、別途の対策を検討する必要がある
  • プロテクトサーフェスの定義・トランザクションフローのマッピング・監視保守という組織的な作業(ステップ1・2・5): 製品によって支援・自動化できるが、組織の責任そのものは代替できない

「SASE/SSE+IdPを入れれば十分」ではなく、「それらは、5ステップの中の“良いパーツ”の一つ」と捉えるのが正確であると考える。ベンダーがZTNAの機能を、SASE/SSEといった上位のプラットフォームに組み込んでも、とりわけステップ1・2・5は、製品の導入では代替できない、組織自身が担うべき中核的な仕事である。ゼロトラストは製品の組み合わせで完成するものではなく、5ステップという手順そのものを、組織として回し続けることで実現される。これは、本シリーズが一貫して伝えてきた考え方に、改めて行き着く結論である。

参考資料

  • Portnox「Why Do ZTNA Solutions Fall Short When It Comes to Zero Trust?」
  • Cato Networks「ZTNA Alone Won’t Win the Zero Trust Race」
  • Palo Alto Networks「What is Zero Trust Network Access (ZTNA) 2.0」
  • Reco AI「Top Zero Trust Security Solution」
  • そのほか、事件に関する公開情報

以上

ゼロトラスト追補 ~ アタックサーフェスとプロテクトサーフェス

2026年9月25日
ゼロトラストWGリーダー 諸角昌宏

背景

ゼロトラスト実装の5ステップ(NSTACモデル)入門シリーズのプロテクトサーフェスについて、いろいろと質問をいただいている。その中で、John Kindervagの言っている「Protect Surface is much smaller and more knowable than the Attack Surface.(プロテクトサーフェスは、アタックサーフェスよりもはるかに小さく、はるかに把握しやすい。)」 は根拠があるのかという質問が寄せられている。そこで、事例を交えてこれを説明していきたいと考えた。まず、「この内容に該当するような事例があるか」ということになるが、ここでAIに支援を求めたところ、Target社の情報漏えい事件が上がってきた。

はじめに

「ゼロトラスト実装の5ステップ(NSTACモデル)入門」シリーズでは、ゼロトラストの出発点として「アタックサーフェス(攻撃対象領域)ではなく、プロテクトサーフェス(保護対象領域)に焦点を絞る」という考え方を紹介してきた。しかし「アタックサーフェスが広すぎて把握しきれない」という説明は、ともすれば抽象的に響いてしまう。

本ブログでは、この点を示す実例として、2013年に発生したTarget社の大規模情報漏えい事件を取り上げる。この事件は、セキュリティ業界で最も広く分析されてきた事例の一つであり、アタックサーフェスの広さと、プロテクトサーフェスを正しく隔離することの重要性の両方を、同時に教えてくれていると考えている。

Target社の大規模情報漏えい事件 ~ 何が起きたか

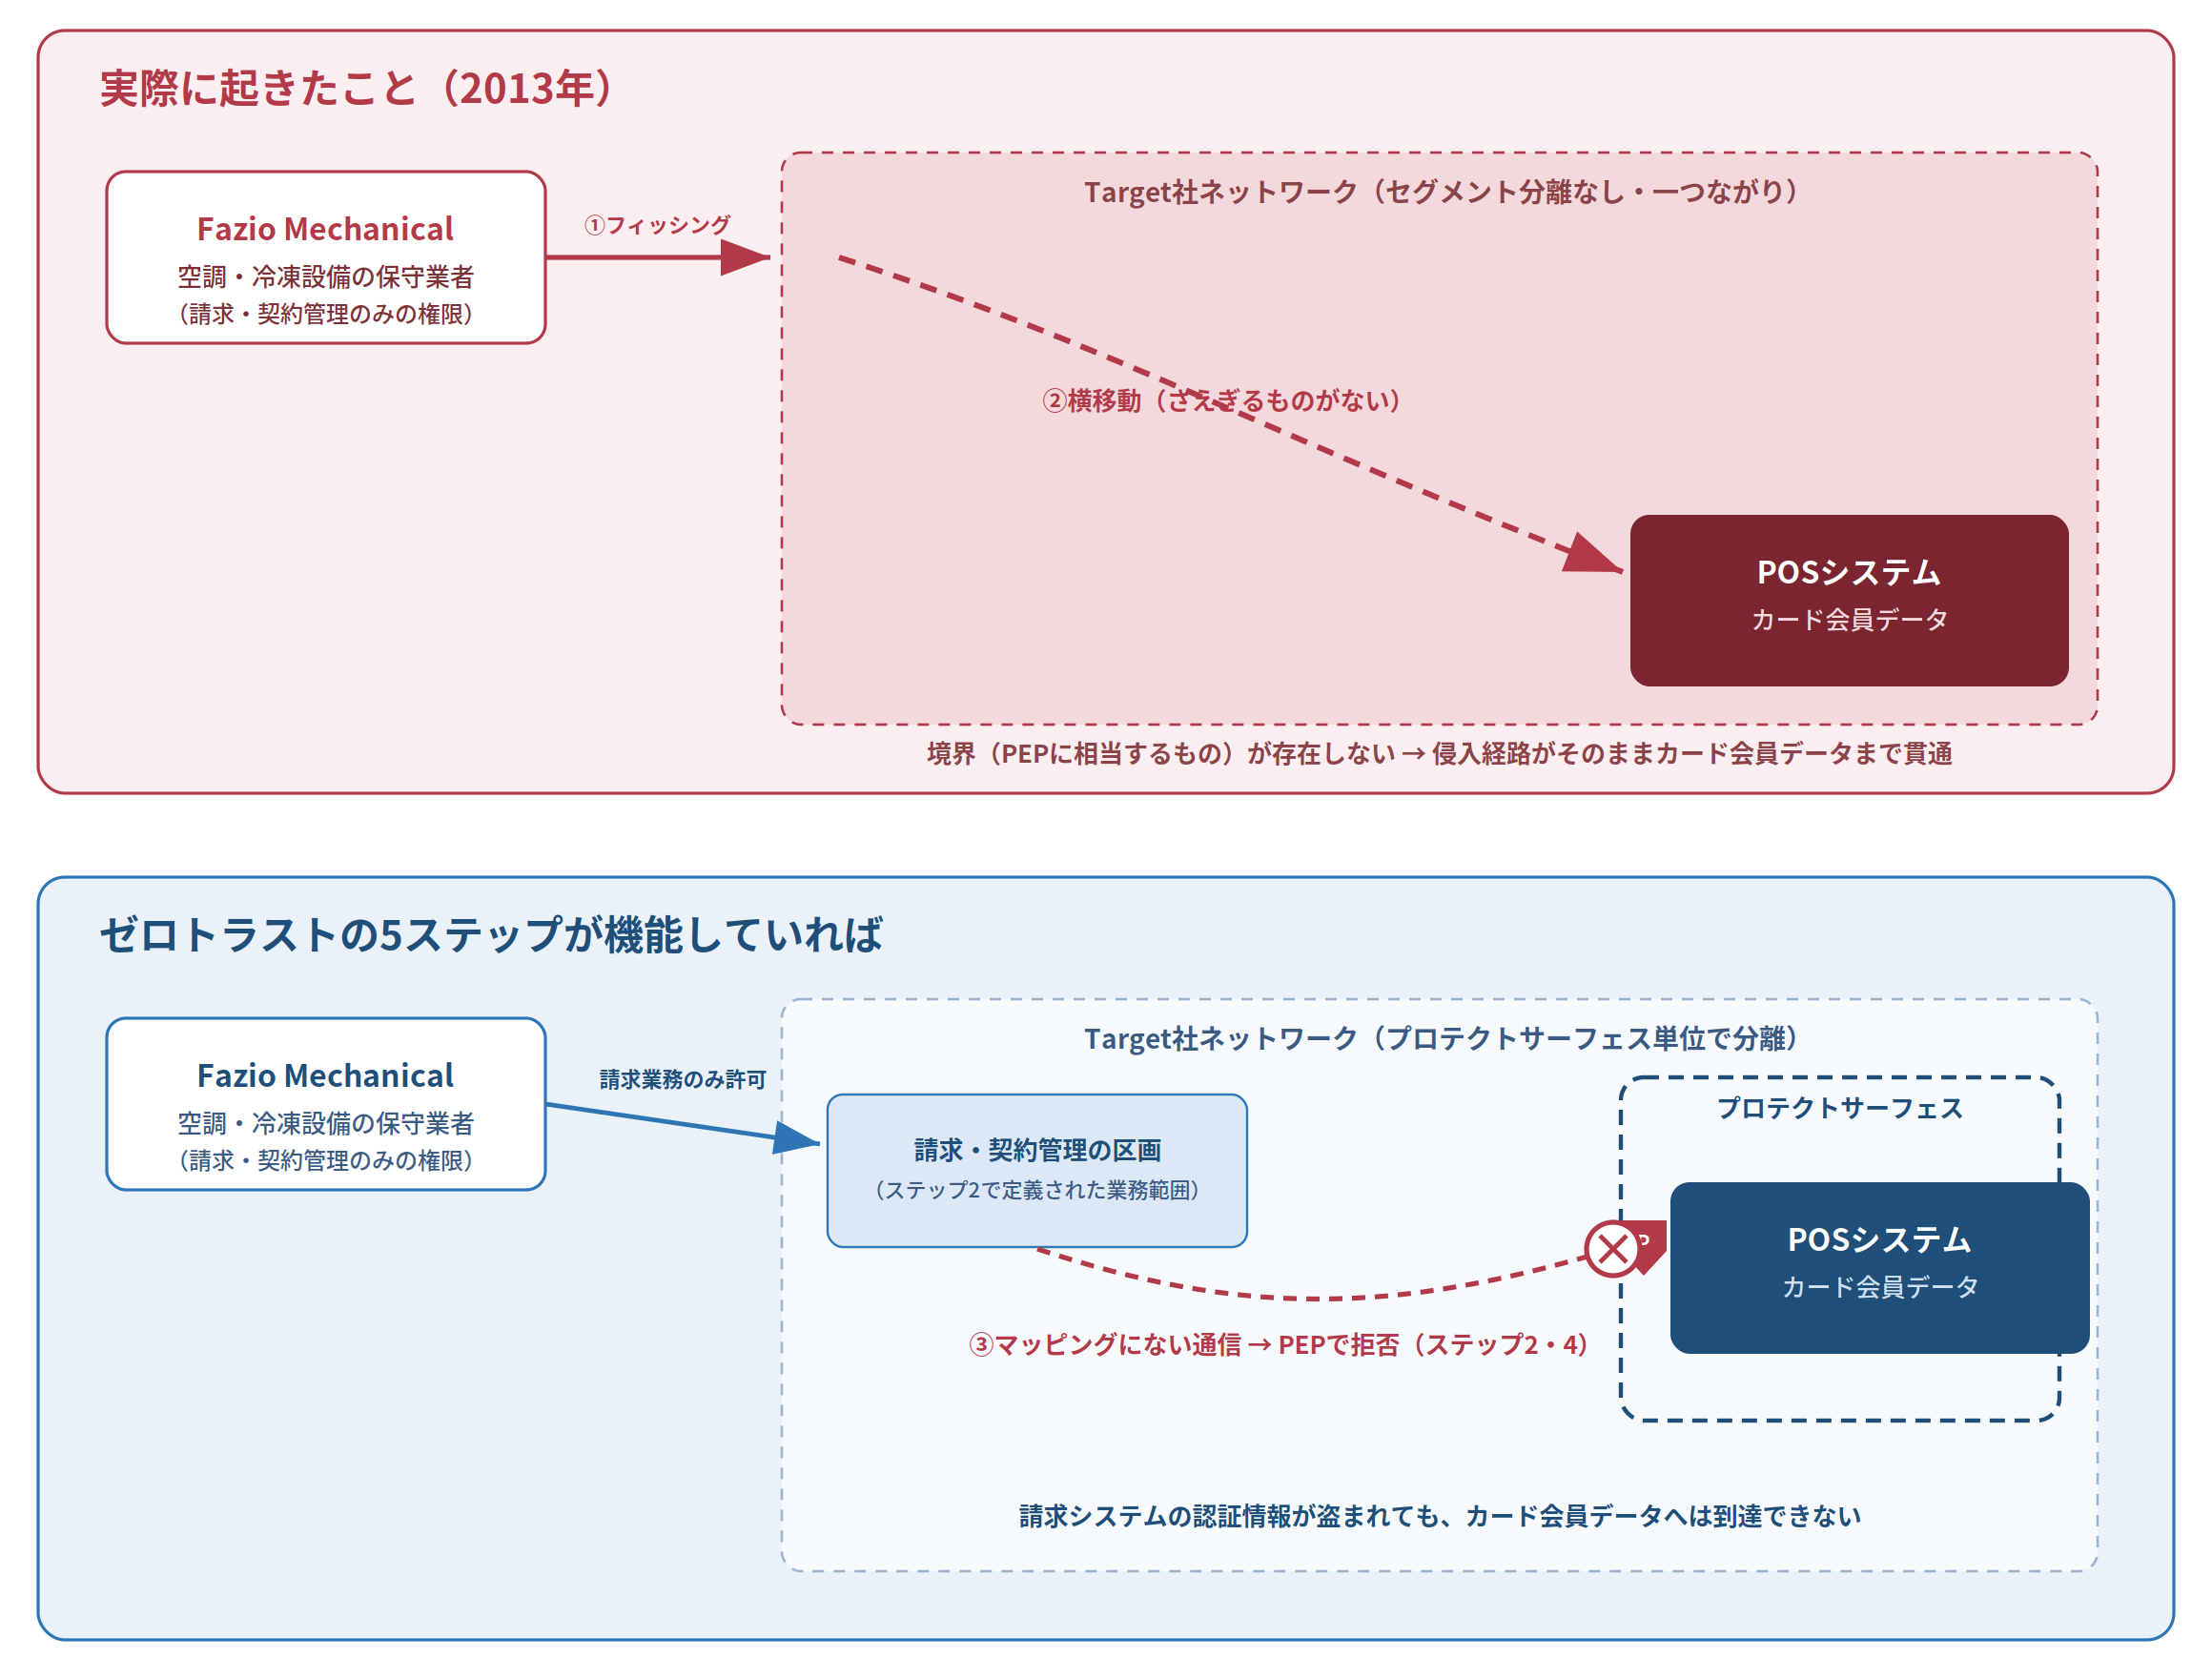
攻撃者は2013年11月15日、空調・冷凍設備の保守を請け負う地方の業者、Fazio Mechanical Services社から盗んだ認証情報を使って、Target社のネットワークに侵入した。Fazio社は、電子請求書の提出・契約管理・プロジェクト管理のためだけに、Target社のシステムへリモートアクセスできる契約だった。捜査関係者の話として、攻撃者はFazio社の従業員にフィッシングメールを送り、その認証情報を窃取したと報じられている(なお、これはTarget社・Fazio社の双方から公式に表明された確定した手口ではないことは述べておく)。

そこを足がかりに、攻撃者はTarget社のネットワーク内を横移動し、全米1,797店舗(後年の報道による)のPOSシステムにまで到達した。Target社がネットワークを適切に分離していなかったため、本来つながっているべきでないシステム同士が結びついてしまっていたことが、被害を広げる決定打となった。

結果として、約4,000万件のカード情報と、最大7,000万人分の個人情報が流出した。被害総額は、報道時期や算定方法によって幅があり、2億ドル超から、2014年時点のアナリスト試算では最大4億2,000万ドルに達するという推計も示されている。

なぜこれが「アタックサーフェスの広さ」の良い例なのか

「クレジットカード情報を守る」と考えるとき、誰も「空調業者の請求システムへのアクセス」を守るべき対象だとは思わない。しかし、実際の侵入口はそこだった。

アタックサーフェスには、こうした「守るべきだと誰も思っていなかった場所」が無数に含まれている。取引先、保守業者、委託先など、業務上必要だからという理由だけで存在する、無数の細い糸がある。そのすべてを事前に洗い出し、守り切ることは事実上不可能である。これが、ゼロトラストが「アタックサーフェス全体を守る」という発想を捨て、「本当に守るべきもの(プロテクトサーフェス)に焦点を絞る」という発想に転換する理由である。

空調業者の請求システムはプロテクトサーフェスにできるのか

ここで一つ、重要な問いが浮かぶ。「空調業者の請求システムも、DAAS(データ・アプリケーション・資産・サービス)として定義すれば、プロテクトサーフェスにできるのではないか」というものである。

答えは「YES」である。契約情報や請求データ(D)、ベンダー用ポータル(A)、それをホストするサーバー(A)、リモートアクセスの仕組み(S)、これらを1つの業務システムとして束ね、プロテクトサーフェスとして定義することは十分可能である。

しかし、これは本質ではない。Target社に本当に必要だったのは、請求システムを守ることではなく、カード会員データというプロテクトサーフェスを、他のすべてから隔離することだった。ゼロトラストは「攻撃者がどこから来るか」を防ぐのではなく、「侵入されても、守るべきプロテクトサーフェスにだけは到達させない」という設計を取る。カード会員データのプロテクトサーフェスが正しく隔離されていれば、攻撃者がアタックサーフェスのどこから侵入しようと、それが空調業者だろうと、他の誰かだろうと、守るべきものには届かない。

トランザクションフローとして、この経路は存在したのか

もう一つ、重要な点がある。「業務上正当なトランザクションフロー」と「実際に存在してしまった経路」は別物であるということである。

Fazio社は、電子請求・契約管理のためだけにアクセス権を持っていた。したがって、カード会員データやPOSシステムとやり取りする業務上の理由は、そもそもない。つまり、もしTarget社がステップ2(トランザクションフローのマッピング)を正しく行っていたら、カード会員データへのフロー図に「空調業者の請求システム」が登場することは、ありえないはずだった。

ところが実際には、ネットワークが適切に分離されていなかったため、マッピング上は存在しないはずの経路が、物理的には通ってしまっていた。これは、ステップ4で説明した「フローにある流れは許可の候補、フローにない流れは原則拒否」という原則が機能していなかった、ということに他ならない。

もしステップ5(監視と保守)で定期的に「定義したフローと、実際に観測されるフロー」を突き合わせていれば、空調業者のセグメントからカード会員データ環境へ到達できる経路が実在すること自体が、「本来ないはずの抜け道」として検知できていたはずである。

図1:実際に起きたことと、ゼロトラストの5ステップが機能していた場合の対比(公開報道を基に作成)

5ステップに当てはめると

この事件を、本シリーズの5ステップに当てはめ直すと、失敗の構造がより明確になる。なお、NSTACの5ステップモデルは2022年に公表されたものであり、2013年の事件当時にTarget社がこの手順を実際に採用していた(あるいは特定の手順が欠けていた)という記録があるわけではない。以下は、起きた事実に、後からゼロトラストの枠組みを当てはめて整理した、筆者による分析である。

ステップこの事件では
ステップ1:プロテクトサーフェスの定義カード会員データという、守るべきプロテクトサーフェスは(おそらく)認識されていた
ステップ2:トランザクションフローのマッピングそこへの正当なフローが厳密にマッピングされていなかった(あるいは、マッピングと実態が一致しているかの検証が甘かった)
ステップ3:アーキテクチャの構築ネットワークが十分に分離されておらず、PEPに相当する「関所」がフローの境界に存在しなかった
ステップ4:ポリシーの作成「フローにない通信は拒否する」というポリシーが、実効的に機能していなかった
ステップ5:監視と保守定義したフローと実態の突き合わせが行われず、抜け道が長期間放置された

表1:Target社の事件を5ステップに当てはめた場合の失敗構造(筆者による整理)

つまりこの事件は、5ステップのどこか一つが欠けたら何が起きるかを、そのまま実証した事例だと言える。

まとめ

Target社の事件が教えてくれるのは、次の2点である。

  • アタックサーフェスは、空調業者の請求システムのように、誰も予想しない場所まで含みうるほど広い。すべてを事前に守り切ることはできないと考える。
  • だからこそ重要なのは、守るべきプロテクトサーフェスを正しく定義し、そこへの正当なフローだけを許可し、それ以外を遮断すること。攻撃者がどこから来るかではなく、どこにも到達させないことに焦点を当てるべきである。

これは、「ゼロトラスト実装の5ステップ」シリーズが第1回から第5回まで一貫して説いてきた考え方、つまり守る対象を定め、流れを可視化し、アーキテクチャで隔離し、ポリシーで許可を絞り、監視で継続的に確かめるというのが、机上の空論ではなく、現実の重大な事件の教訓そのものであることを示している。

以上

中国のAIエージェント規制 ― 概要と意義

2026年9月23日
AIWGメンバー 諸角昌宏

CSAI Foundation/CSA本部が、「China’s AI Agent Regulation Enters Enforcement for Frontier Systems」を公開しました。本ブログでは、このレポートの簡単な概要とそこから読み取れる意味・意義を整理しました。

なお、原文の日本語訳の提供は予定していません。

文書の概要

中国は2026年7月15日、「Implementation Opinions on the Standardized Application and Innovative Development of Intelligent Agents」を施行しました。これは2026年5月8日に国家インターネット情報弁公室(CAC)、国家発展改革委員会(NDRC)、工業情報化部(MIIT)が共同で発布したもので、複数の法律専門家により「世界初のAIエージェント専用の国家規制カテゴリー」と評されています。従来の生成AI規制がコンテンツ(何を生成するか)を対象としていたのに対し、本規制はAIエージェントの意思決定・行動の権限(何をしてよいか)を規律の対象とする点が最大の特徴です。以下、その概要になります。

三層の意思決定権限モデル

規制の中核は、エージェントの自律的な行動を3段階の権限階層に分類し、段階に応じて人間の関与レベルを定める仕組みです。

階層説明代表的な活動人間の関与
レベル1日常的で影響の小さい業務スケジューリング、データ取得、基本的な顧客対応エージェントが自律的に進める
レベル2重要だが可逆的な決定契約内容の変更、価格設定の変更実行前に人間の承認が必要
レベル3影響が大きく、後戻りが困難な決定金融取引、法的文書の執行、安全に関わる制御措置自動化は禁止。人間へのエスカレーションが必須

出典: CSAレポート内で引用されている表を日本語化

適用範囲と域外適用

セクターごとにリスクが区分されており、医療・交通・メディア・公共安全は「高リスク分野」として、公開前の強制的な届出、コンプライアンステスト、リコール義務が課されています。リスクの低い消費者向けアプリケーションは、プラットフォームの自己評価や業界自主規制、信用ベースの執行にゆだねられています。加えて、「膨大なパラメータ規模・大規模ユーザー数・社会動員能力」を持つ汎用大規模モデルや、金融・医療・自動運転など重要インフラに組み込まれた専門モデルには、最も強い規制が留保されています。

適用範囲は中国の国境を越えます。企業の本社所在地に関わらず、エージェントが中国のユーザー・データ・市場運営に接触する組織はすべて対象となり得る、いわゆる域外適用型の規制となります。

CSAによる推奨事項(要約)

  • 即時対応(30〜60日): 中国関連のエージェント展開を棚卸しし、三層モデルに照らして分類。高リスク分野への該当有無、擬人化AI対話サービスへの該当有無、シャドーエージェント(未承認導入)の有無を確認。
  • 短期的対応(1〜2四半期): レベル2・3の意思決定について監査可能なログを整備し、実質的な人間によるオーバーライド機構を制度化。ベンダー契約上の責任分担の見直し。
  • 戦略的対応(6〜12か月): 特定国のコンプライアンスに個別対応するのではなく、アイデンティティ・権限のスコープ化・人間監督・監査ログを備えた、複数法域に対応できる社内エージェントガバナンス体制を構築。

文書の意味・意義

規制の視点の転換:「出力」から「権限」へ

本レポートが最も強調している点は、この規制が従来のAI規制の発想を転換させているということです。これまでの生成AI規制は、ラベル表示・正確性・禁止カテゴリーへの該当性など、AIが「何を生成するか」というコンテンツを対象にしてきました。これに対し、エージェントが行動を決定した後に「何をすることが許されているか」を問うものであり、規律の対象をコンテンツモデレーションの問題から、アイデンティティ・権限付与・監査ログというアクセス制御の問題へと移しています。この転換により、コンプライアンス対応の主体が法務チームからセキュリティチームへと移る、という実務上の帰結も指摘されています。

なぜこの転換が重要か

レポートは、2026年第1四半期だけで主要なエージェント型AIフレームワーク全体で約100件の脆弱性が公開され、資格情報の窃取・データの窃取・不正なツール呼び出しが実際の被害モードとなっていることを指摘しています。攻撃の起点はAIが生成した「中身」ではなく、AIエージェントに与えられていた「権限」そのものであり、この実態が三層の権限モデルによる規律という設計に直結しています。

また、域外適用性と責任の所在の曖昧さも重要な論点です。本社所在地を問わず中国関連のユーザー・データ・市場に接触する組織が対象となるため、多国籍企業は自社が対象に該当するかを法人登記地だけでは判断できません。加えて、権限付与モデルは「文書化された人間の監督」に責任の重心を置くため、ベンダーのエージェントを導入する企業がガバナンス責任を再交渉せずに済ませると、契約上想定していない責任を負うリスクが生じます。

留意事項

  • 原典であるCSAレポート自体が、「AI-assisted Rapid Research」と明記された、AIの支援により作成され正式なレビュー・承認プロセスを経ていない資料です。
  • 実際の法的判断・実務対応に用いる場合は、原典である「実施意見」の条文、および改正サイバーセキュリティ法・擬人化AI対話サービス措置の一次資料、必要に応じて現地弁護士への確認を推奨します。

まとめ

「生成結果」ではなく「権限」で規律するという方向性そのものは、法務関係者、agentic AIを利用する企業、そして中国と取引のある企業にとって、今後の規制動向を占ううえで注視しておく価値のある視点です。

ただし、本資料の評価にあたっては次の2点を踏まえておく必要があります。第一に、本レポートはCSAの公式レビュー・承認プロセスを経ていない、AI支援によるRapid Researchです(冒頭に “This document was generated with AI assistance and has not undergone official CSA review and approval processes.” と明記されている)。第二に、「欧米も同様の方向に向かっている」と断定するには、レポート内で挙げられている根拠がやや弱く、あくまで推測の域を出ません。

とはいえ、規制の発想が「出力」から「権限」へと転換しつつあるという着眼点自体には一定の説得力があり、読み手の立場や用途によっては有意義な参考資料になり得ると考えられます。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門(全6回シリーズ)まとめ

シリーズで投稿しました「ゼロトラスト実装の5ステップ(NSTACモデル)入門」、全6回が揃いましたのでここにまとめてリンクを貼ります。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第5回:ステップ5 — 監視と保守

2026年9月4日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回で守る対象(プロテクトサーフェス)を定義し、第2回で流れを可視化し、第3回でアーキテクチャを構築し、第4回でポリシーを作った。これで一通りの実装は終わる。では、なぜまだステップ5「監視と保守」があるのか。答えは、ゼロトラストは「作って終わり」ではないからである。

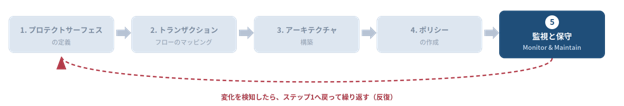
図1:ゼロトラスト導入の5ステップ。ステップ5は、変化を検知したらステップ1へ戻る「反復」の入口でもある

ステップ5には2つの部分がある。監視(モニター):防御が正しく働いているか、異常が起きていないかを継続的に確かめることと、保守(メンテナンス):ポリシーや設定を、変化する環境に合わせて健全に保つことである。以下、順に見ていく。

よくある誤解:ステップ5から始めてはいけない

ステップ5はとかく忘れられがちだが、逆にステップ5から始めてしまう組織も多い。「とにかくログを全部集めて、何か悪いことが起きていないか探す」というやり方、いわゆるMDR的なアプローチである。だが、ログをすべてSIEMやデータレイクに放り込んで、そこから何かを見つけようとするのは骨が折れるうえ、それ自体は“防御”ではない。

MDRは検知と対応(Detection & Response)であって、防御・予防(Prevention)がない。したがって常に後手に回ることが多い。つまり、「侵害されて、どこで何が起きたかは分かったが、すでに侵害されてしまっている」という事態になりやすい。ゼロトラストが目指すのは、侵害はいずれ起きるという前提に立ちながらも、それが実際の被害に広がる前に、できるだけ手前で食い止めることである。まずステップ1〜4で防御を築き、そのうえでステップ5の監視で「まだ健全か、対応が要るか」を確かめる。この順序が肝心である。

監視(モニター)

ゼロトラストの原則の一つに、「すべてのトラフィックを検査し、記録せよ(inspect and log all traffic)」がある。監視が要であることを示す言葉である。プロテクトサーフェスを小さく切り分けたことで、一つひとつについて「いま何が起きているか」という多くの情報(ログ)が得られる。配置したコントロール(ファイアウォールやEDRなど)が、その動作結果を、こちらに知らせてくれるようになる。

ログとイベントは違う

まず、ログとイベントを区別したい。監視で主役になるのはイベントである。

ログイベント
中身見えたことの記録そのものセキュリティ機器が「意味のある出来事」を検知したもの
例IP AがIP Bにアクセス/プロセスが起動/ボタン押下ブルートフォース検知、マルウェア検知、普段と違う国からのログイン、大量アップロード
扱い調査(根本原因の追跡)に使う。全部を長期保存はしない監視の主役。1件ずつ検査する。より長く保持できる

表1:ログとイベントの違い(Threat Talksを基に作成)(注:本ブログで参照しているThreat Talksは、Threat Talks(ON2IT × AMS-IX)の解説動画である)

なお、ここでいう「イベント」は、セキュリティ機器がフィルタして「意味がある」と判定したものを指す(無害な状態変化のログは含まない)。一般的な情報セキュリティの用語では、サービスの起動・停止や設定変更といった無害な状態変化も含めて「イベント」と呼ぶ、より広い使い方をすることが多い。本稿では、そのうち監視の対象として意味を持つものに絞って「イベント」と呼んでいる。

トラフィックのログをすべて7年間も保存する必要はない(保存コストばかりかさむ)。一方、セキュリティ機器が検知したイベントは、1件ずつ確かめる価値がある。ログは、イベントが起きたときに根本原因をたどるための材料として効いてくる。

プロテクトサーフェスの「文脈」を足す

ここでステップ1が効いてくる。ファイアウォールのイベントは、そのままではIPアドレスしか教えてくれない。だが、そのIPが「どのプロテクトサーフェスか」に翻訳できれば、第1回で記録したメタデータ(所有者・重要度・扱うデータ)が結びつき、「Active DirectoryからCRMへのアクセス」といった業務の文脈が見えてくる。

同じイベントでも、文脈が違えば対応が変わる。たとえば「ブルートフォース攻撃をブロックした」という同じイベントでも、インターネットから顧客向けWebへの攻撃ならよくあることでブロック済みなら無視してよいと考えられる。しかし、もしそれが社内のActive Directoryから発生していたら、たとえブロックされていても調査すべきである。すでに誰かが侵入して横移動を試みているのかもしれない(あるいは、サービスアカウントのパスワード期限切れによる誤検知かもしれない)。いずれにせよ、起きてはならないことなので確かめる必要がある。

IoG/IoC/Unknown で振り分ける

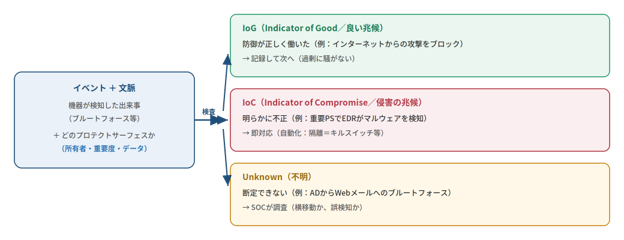
では、大量のイベントをどうさばくか。有効なのは、イベントを3つに振り分ける考え方である。文脈を足すことで、この振り分けができる。

図2:イベントに文脈を足して、IoG/IoC/Unknown に振り分ける(Threat Talks「監視」回を基に作成)

  • IoG(Indicator of Good/良い兆候):防御が正しく働いた合図(例:インターネットからの攻撃をブロック)。記録して次へ行く。
  • IoC(Indicator of Compromise/侵害の兆候):明らかに不正(例:重要なプロテクトサーフェスでEDRがマルウェアを検知)。即対応する。
  • Unknown(不明):断定できないもの(例:ADからWebメールへのブルートフォース)。SOCエンジニアが調査する。

多くのツールは、機器が出す「中身(コンテンツ)」だけを見るため、良い判断が難しい。ゼロトラストは、ここにステップ1の文脈を足せる点が強い。おすすめしたいのは、「ログを全部ためて、その中から怪しいものを拾う」のではなく、機器が出すイベントを1件ずつ、順に検査していくという発想である。コントロールはそれぞれ意味があって置かれているものなので、本来は良いイベントを上げてきてくれるはずである。もし何も上がってこないようなら、ツールの選び方や設定を見直すサインかもしれない。イベントの数は膨大になるため自動化が前提になるが、その自動化を支えるのが、いま述べた文脈「そのイベントがどのプロテクトサーフェスのものか(所有者・重要度・扱うデータ)」という背景情報である。同じイベントでも、文脈があれば振り分けやすくなるが、なければ判断がつきにくい。AIも助けにはなるが、この文脈を与えて初めて、より的確に働いてくれると思われる。

対応の自動化(Rules of Engagement)とキルスイッチ

振り分けの先には、対応の自動化(Rules of Engagement)がある。プロテクトサーフェスの重要度に応じて、どこまで自動で対応するかを決めておく。たとえば、ERPのような重要なプロテクトサーフェスで、EDRがランサムウェアだと判定したプログラムが動き出したら、そのプロテクトサーフェスをネットワークから隔離(キルスイッチ)して影響範囲(ブラスト半径)を抑える。

この隔離は、完全に自動化することも、人が承認する形にすることもできる。確度の高い脅威(明らかなIoC)で、かつランサムウェアのように広がる速度が速いものは、人の判断を待つ時間自体が被害を広げてしまうため、全自動で即座に遮断する運用が現実的である。一方、誤検知の影響が大きい場面などでは、自動化が「これを実行してよいか」という提案だけを整え、SOCが承認ボタンを押して実行する中間形(半自動)も取れる。どちらか一方に決める必要はなく、全自動が不安なら、まず承認を挟む形から始め、信頼度が上がったら段階的に自動化を広げる、という進め方もできる。ただし承認を待つ間にもランサムウェアは広がるため、承認フローを選ぶ場合でも、できるだけ素早く判断できる体制にしておく必要がある。

そして基本姿勢は防御優先(prevention first)である。IPS等は検知モードではなくブロックモードで使う。最良の対応ルールは「防いでブロックする」ことであり、最悪は「侵害されてから原因を探す」ことである。ブロックできたら、その結果をイベントとして受け取り、検査する。

キルスイッチは「セグメンテーションの通信簿」

あるプロテクトサーフェスを丸ごと遮断しようとすると、実はネットワークが十分に分離されておらず、「遮断したらネットワークの半分が止まる」と判明することがある。この予期しない巻き添えの大きさ(ブラスト半径の大きさ)は、次の2つのどちらか、あるいは両方が不十分だったことを教えてくれる。

  • ステップ1:守る対象を、他と混ざらない形で明確に切り分けて定義できていたか(プロテクトサーフェスの境界があいまいなままだと、1つを止めるつもりが他まで巻き込んでしまう)
  • ステップ3:その分離を、設計どおりマイクロセグメンテーションとして実装できていたか(設計は分離のつもりでも、実装が甘いと同じセグメントに相乗りしたままになる)

つまり、「これを止めたら他も止まる」と分かった瞬間は、分けたつもりで実は分かれていなかったことの証拠であり、実地で見落としを発見できる機会でもある。だからキルスイッチの検討は、なぜプロテクトサーフェスをきちんと分けるべきかを組織に示す良い材料にもなる。

保守(メンテナンス)

監視と並ぶもう一つの柱が保守である。作った防御は、放っておくと質が下がっていく。それに抗う仕組みが保守である。主な観点は次のとおりである。

ポリシーの検証

ここでいうポリシーは、いわゆる情報セキュリティ方針のたぐいのものではなく、実際に機器で動いている運用ポリシー、つまりファイアウォールのアクセス規則、EDRの設定などである。とくにファイアウォールでは、新しいアクセスは足されるが、不要になったアクセスは消えずに残りがちである。サーバーを撤去しても何も壊れないので誰も申告せず、「壊すのが怖い」ため規則は何年も放置される。今はネットワークセキュリティポリシー管理(NSPM)ツール(Tufin、AlgoSec、FireMon など)や、ファイアウォール自体に組み込まれた分析機能(例:Palo Alto NetworksのPanoramaが持つセキュリティポリシーオプティマイザ)を使えば、使われていない・重複した規則を検出できるので、変更のたび(少なくとも定期的)に、ポリシーが今も正しいかを点検する。ログが無効になっていないか、EDRでディスク全体をスキャン除外していないか、消し忘れの一時規則がないか、構成管理に近い実際に動いている設定の点検である。

ベンダー更新と“眠っている新機能”

ファイアウォール等は、クラウド経由で自動更新される。シグネチャだけでなく、新機能が配信されることもある。典型的なのは、新しいURLカテゴリ(例:登録されたばかりのドメイン)の追加である。ところがベンダーは、更新で通信を突然止めて障害を出さないよう、新機能を既定で「許可(=素通り)」にして配信することが多い。そのため多くの人が新機能に気づかず、有効化しないまま眠らせてしまう。すでに料金を払っている機能なので、更新のたびに点検し、そのプロテクトサーフェスに使えるものは有効化する。機器を新調したときも、古い設定をそのままコピーせず、新機能を評価し直すことが必要である。

トランザクションフローと実態の突き合わせ

第2回で「どのプロテクトサーフェス同士が通信してよいか」を(業務オーナーの合意のもとで)定義した。運用フェーズでは、定義したフローと、実際に観測されるフローを突き合わせる。定義したのに見えないフローがあれば、ステップ2の誤りか設定ミスを疑う。逆に、定義していないのに流れているフローがあれば、なぜかを調べる。つまり、正当なものか、それとも横移動の兆候かである。ステップ2〜4を正しくやれていれば、本来ここはきれいに一致するはずで、ずれはこれまでの仕事を検算する良い機会になる。

挙動分析(ベースライン)

ここで、監視の節との関係を整理しておきたい。両者は矛盾しているように見えて、実は役割が異なる、補完し合う仕組みである。

  • イベント検査(監視の節):機器が、その場・その1件について「これは意味がある」と判定したものを、その都度チェックする(リアルタイム・1件単位)。ここで人間(SOCエンジニア)が見るのは、あくまで機器が意味づけ・絞り込んだ結果である。
  • 挙動分析:時間をかけて蓄積したログ全体を、機械学習が処理し、統計的な「通常の姿(ベースライン)」を学習して、そこからの逸脱を見つける(蓄積・傾向単位)。ログ全体に目を通すのは機械学習であって、人間ではない。人間が見るのは、やはりベースラインから外れたという判定結果(アラート)だけである。

つまり、「全部のログを人間が精査する」というやり方には、どちらの仕組みでも戻らない。同じログという材料を、機器が1件ずつその場で判定する(イベント検査)か、機械学習が蓄積してから傾向として判定する(挙動分析)かの違いであり、いずれも人間が最終的に目にするのは、絞り込まれた結果だけである。

挙動分析が拾えるのは、単発のイベント検査では見えない、じわじわとした変化や、複数の小さな兆候の積み重ねである。やり方は、ログをXDR(あるいは次世代SIEM・SIEM 2.0とも呼ばれる仕組み)に集約し、機械学習にかける。すると「自分たちの環境では、ふだんこういう挙動が普通だ」という平常時の姿(ベースライン)を学習できる。そのうえで、ベースラインと大きくかけ離れた挙動、つまり普段と違う量・普段と違う相手・普段と違う時間帯のトラフィックなどが現れたら、アラートを上げる。

ただし、誤検知(false positive)が多くなりやすいという弱点も認識しておきたい。たとえば小売業なら、繁忙期(セール・年末商戦など)に通信量が跳ね上がるのは正常な変化だが、対策をしていなければベースラインから外れた「異常」として大量にアラートが出てしまう。同様に、システムの一部がフェイルオーバー(切り替え)しただけでも、普段と違うトラフィックパターンとして検知され、誤検知につながりやすい。

こうした誤検知を抑えるには、季節性やイベントごとの例外をあらかじめ調整しておく必要があり、ある程度の運用の作り込みが求められる。そのため挙動分析は、監視・保守の他の要素(イベントの振り分け、ポリシー検証、フロー突合)が一通り運用に乗ってから取り組む、成熟度の高い最後の一手として位置づけるのが現実的であると考える。

アーキテクチャの変化は「ステップ1へ戻る」合図

クラウド移行、VMからコンテナへ、オンプレのKubernetesからクラウドへ、サービスメッシュのサイドカー廃止など、こうしたアーキテクチャの変化は、可視性を変えてしまう。たとえばサイドカーがあれば見えていた通信が、廃止で見えなくなる。ネットワーク的には分離しているつもりでも、すべてが一つのプラットフォームに集約されれば、もはや分離ではなくなる。

怖いのは、クラウドチームが移行を進め、ネットワークチームが気づかないうちに「見えなくなる」ことである。監視で「これまで見えていた2つのプロテクトサーフェス間の通信が、急に見えなくなった」と気づいたら、それは大きな合図である。こうした変化を検知したら、ステップ1に戻ってやり直す。5ステップは反復であり、ステップ5は次の反復の引き金である。ただし大枠はできているので、多くの場合は所有者や一部のコントロールなど、変わるのはわずかな部分だけである。だからこそ、ゼロトラストの考え方をCISOの上まで含め、組織のあらゆる層に根づかせ、開発者が「クラウドネイティブな機能を使うと、セキュリティに影響するかもしれない」と気づける状態にしておくことが大切になる。

まとめ — そして、また1へ

最終回では、作った防御を健全に保つステップ5を扱った。要点は次のとおりである。

  • ステップ5から始めない。まずステップ1〜4で防御を築く(MDRだけでは常に後手)
  • 監視はイベントが主役。1件ずつ検査し、プロテクトサーフェスの文脈でIoG/IoC/Unknownに振り分ける(自動化+文脈)
  • 対応は自動化(Rules of Engagement)と防御優先。重要なPSはキルスイッチで隔離し、ブラスト半径を抑える
  • 保守で質を保つ:ポリシー検証・眠った新機能の有効化・フローと実態の突き合わせ・挙動分析
  • 大きな変化はステップ1へ戻る合図。5ステップは回り続ける

そして、ここまでの5ステップを、最初から全システムに広げる必要はない。第1回で示した「練習台から本命へ」がここでも効いてくる。まずは重要度の低い1つのプロテクトサーフェスで、定義・可視化・構築・ポリシー・監視保守という一連の流れを小さく回してみる。そこで運用を成熟させ、勘所をつかんでから、優先度の高いシステムへと広げていく。小さく始めて、回しながら育てるのが、5ステップを無理なく定着させる進め方である。

プロテクトサーフェスを定義し(1)、流れを可視化し(2)、アーキテクチャを構築し(3)、ポリシーを作り(4)、監視と保守で守り続ける(5)。そして、環境が変われば、また1に戻る。ゼロトラストは、一度きりのプロジェクトではなく、回し続ける取り組みである。この5ステップという実践的な地図があれば、その歩みを、着実に、そして繰り返し進めていける。全5回(+第1.5回)にわたる本シリーズを、実装の一助としていただければ幸いである。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第4回:ステップ4 ゼロトラストポリシーの作成

2026年9月1日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回で守る対象(プロテクトサーフェス=DAAS)を定義し、第2回でその周りのトランザクションフローを可視化し、第3回でPEP(ポリシー実施ポイント)を配置したアーキテクチャを設計した。配置したPEPは、まだ「何を通し、何を止めるか」というルールを持っていない。そのルールであるゼロトラストポリシーを作るのが、本編のステップ4である。

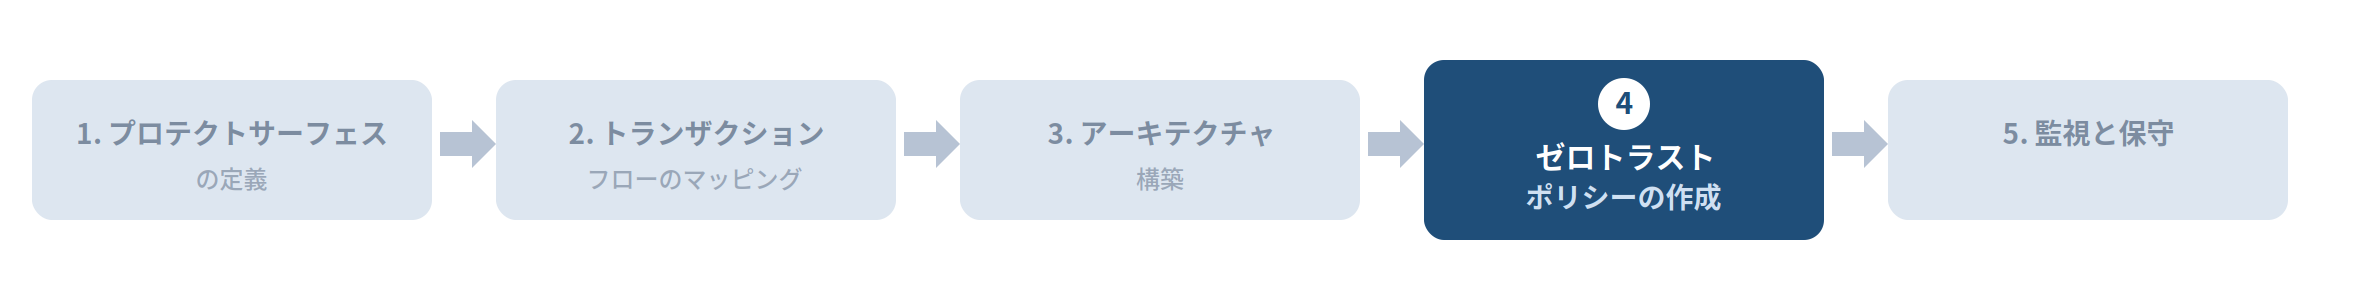
図1:ゼロトラスト導入の5ステップと、本稿が扱うステップ4(CSA文書の5段階プロセスを基に作成)

ステップ4のねらいは、ゼロトラストをアプリケーション層(L7)のポリシー文として具体化することである。第3回のPEPに、このプロテクトサーフェスへ「誰が・何に・どんな条件でアクセスできるか」を、細かい粒度で書き下ろしていく。

ゼロトラストポリシーとは

ゼロトラストポリシーは、セキュアなアーキテクチャの要石(cornerstone)である。ポイントは3つある。1つめは、プロテクトサーフェスにできるだけ近い場所(PEP)で適用すること。2つめは、最小特権・デフォルト拒否で、必要なアクセスだけを明示的に許可し、それ以外はすべて拒否する。3つめは、ポリシーは最初は静的でも、ZTAの成熟に合わせて動的に進化させることである。

また、ゼロトラストポリシーはアプリケーション層(OSI L7)で書く。IPアドレスやポート(L3/L4)だけでなく、「どのアプリの・どの操作を・どのアイデンティティに許すか」というアプリケーションの文脈で表現する点が、従来のファイアウォールルールとの違いである。

もう一つ大切なのが、ポリシーはまずビジネスの視点から出発し、それを技術的なルールに翻訳するという二段構えである点である。たとえば「営業担当は、勤務時間内なら自宅からでもCRMにアクセスしてよい」というのはビジネス上の方針(業務要件)である。これを、ファイアウォールやIdPが実際に強制できる形、つまりユーザーグループ、時間帯、場所の条件に落とし込む。翻訳のしやすさは使うツールに依存する。新しめのファイアウォールならユーザーグループのまま書けるが、古いものではIPアドレスに変換する必要があり、手間が増える。ビジネス要件の定義は業務オーナーが担い、技術ポリシーへの実装は、プロテクトサーフェスがきちんと定義されていれば、セキュリティ担当やSOCが引き受けられる。

プロテクトサーフェス、トランザクションフロー、ポリシーの関係

ポリシーを書く前に、これまでのステップとの関係を押さえておく。この3つは、次のような連鎖でつながっている。

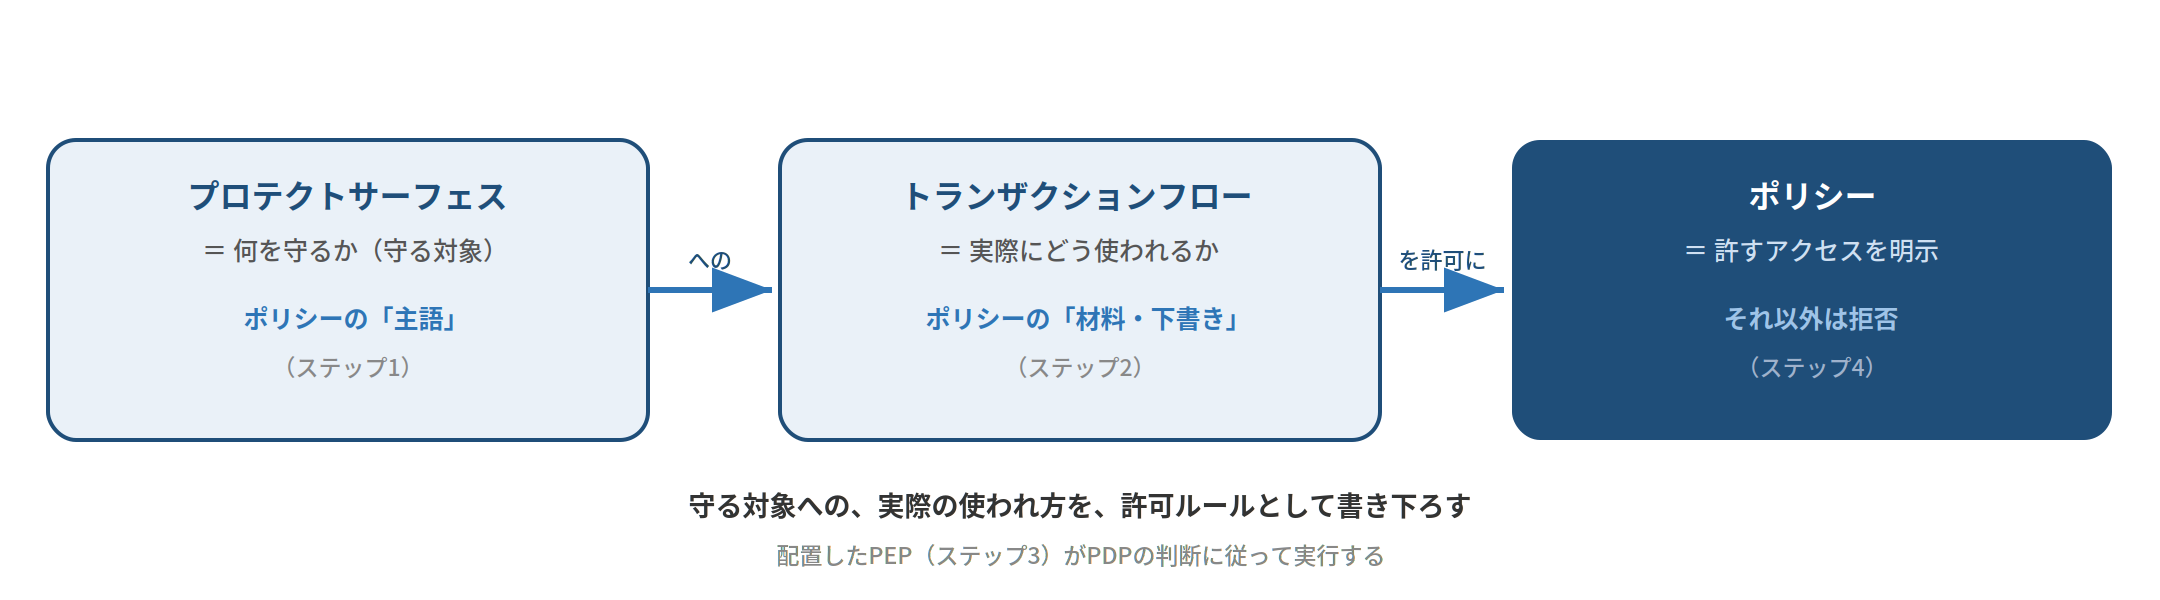
図2:プロテクトサーフェス、トランザクションフロー、 ポリシー

  • プロテクトサーフェス=ポリシーの「主語」:ポリシーは「このプロテクトサーフェスへ、誰が・何にアクセスできるか」を定める。守る対象(ステップ1)が決まって初めて、ポリシーの主語が決まる。
  • トランザクションフロー=ポリシーの「材料・下書き」:ステップ2で可視化した「実際にどんなアクセスが・どの経路で流れているか」が、そのままポリシーの下書きになる。フローにある流れは許可の候補、フローにない流れは原則拒否する。
  • ポリシー=許すものを明示:フローのうち、業務上正当なものだけをキプリングメソッドで許可として書き下ろし、それ以外はデフォルト拒否とする。

一言でいえば、守る対象(プロテクトサーフェス)への、実際の使われ方(トランザクションフロー)を、ポリシーとして書き下ろす、という関係である。だから、ステップ2のフローのマッピングが甘いと、ステップ4のポリシーも甘くなる。必要なアクセスを漏らして業務を止めるか、余計なアクセスを許してしまう。フローの精度が、そのままポリシーの精度になる。

ここで、ポリシーをめぐる3つの役割を、時間軸で分けて押さえておきたい。ここは混同しやすいところである。

  • 定義する(事前・人間):業務オーナーとセキュリティ担当が、キプリングメソッドでポリシーを作る(ステップ4)。作ったポリシーはPDPに登録しておく。
  • 判断する(実行時・PDP):アクセス要求のたびに、PDPが、その登録済みポリシーに、データソースから得た“今の状況”(本人性・端末状態・リスク等)を照らして、許可/拒否を判断する。
  • 強制する(実行時・PEP):経路上に配置したPEP(ステップ3)が、PDPの判断結果を実行する。

つまり、第3回で「PDPは様々なデータソースから情報を得る」と述べたのは、PDPがポリシーを作っているのではなく、人間が作った登録済みポリシーを評価するために、その場の状況を集めている、という意味である。ポリシーを作るのは人間(ステップ4)、それを状況に照らして判断するのがPDP、判断を強制するのがPEP。この切り分けを押さえると、「PEPがPDPの判断に従って実行する」と「PDPは様々なソースから情報を得る」が、どちらも実行時の同じ動きを指していることが分かる。

キプリングメソッド — 5W1Hでポリシーを書く

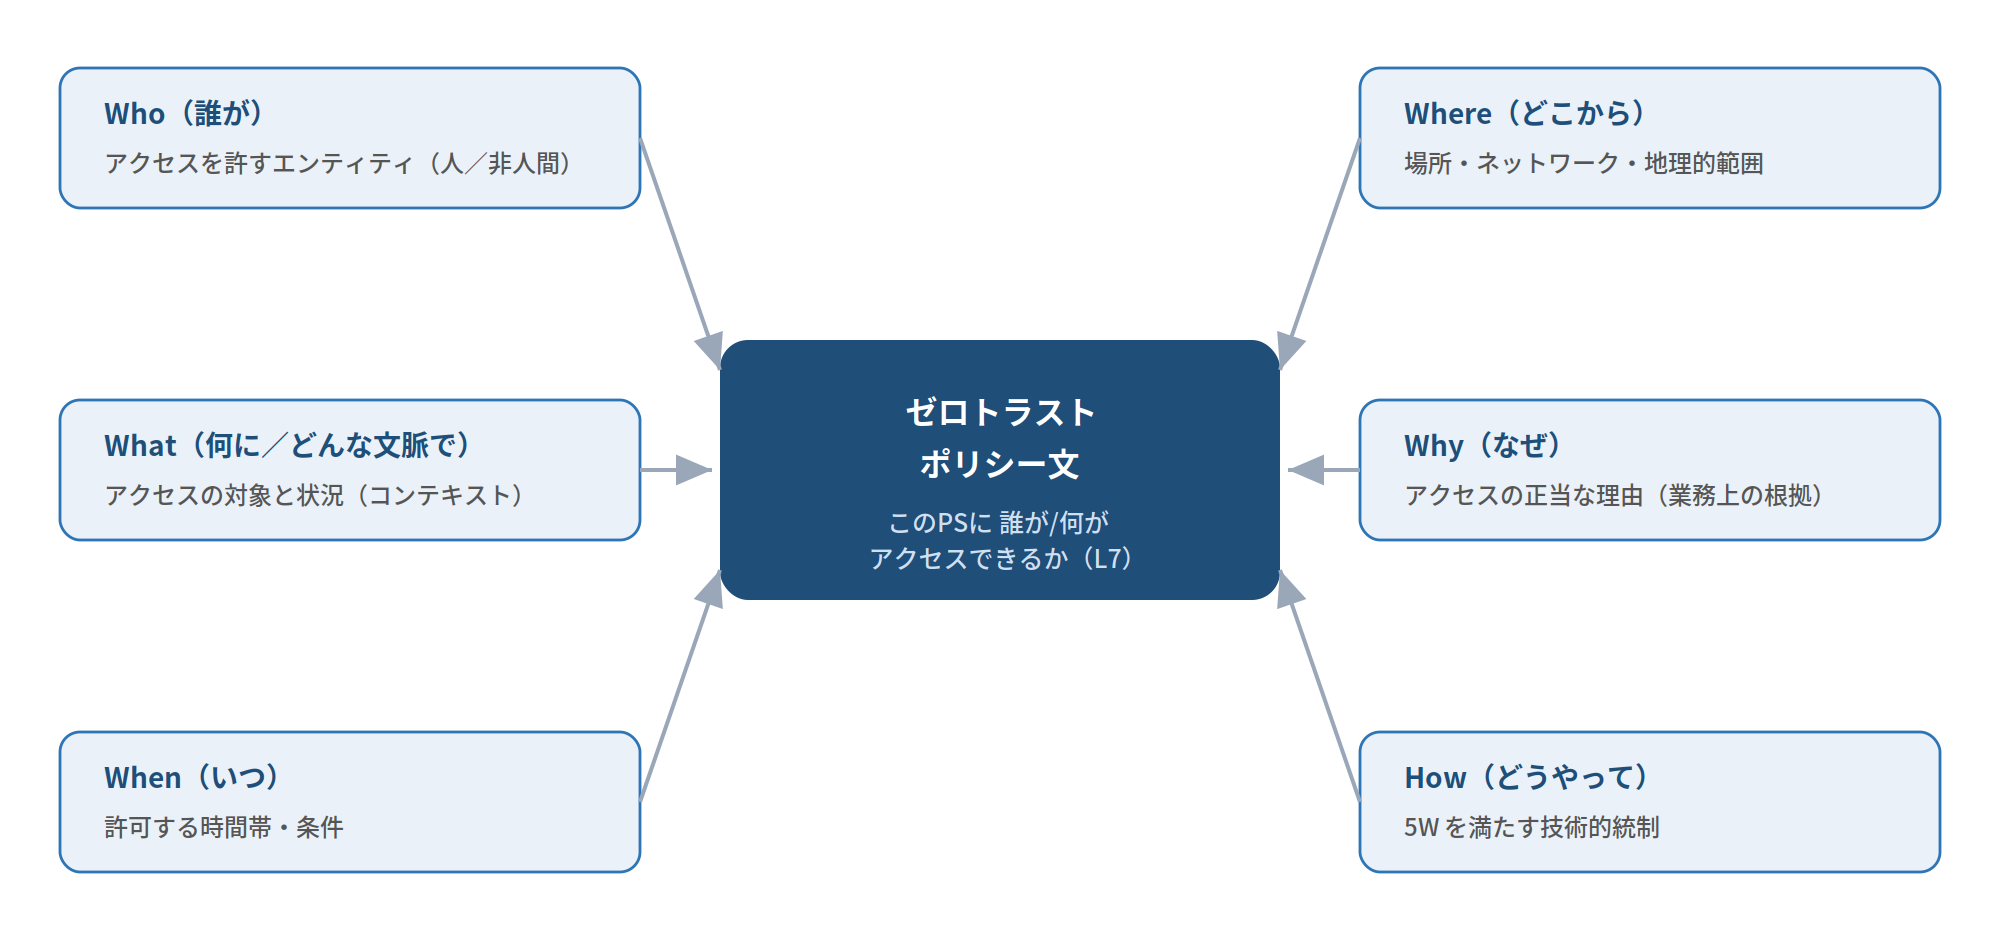
では、ポリシー文はどう書くのか。ここで用いるのがキプリングメソッドである。作家ラドヤード・キプリングの「6人の召使い(Who・What・When・Where・Why・How)」になぞらえた方法で、この6つの問いに答えることで、プロテクトサーフェスへのアクセスを許すべきエンティティを、細かい粒度で定義できる。

図3:キプリングメソッド(5W1H)でゼロトラストポリシー文を組み立てる(CSAのゼロトラスト関連ガイダンスを基に作成)

問い何を決めるか属性の例
Who(誰が)どのエンティティにアクセスを許すか(人・非人間の両方)役割、ユーザー、サービスアカウント、ボット
What(何に)何にアクセスするか/どんな文脈(コンテキスト)でアクセスするか対象リソース、操作、機微度
When(いつ)アクセスを許可する時間帯・条件営業時間、期間、頻度
Where(どこから)許可する場所・ネットワーク・地理的範囲社内/VPN、国・拠点、既知の端末
Why(なぜ)そのエンティティがアクセスする正当な理由(業務上の根拠)業務プロセス、職務上の必要性
How(どうやって)5W を満たすための技術的統制MFA、mTLS、暗号化、最小特権

表1:キプリングメソッドの6つの問い

重要なのは、Whoに人だけでなく非人間(サービス・アプリ・ボット)も含めることである。ゼロトラストでは、ワークロード同士の通信も検証の対象になるため、「決済アプリが会員データにアクセスする」といった非人間のアクセスも、同じ6つの問いで定義する。CSA文書では、これに「どれだけの時間(for how long)」を加えて、アクセスの有効期間まで定めることを勧めている。

具体例:クレジットカードのポリシー文

ここで、ポリシーとPEPの関係を正しく押さえておく。ポリシーは「PEPに対して」ではなく、「プロテクトサーフェスへの各アクセスに対して」作る。そのうえで、判断はPDP(ポリシーエンジン)が行い、経路上のPEPが適用・強制する。つまり流れは「プロテクトサーフェスに対してポリシーを作る → PDPが評価する → PEPが実行する」である。

まず、クレジットカードのプロテクトサーフェスへのアクセスを、キプリングメソッドで2つ書き下ろす。人(引受担当者)と非人間(決済アプリ)の両方を示す。

問い例1:引受担当者 → 引受審査アプリ(人)例2:決済アプリ → カード会員データ(非人間)
Who役割=引受担当者サービスアカウント=決済アプリのワークロード
What引受審査アプリで与信判定を行うカード会員データの該当レコードを読む
When営業時間内取引処理中(都度)
Where社内/VPN・管理端末想定された内部経路(同一PS内)
Why与信審査という業務上の必要決済処理に必要な参照
HowMFA+準拠端末、セッション短時間・再評価mTLS+最小権限(該当レコードのみ)

表2:キプリングメソッドによるポリシー文の例(クレジットカードのプロテクトサーフェス)

例1は「引受担当者が、社内の管理端末から、営業時間内に、与信審査のために、MFA付きで引受審査アプリを使う」という一文に相当する。例2は「決済アプリのワークロードが、取引処理中に、mTLSで、カード会員データの該当レコードだけを読む」という一文である。この条件を満たさないアクセスは、すべて拒否される。

同じ要領で、外部SaaSを使う人(営業担当)と、非人間(ATM)の例も書ける。

問い例3:営業担当 → CRM(人・外部SaaS)例4:ATM → 決済取引(非人間)
Who役割=営業担当登録済みATM(証明書で識別)
What顧客訪問の記録をCRMに登録する現金引き出しの決済取引を実行する
When営業時間内営業時間内
Where自宅可(外出先)だが会社支給端末・SASE経由登録拠点のATM網からのみ
Why訪問記録という業務上の必要利用者の引き出し要求に応じる
HowSASE経由+MFA、CRM側は自社経由のみ許可クライアント証明書+EMV認証、限度内に制限

表3:キプリングメソッドによるポリシー文の例(つづき)

例3の営業担当は、外出先の自宅からでもCRMに記録できるが、会社支給端末でSASE経由に限る。CRM(SaaS)側は自社経由のアクセスだけを通す。例4のATMは、登録拠点・クライアント証明書・EMV認証・限度額という条件で、決済取引だけを許す。人か非人間か、内部か外部SaaSかで、5W1Hの埋め方が変わるのが分かる。

これらのポリシーが、第3回で配置したどのPEPで実行されるかを対応づけると、次のようになる。プロテクトサーフェスへの各アクセス(フロー)に対してポリシーを定義し、その経路上のPEPが適用・強制する、という関係が見て取れる。

プロテクトサーフェスへのアクセス(フロー)ポリシーの要点(許可する条件・それ以外は拒否)適用・強制するPEP
顧客/営業担当 → カードWebアプリ(入口)顧客=MFA+既知デバイス/営業担当=SASE経由・会社支給端末・営業時間内入口のPEP
カードWebアプリ → 引受審査(内部)引受担当者=社内/VPN+管理端末+MFA、営業時間内、与信判定のみアプリ手前のPEP
アプリ → カード会員データ(最重要データの手前)決済アプリのサービスアカウント=mTLS+該当レコードのみ。人間の直接アクセスは拒否データ手前のPEP
引受審査 → 信用調査機関(外部接続)与信照会のトランザクションのみ(想定プロトコル・宛先)外部接続のPEP
ATM → 決済取引(非人間の入口)登録済みATM+クライアント証明書+EMV認証、限度額内ATM経路のPEP

表4:プロテクトサーフェスへの各アクセスに対するポリシーと、それを実行するPEP

たとえば「アプリ → カード会員データ」のフローには、決済アプリのサービスアカウントがmTLSで該当レコードだけを読むというポリシーを定義し、データ手前のPEPがそれを強制する。人間が直接クエリしようとしても、このPEPで拒否される。ポリシーはあくまでプロテクトサーフェス(守る対象)を主語に作り、PEPはその実行場所である、という点がここでも確認できる。

1回のアクセスがどう実行されるか — 人と非人間で追う

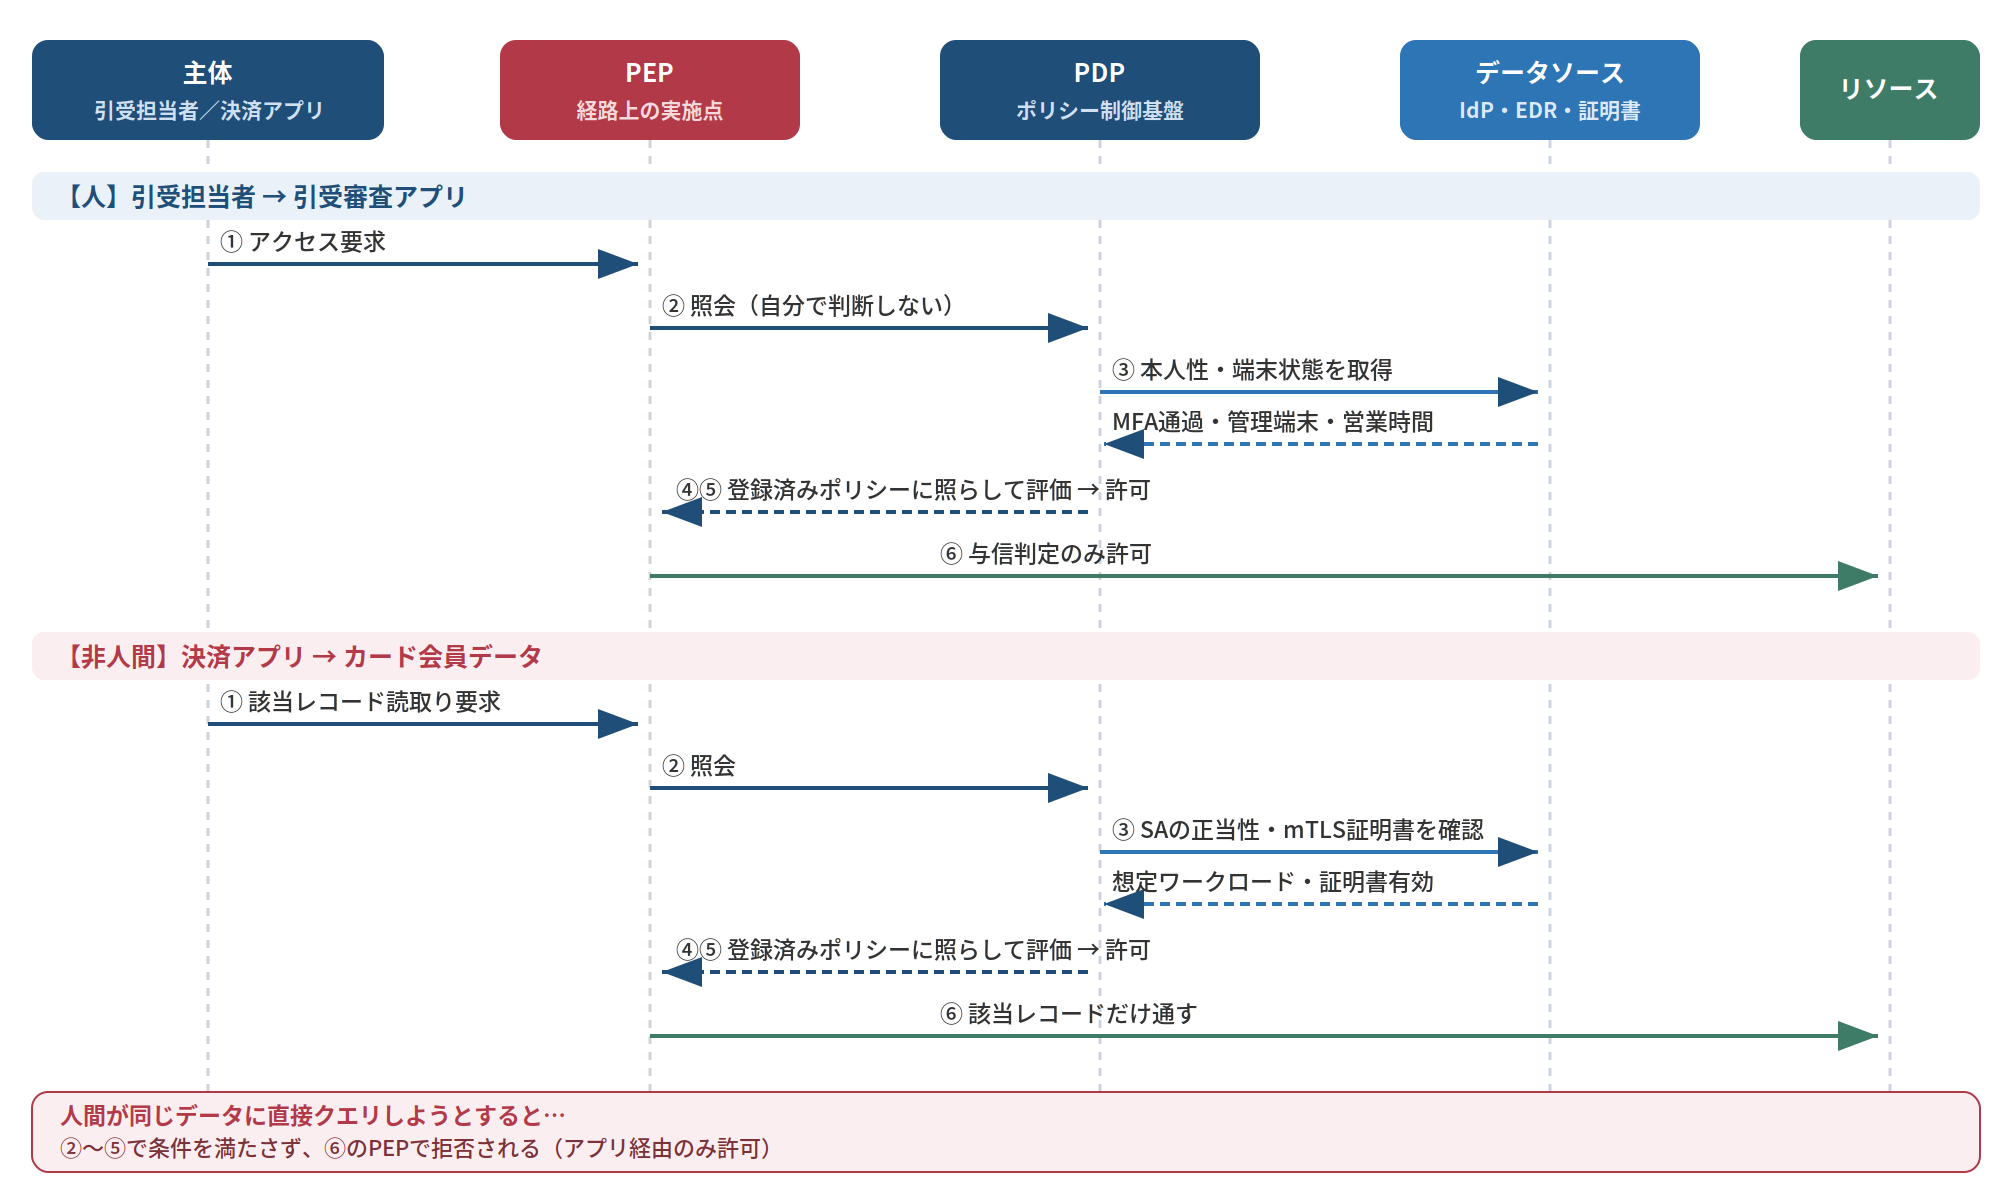
「配置したPEPが、PDPの判断に従ってポリシーを実行する」を、実際の1回のアクセスで具体的に追ってみる。人(引受担当者)と非人間(決済アプリ)の2本を並べると、判断材料(データソース)が違っても、流れは同じであることが分かる。

図4:1回のアクセスが実行される流れ(人・非人間の2例)

【人】引受担当者が引受審査アプリにアクセスする1回:

  • ① 要求:引受担当者の要求が、アプリ手前のPEPに届く。
  • ②③ 照会・評価:PEPは自分で判断せず、PDPに照会。PDPはデータソースで本人性(IdP/MFA通過)、端末状態(管理端末か)、時間(営業時間内か)を確認する。
  • ④⑤ 判定:ポリシー『引受担当者=社内/VPN+管理端末+MFA、与信判定のみ』に照らして許可と判定し、PEPに返す。
  • ⑥ 強制:PEPが許可を強制し、与信判定の操作だけを通す。

【非人間】決済アプリがカード会員データを読む1回:

  • ① 要求:決済アプリのサービスアカウント(SA)が、該当レコードの読取りを要求する。
  • ②③ 照会・評価:PEPがPDPに照会。PDPはSAの正当性とmTLS証明書の有効性、要求元が想定ワークロードかを確認する(ここでの判断材料は、人の場合のMFA・端末状態ではなく、証明書・ワークロードの正当性)。
  • ④⑤⑥ 判定・強制:ポリシー『決済アプリのSA=mTLS+該当レコードのみ』に照らして許可し、PEPが該当レコードだけを通す。

もし人間が同じカード会員データに直接クエリしようとすると、②〜⑤で条件(SA・mTLS・想定経路)を満たさないため、⑥のPEPで拒否される。同じデータでも、正規のワークロード経由なら通し、それ以外は止まる。これが「ポリシーをPDPが評価し、PEPが実行する」の具体像となる。

ステップ3(CBAC)とのつながり

第3回で見たCBAC(コンテキストベースアクセス制御)と、このステップ4は表裏一体である。キプリングメソッドで書いた5W1Hが、そのままCBACの評価属性になる。Whoは主体の役割、Whereは場所・ネットワーク、Whenは時間、Howは技術的統制。これらをPDPのポリシーエンジンが評価し、PEPが強制する。つまり、ステップ4で「ルールを言葉で定義」し、ステップ3のアーキテクチャで「そのルールを実行」する、という関係になる。

特権アクセス(管理者)のポリシー

ポリシー作成で、とりわけ慎重に扱うべきなのが管理者(特権)アクセスである。管理者は多くのシステムに広くアクセスできるため、攻撃者にとって格好の標的であり、ひとたび乗っ取られると内部を横移動され、影響範囲が一気に広がる。だからこそ、通常ユーザー以上に厳格なポリシーを敷く。CSA文書も特権アクセスの制御を重要な統制として挙げている。ここでも、ステップ1〜4の流れがそのまま効いてくる。

  • 踏み台を独立したプロテクトサーフェスにする(ステップ1):管理作業は、隔離できる踏み台(jump host/bastion)からのみ行う。踏み台自体を1つのプロテクトサーフェスとして定義する。
  • アイデンティティの分離(ステップ2):普段のアカウント(メール・チャット等)と管理用アカウントを完全に分ける。「山田」と「管理者・山田」は別ID・別環境とし、インターネットにつながる普段の端末から管理作業をしない。こうしないと許可すべきフローが増え、横移動が容易になる。
  • 踏み台への到達を最も固く(ステップ3・4):まずネットワークで絞る(社内の限定IP/ユーザーIDからのみ)。ネットワーク到達が無ければ攻撃者は何もできない。認証は、ID・パスワードだけでは弱いため、クライアント証明書+MFAトークンを重ねる。
  • PAM・短命セッション:特権アクセス管理(PAM)で、対象システムへの権限をその都度要求させ、短命の認証情報(短寿命のSSHトークン等)で、必要な間だけ付与する。踏み台から管理対象への接続も同様に絞る。
  • 踏み台の上でできることを絞る:メールもインターネットアクセスも不可。外部へは出させず、内部の必要な資源(ファイル共有、コンテナレジストリ等)だけに限定する。OS更新なども、ダウンロードをスキャン・ハッシュ検証するプロキシ経由で取り込み、時間帯も制限できる。最も避けたいのは、踏み台に遠隔操作ツールを仕込まれることである。
  • できれば映像のみ(KVM):最も厳格にするなら、データ転送を伴わない映像(KVM)アクセスに限る。一般にはRDPで踏み台に入る運用が多い。

狙いは、万一、踏み台が侵害されても攻撃者に何もさせないこと、つまりデータを持ち出せず、指示(マルウェア等)も送り込めない状態にする。そして、踏み台にアクセスする全員を監査する。この監査こそ、次回のステップ5(監視と保守)につながる。なお、いまは管理用アカウントを分ける組織は増えたが、依然としてインターネットにつながる普段の端末から管理作業をしている例が多く、ここは改善の余地が大きい。

インシデントの検知と対応

ステップ4は、アクセスポリシーを定義するだけではない。CSA文書は、ステップ4の活動にインシデント検知・対応メカニズムの構築も含めている。ポリシーに反するアクセスや、正常な動作からの逸脱を検知したら、アラートを上げ、遮断や再認証などの対応につなげる。第2回でマッピングしたトランザクションフローが「正常の基準」となり、そこからの逸脱が検知の手がかりになる。

ファイアウォールだけではない — ポリシーの適用先

「ポリシー」と聞くとファイアウォールのルールを思い浮かべがちだが、ゼロトラストポリシーの適用先はそれだけではない。ステップ3で選んだ各コントロールに、それぞれポリシーを与えて初めて機能する。

  • SaaS/クラウド:クラウドは「誰でも扉を叩ける」のが弱点。SASE(クラウド上のファイアウォール)で通信を自社経由に集約し、SaaS側で「自社を経由した通信だけを許可する」よう設定する。その”自社経由である”ことを伝える手段として、大きめのSaaS(Microsoft 365・Google・Salesforce等)では通信に目印を差し込むヘッダー挿入、小さめのSaaSでは自社の出口IPだけを通すIP許可リストを使う。いずれも入口が自社経由に限定され、インターネットからの直アクセスを排除できるため、アタックサーフェスが大きく下がる。
  • エンドポイント(XDR):コントロールがあっても、ポリシーがなければ何も止めない。たとえばカード会員データを扱うサーバーや引受担当者の端末で、ランサムウェア防御モジュールを有効化し、DBに触れてよいアプリを許可リストで限定する(未知のプロセスがカード会員データに触れたら遮断)。
  • アイデンティティ基盤(IdP):条件付きアクセスで、場所・時間・デバイスまで絞る。たとえば引受担当者のログインは『社内/VPN+管理端末+営業時間内+MFA』でのみ許可し、私物端末や深夜・国外からは追加認証か拒否とする。MFAも“ただ有効”では不十分で、設定を誤ると穴になる。
適用先クレジットカードでの具体例狙い
SaaS/SASE規制報告の提出ポータルや営業のCRMを、SASEで自社経由に集約し、SaaS側は『自社経由のみ許可』外部からの直接アクセスを排除
エンドポイント(XDR)カード会員データを扱うサーバーと引受担当者端末に、ランサム防御を有効化+DBに触れるアプリを許可リスト化端末・サーバー側で不正を遮断
IdP(条件付きアクセス)引受担当者は社内/VPN+管理端末+営業時間+MFAでのみログイン可。私物・深夜・国外は追加認証/拒否ログインの入口を状況で絞る

表5:ポリシーの適用先と、クレジットカードでの具体例

すべてに共通する原則は、具体的であること、そして業務上の正当性があることである。「全員がインターネットへ」のような広すぎるルールは避ける。理由(業務上の必要)がないポリシーは、そもそも作らない。

ポリシーの検証と見直し — 最も見落とされがち

ポリシーは作って終わりではない。むしろ検証(見直し)こそ最も見落とされがちな工程である。新しいアプリを動かすためにルールを足すのは自然に起きるが、アプリが廃止されてもルールは自動では消えないし、誰も困らないので放置され、ポリシーが腐敗(decay)していく。検証では、少なくとも次を確認する。

  • ステップ2と突き合わせる:そのフローは、ステップ2で「このプロテクトサーフェス間の通信は許す」と決めたものか。新たな要望なら、両プロテクトサーフェスの業務オーナー同士が合意して初めて許可する。
  • 具体的で、十分に厳格か:any/any のような広いルールを残さない。L4(ポート)ではなくL7(アプリケーション)で書き、必要ならスキャンや復号まで行う。
  • ツールの機能を使い切る:機器の自動更新で増えた新機能が未使用のまま眠りがち。たとえば新しいURLフィルタのカテゴリが追加されるとき、業務を止めないよう既定で「許可」で入ることが多い。ところがこの「許可」は、通信を通すだけでログも残さない設定になっていることが多く、その結果、該当する通信が起きていても管理者からは見えない(可視性が失われる)。更新のたびに、こうした新機能・カテゴリの設定を点検する。
  • 自動化する:PEPは多いので、変更のたび/毎日、構成を取得して整合を自動チェックするのが理想。難しければ、定期的に人が見直す。

この見直しは、5ステップを一度で終わらせず、繰り返し回していくことの一部でもある。業務オーナーの交代はステップ1、新たな通信要望はステップ2、新しいコントロールの必要はステップ3と、変化に応じて各ステップに戻る。ポリシーが「最初は静的でも、運用しながら動的に育つ」のは、この反復があるからである。まず1つのプロテクトサーフェスで作り込み、成熟させてから次へ広げる、という「練習台から本命へ」の考え方(第1回)も、ここで効いてくる。

ポリシー作成・検証の実務ポイント

  • デフォルト拒否から始め、必要なアクセスだけを明示的に足していく
  • 具体的に(広すぎる any/any を避け、L7・業務の言葉で書く)
  • 人と非人間(ワークロード・API・ボット・デバイス)の両方をWhoに含める
  • 業務上の正当性がないポリシーは作らない/廃止時はルールも消す
  • 自動で構成を点検し、更新で増えた機能・カテゴリの取りこぼしを防ぐ

まとめ

第4回では、配置したPEPにルールを与えるゼロトラストポリシーを作るステップ4を扱った。要点は次のとおりである。

  • ポリシーはアプリケーション層(L7)で、最小特権・デフォルト拒否を原則に、プロテクトサーフェスの近くで適用する
  • 書き方はキプリングメソッド(Who・What・When・Where・Why・How+どれだけの時間)。人だけでなく非人間も対象にする
  • 5W1HはそのままCBACの評価属性になり、ステップ3のアーキテクチャが実行する
  • 適用先はファイアウォールだけでなくSaaS/SASE・エンドポイント・IdPにも及ぶ。管理者アクセスは踏み台・アイデンティティ分離で特に厳格にする
  • 作って終わりにせず検証・見直しを(自動で)繰り返す。廃止時はルールも消し、静的から動的へ育てる
  • ステップ4にはインシデント検知・対応の構築も含まれる

守る対象を定め(1)、流れを可視化し(2)、アーキテクチャを構築し(3)、ポリシーを作った(4)。最終回(第5回)は、ステップ5「監視と保守」を扱う。すべてのトラフィックをアプリケーション層まで検査・記録し、そのテレメトリを使って、プロテクトサーフェスを継続的に強くしていく。ゼロトラストを「作って終わり」にしないための最後のステップである。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第3回:ステップ3  ゼロトラストアーキテクチャの構築

2026年8月29日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回で守る対象(プロテクトサーフェス=DAAS)を定義し、第2回でその周りのトランザクションフローを可視化した。守るものと、その動きが見えたら、次はいよいよ実装である。ここでは、ステップ3「ゼロトラストアーキテクチャの構築」を扱う。

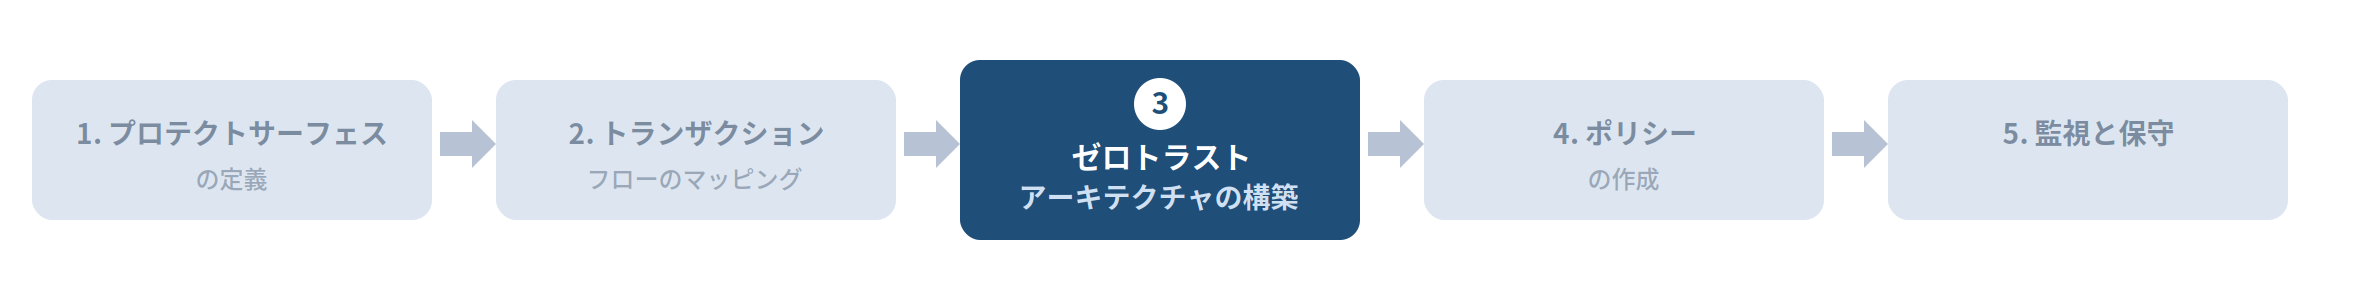
図1:ゼロトラスト導入の5ステップと、本ブログが扱うステップ3(CSA文書の5段階プロセスを基に作成)

ステップ3のねらいは、第2回でマッピングしたトランザクションフローを基盤に、ポリシー実施ポイント(PEP)を適切に配置したゼロトラスト環境を設計することである。「誰が・何に・どんな状況でアクセスできるか」を、各プロテクトサーフェスの出入口で実際に検証・制御できる形に落とし込んでいく。

おさらい:ゼロトラストの原則

アーキテクチャを設計する前に、拠り所となる原則を確認しておく。ゼロトラストは、次のような考え方に立っている。

  • 敵対的な環境を想定する/すでに侵害されていると想定する(assume breach)
  • 決して信頼せず、常に検証する(既定で拒否し、ユーザー・デバイス・アプリ・トランザクションを継続的に検証)
  • 明示的に精査する(複数の属性を用いて、安全な方法で一貫してアクセスさせる)
  • 統合的な分析を適用する(データ・アプリ・ネットワークに横断的な分析と挙動監視を効かせる)

これらを設計に落とすと、次の原則になる。認証・認可が済むまでアクセスを与えない(パケット1つに至るまで検査)/アクセスは一時的で再検証が必要/最小特権(必要最小限のアクセスだけを付与)/コントロールの有効性を継続的に監視する。

ゼロトラストアーキテクチャの中核 — PDPとPEP

アクセスの可否を判断するには、まず3つの中核要素、通信(アクセス要求)・アイデンティティ(要求する主体)・リソース(守る対象)が必要になる。さらに、判断を支える2つの要素として、ポリシー(誰が・何に・いつ・どのようにアクセスできるかを定める規則)と、データソース(ポリシーを動的に更新するための状況情報)がある。

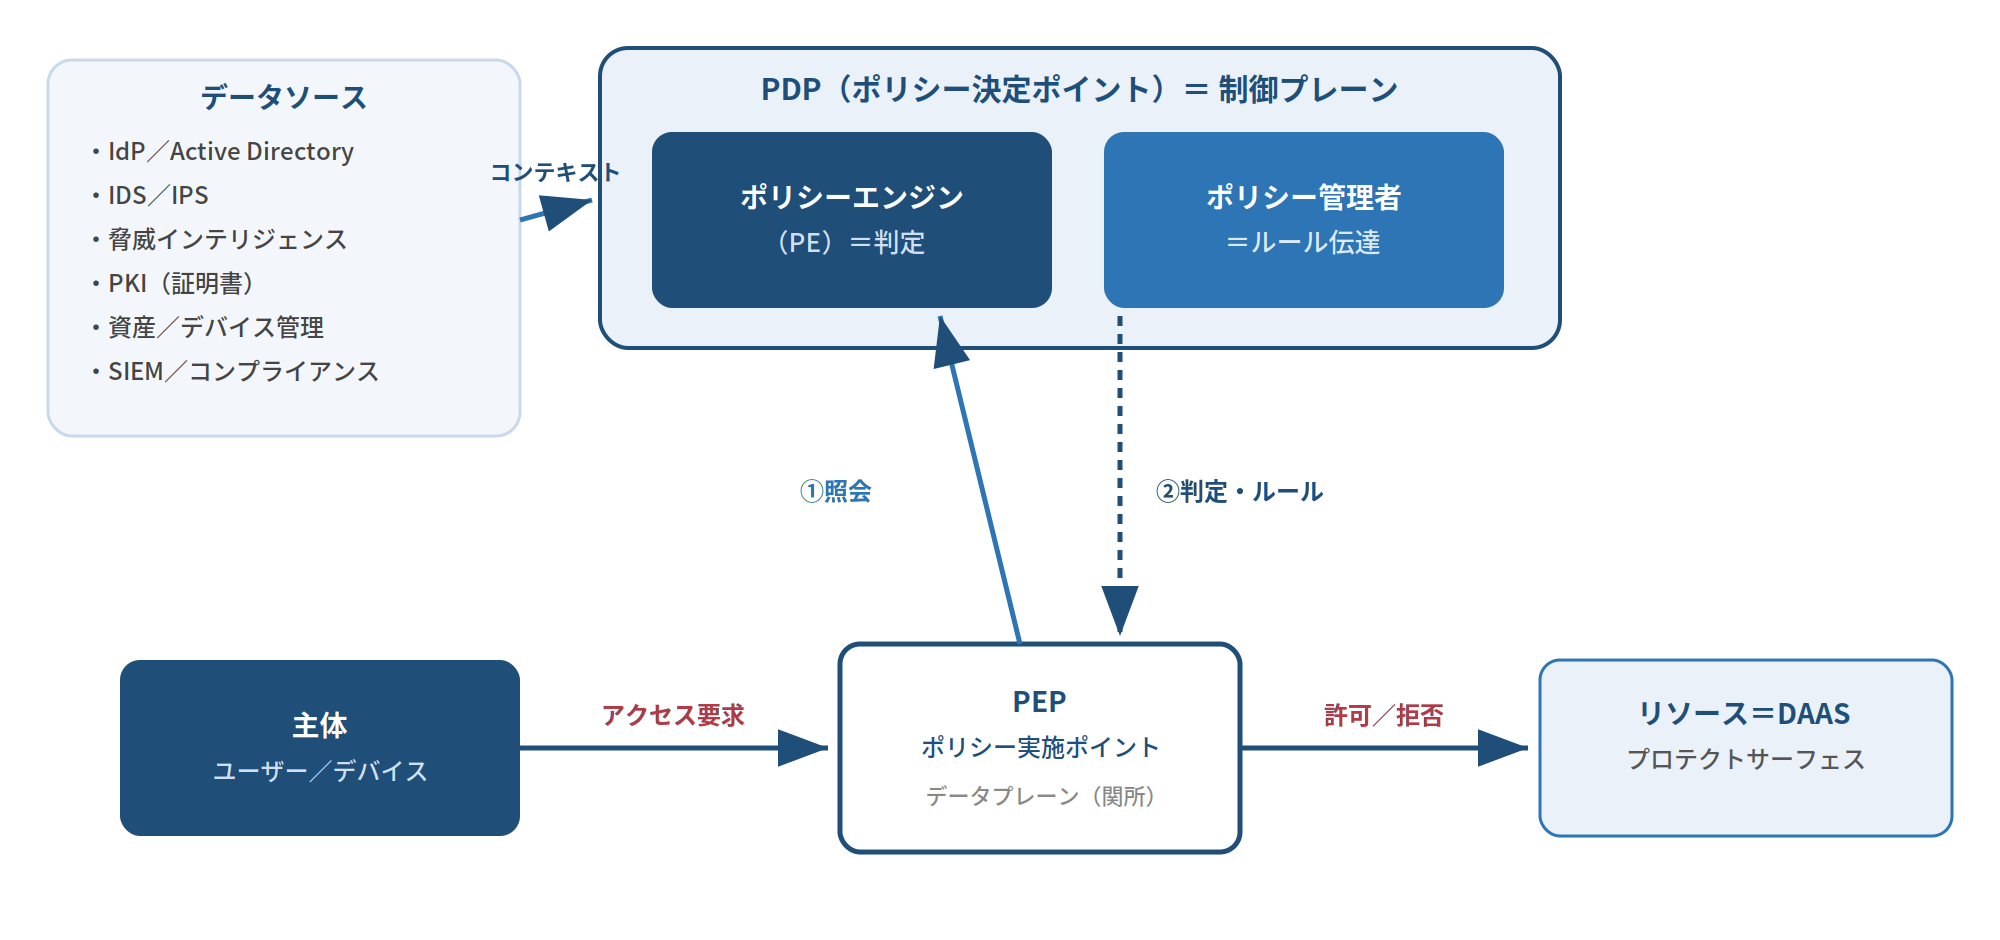
NIST SP 800-207 は、これを2つの仕組みで表現している。判断を下すPDP(ポリシー定義ポイント)と、それを実際に強制するPEP(ポリシー実施ポイント)である。両者はトラフィックのアクセス経路上に置かれ、リソースへのアクセスを制御する。

図2:ゼロトラストアーキテクチャの中核(PDP/PEP)(NIST SP 800-207 の論理モデルを基に作成)

  • PDP(コントロールプレーン):ポリシーエンジン(PE)とポリシー管理者からなる。データを分析してルールに変換し(PE)、そのルールをPEPに伝える(ポリシー管理者)。
  • PEP(データプレーン):ゲートウェイ(関所)として働き、正しい主体に、正しいアクセスレベルで、承認されたリソースへのアクセスだけを許可する。

PDPの判断は、多様なデータソースから供給される状況情報(コンテキスト)に支えられる。IdP/Active Directory、IDS/IPS、脅威インテリジェンス、PKI(証明書失効リスト)、資産・デバイス管理(CDM=継続的診断・対策など、資産のOS・ソフト構成や脆弱性・健全性を継続的に把握する仕組み)、SIEM、法令・規制要件などである。これらの情報が豊富なほど、より的確なアクセス判断ができる。

なお、ゼロトラストではPEPの数が大幅に増えるため、アクセスモデルを手作業で管理するのは現実的でない。自動化が、細かな制御と全体制御の両立に不可欠となる。

設計の柱 — 何を組み込むか

PDP/PEPという骨格の上に、以下のようなゼロトラストらしさを与える具体的な設計要素を組み込んでいく。

マイクロセグメンテーション

ネットワークをより小さな独立したセグメントに分割し、ワークロードやアプリ、デバイス単位で境界(マイクロペリメータ)を設ける。トランザクションフローの理解に基づいて論理的にグループ分けすることで、万一侵入されてもラテラルムーブメントを封じ込め、アタックサーフェスを縮小できる。

コンテキストベースのアクセス制御(動的ポリシー)(CBAC)

アクセス判断は静的ではなく、動的かつ状況依存で行う。ユーザーのアイデンティティ、デバイスの状態、場所、実行中のトランザクションといったコンテキストを評価して、その都度アクセスの可否を決める。第2回でマッピングしたトランザクションフローが、この判断材料になる。

最小特権

役割やアプリに不可欠なトランザクションだけを許可し、タスクの実行に必要な最小限のアクセスに制限する。トランザクションフローマッピングは「正常な動作の基準」を与えるため、そこからの逸脱や異常を検知し、アラートや対応につなげられる。

暗号化とデータ保護/監視とログ

通信・データを暗号化して保護する。あわせてデータ損失防止(DLP)で機微情報の持ち出しを防ぐが、暗号化された状態では中身を検査できないため、DLPは平文が現れる地点のエンドポイントや、通信を復号する検査ポイントで効かせる。また、集中型のログ記録と、SIEMによるリアルタイムのモニタリング・相関分析を導入し、コントロールの有効性を継続的に監視する。

実装パターン — アーキテクチャの選択肢

ゼロトラストアーキテクチャを実際に実現する方式には、代表的なものがいくつかある。いずれもPDP/PEPという共通の土台の上に立ち、相互に影響し合ってきた。用途に応じて選び、組み合わせることになる。

実装パターン特徴主な用途
SDP接続を事前検証(SPA等)し、認証・認可されるまで既定で全拒否。リソースを外部から隠すリソースの隠蔽、境界の動的生成
ZTNASDPとほぼ同じ発想。ユーザーとアプリのアクセスを検証し、必要なアプリだけに接続を許すリモートアクセス、VPN置き換え
BeyondCorpGoogleが自社向けに実装。所在地を信頼せず、デバイスとユーザーの状態で判断リモートアプリアクセス
NISTアプローチ(SP 800-207)PDP/PEPを中核とする論理アーキテクチャ。各方式に共通する土台設計の基本モデル

表1:代表的なゼロトラストアーキテクチャの実装パターン

プロテクトサーフェス単位で設計する

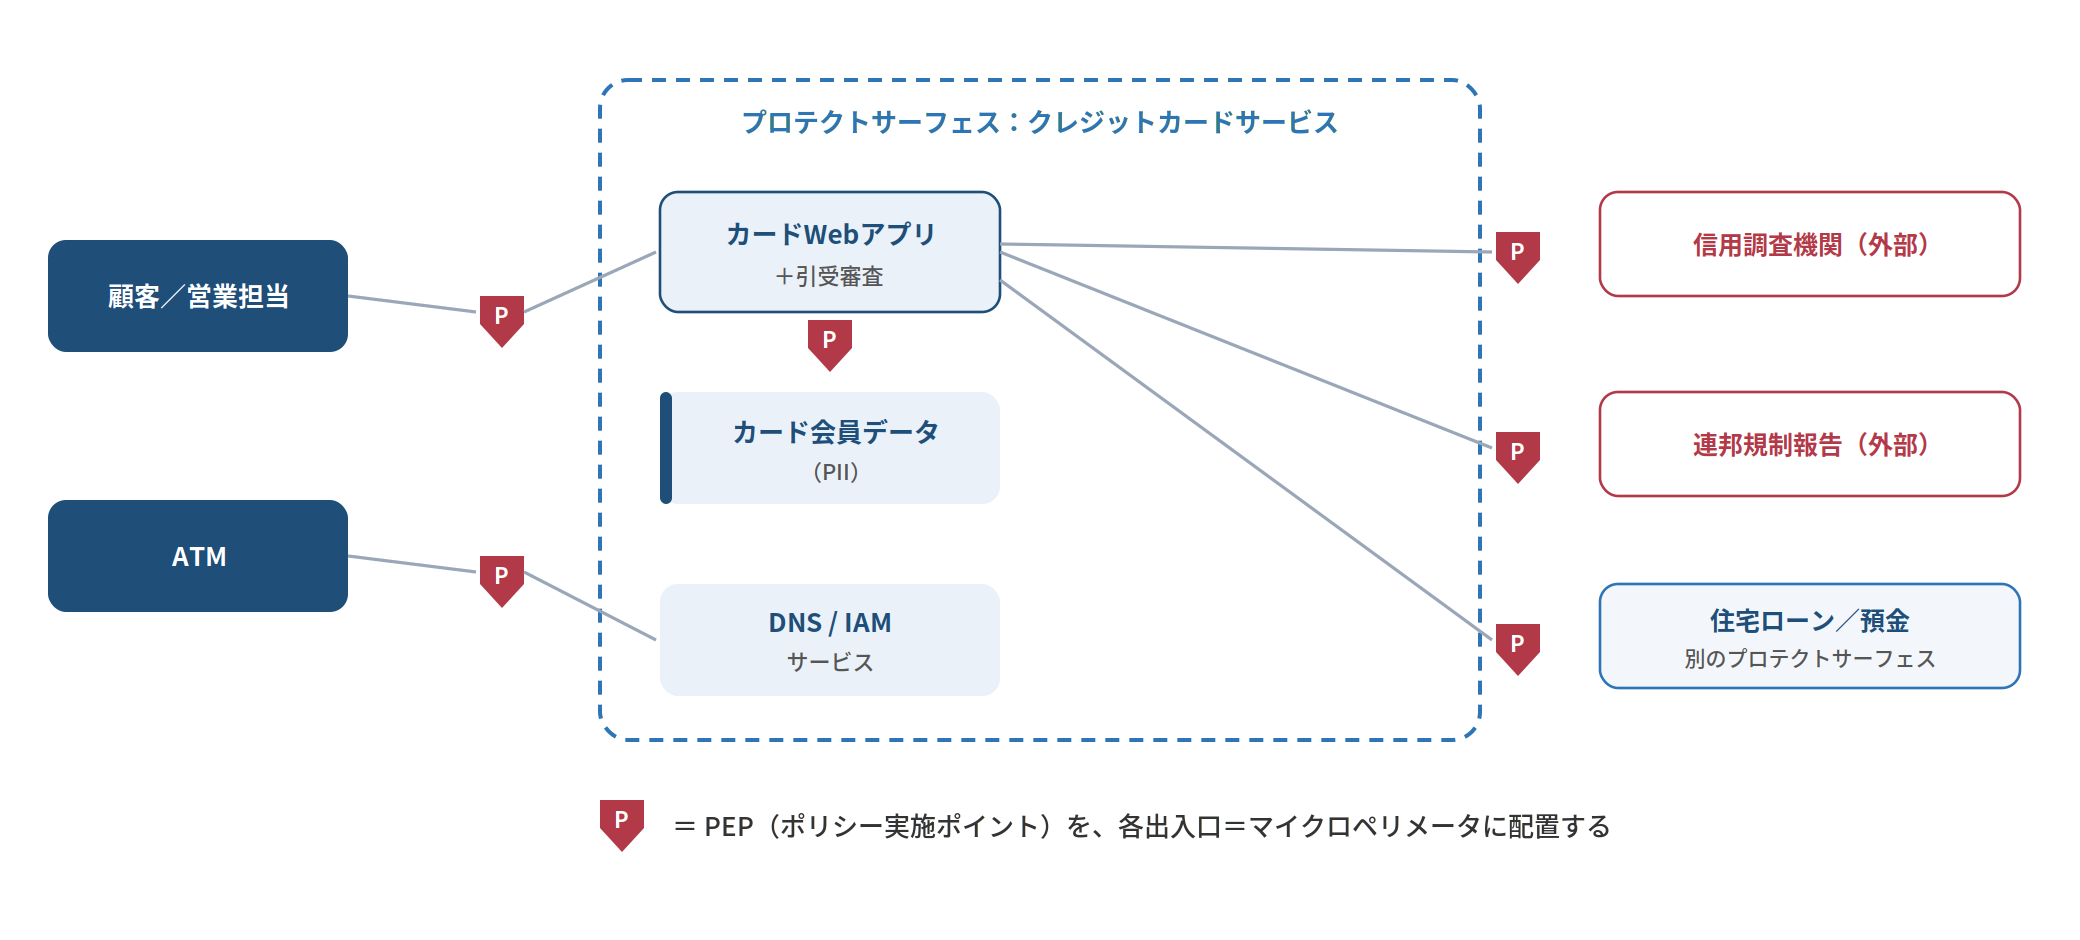
ゼロトラストアーキテクチャは、プロテクトサーフェスごとに、その出入口(マイクロペリメータ)へPEPを配置して設計する。第2回でマッピングした「どの主体が・どの経路で・どのDAAS要素にアクセスするか」を、そのままPEPの配置とポリシーに写し取るイメージである。

第1回・第2回で用いたクレジットカードサービスの例で示すと、次のようになる。

図3:クレジットカードのプロテクトサーフェスにPEPを配置する(CSA文書を基に作成)

顧客・営業担当・ATMからの入口、アプリとカード会員データの間、そして信用調査機関・規制報告・住宅ローン/預金といった外部・他システムとの接続点、それぞれにPEPを置き、マッピングしたフローに沿ったアクセスだけを許可する。組織によっては、まず粗い粒度のマクロセグメンテーションから始め、時間をかけてマイクロセグメンテーションへ進めるのが現実的な場合もある。

実際のアーキテクチャはどうなるのか

ここまでの図は、役割(誰が判断し、誰が強制するか)を示す論理アーキテクチャである。では、これを実際の構成に落とすと何になるのか。ポイントは、論理的な役割を具体的なコンポーネント(製品・機能)に割り当てることである。

  • PEPの実体:単一の製品ではなく、守るDAASの各出入口に分散した実施点の集合。次世代ファイアウォール、マイクロセグメンテーション製品、ゲートウェイ/プロキシ、SDP/ZTNAゲートウェイ、APIゲートウェイ、サービスメッシュのサイドカー(コンテナ)、エンドポイントのエージェントなど。
  • PDPの実体:ポリシーエンジンとポリシー管理者を担うポリシー制御基盤(ゼロトラスト管理コンソール、ポリシーサーバー、IdP/IGA、SDPコントローラ等)。PEPは判断を持たず、PDPに問い合わせて判定に従う。
  • データソースの実体:IdP/AD、IDS/IPS、EDR、脅威インテリジェンス、PKI、資産管理、SIEM等が、PDPに状況(コンテキスト)を供給する。

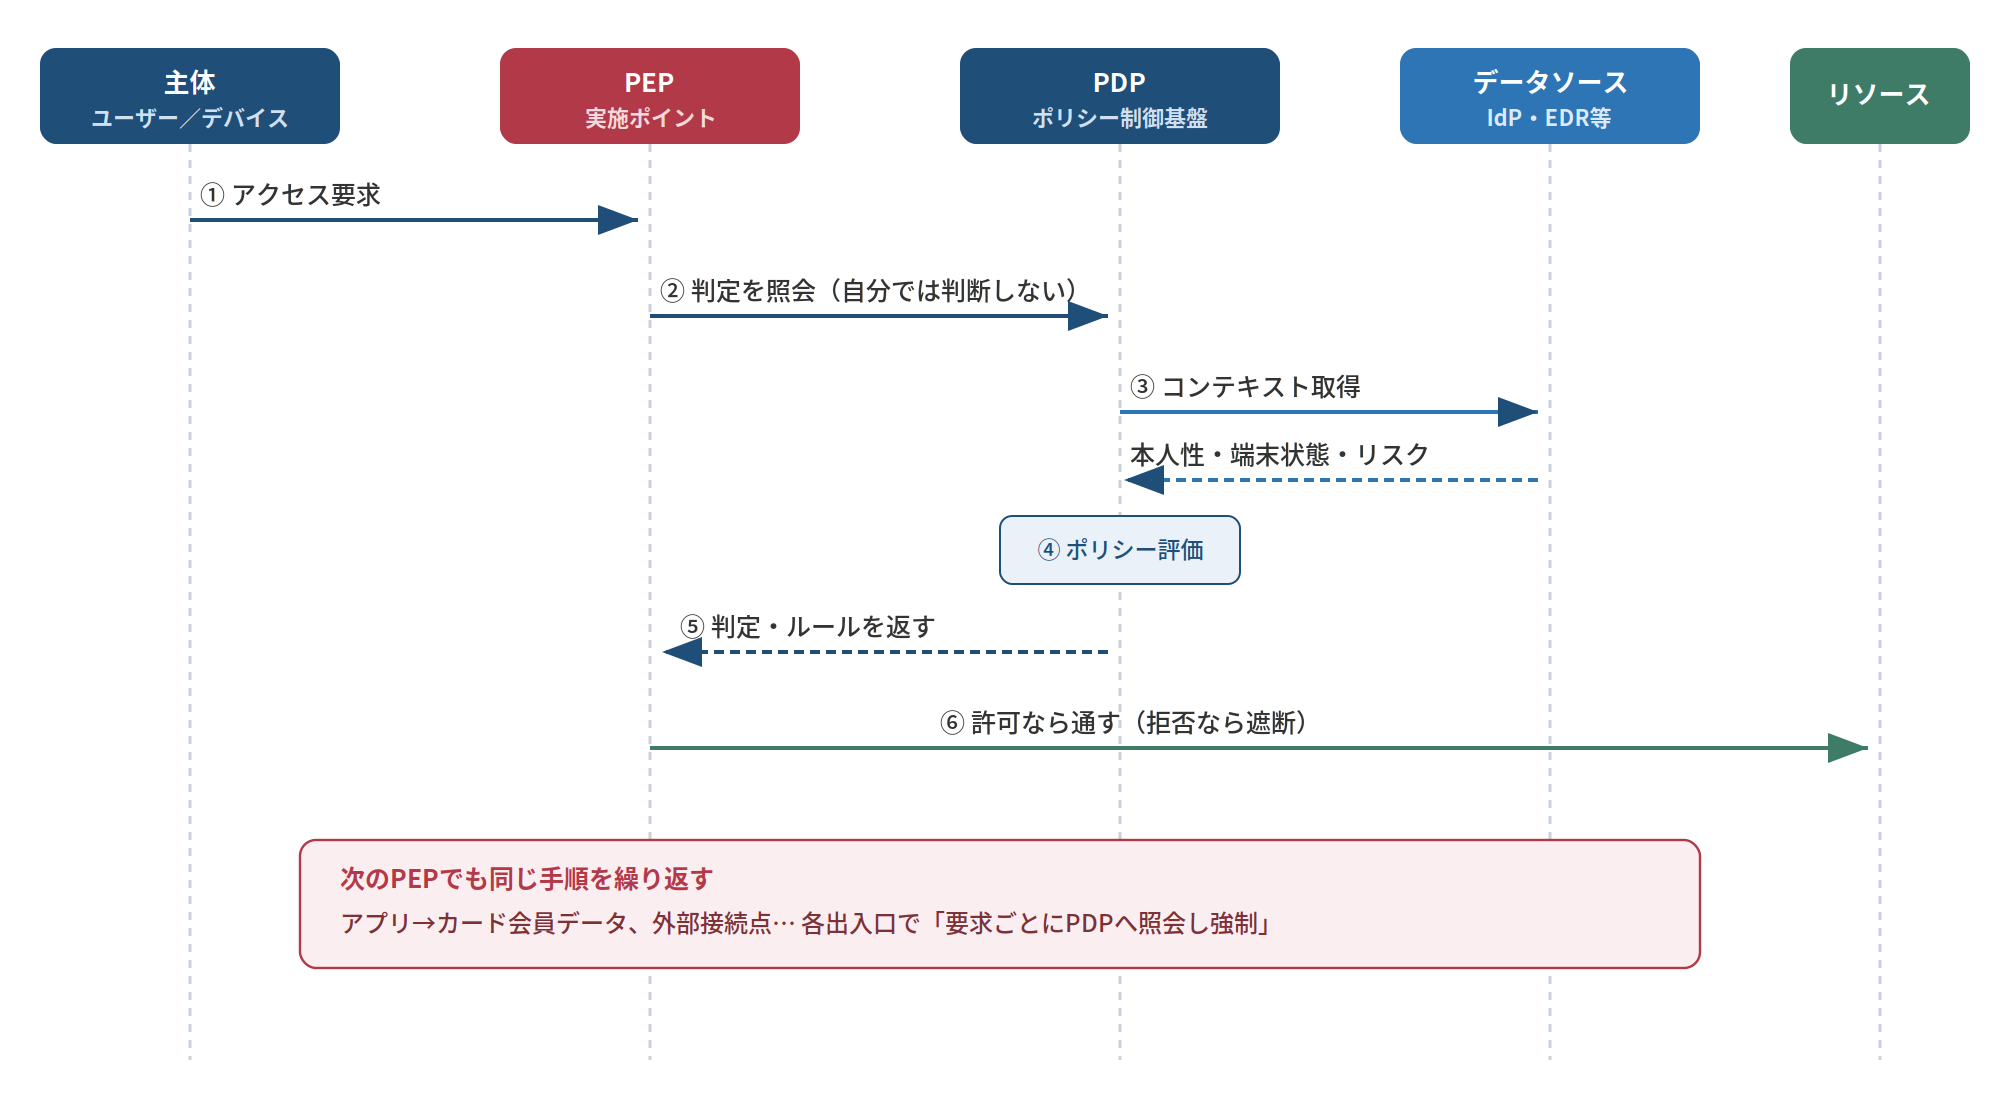
そして、1回のアクセスがどう流れるかを追うと、実際の動作が見えてくる。クレジットカードの例で、顧客がカードWebアプリにアクセスする場面を示すと以下のようになる。

図4:1回のアクセスがゼロトラストで処理される流れ(NIST SP 800-207 のPDP/PEPモデルを基に作成)

要求はまずアプリ手前のPEPに届くが、PEPは自分では判断せず、PDPに照会する。PDPはデータソース(IdPで本人性、EDRで端末状態、脅威インテリジェンスでリスク)を評価してポリシーに照らし、判定をPEPに返す。PEPは許可/拒否を強制し、許可ならアプリへ通す。さらにアプリからカード会員データへ進む際には、その間の別のPEPが同じ手順を繰り返す。

この「各出入口で、要求ごとに、PDPへ照会して強制する」という反復こそが、ゼロトラストの実際のアーキテクチャの姿である。従来の境界防御のように「一度入れば中は自由」ではなく、どのPEPも毎回PDPに確認する。前掲の実装パターンでいえば、SDP/ZTNAはコントローラ(PDP役)とゲートウェイ(PEP役)、BeyondCorpはアクセス制御エンジン(PDP役)とアクセスプロキシ(PEP役)として、この構図を実現している。

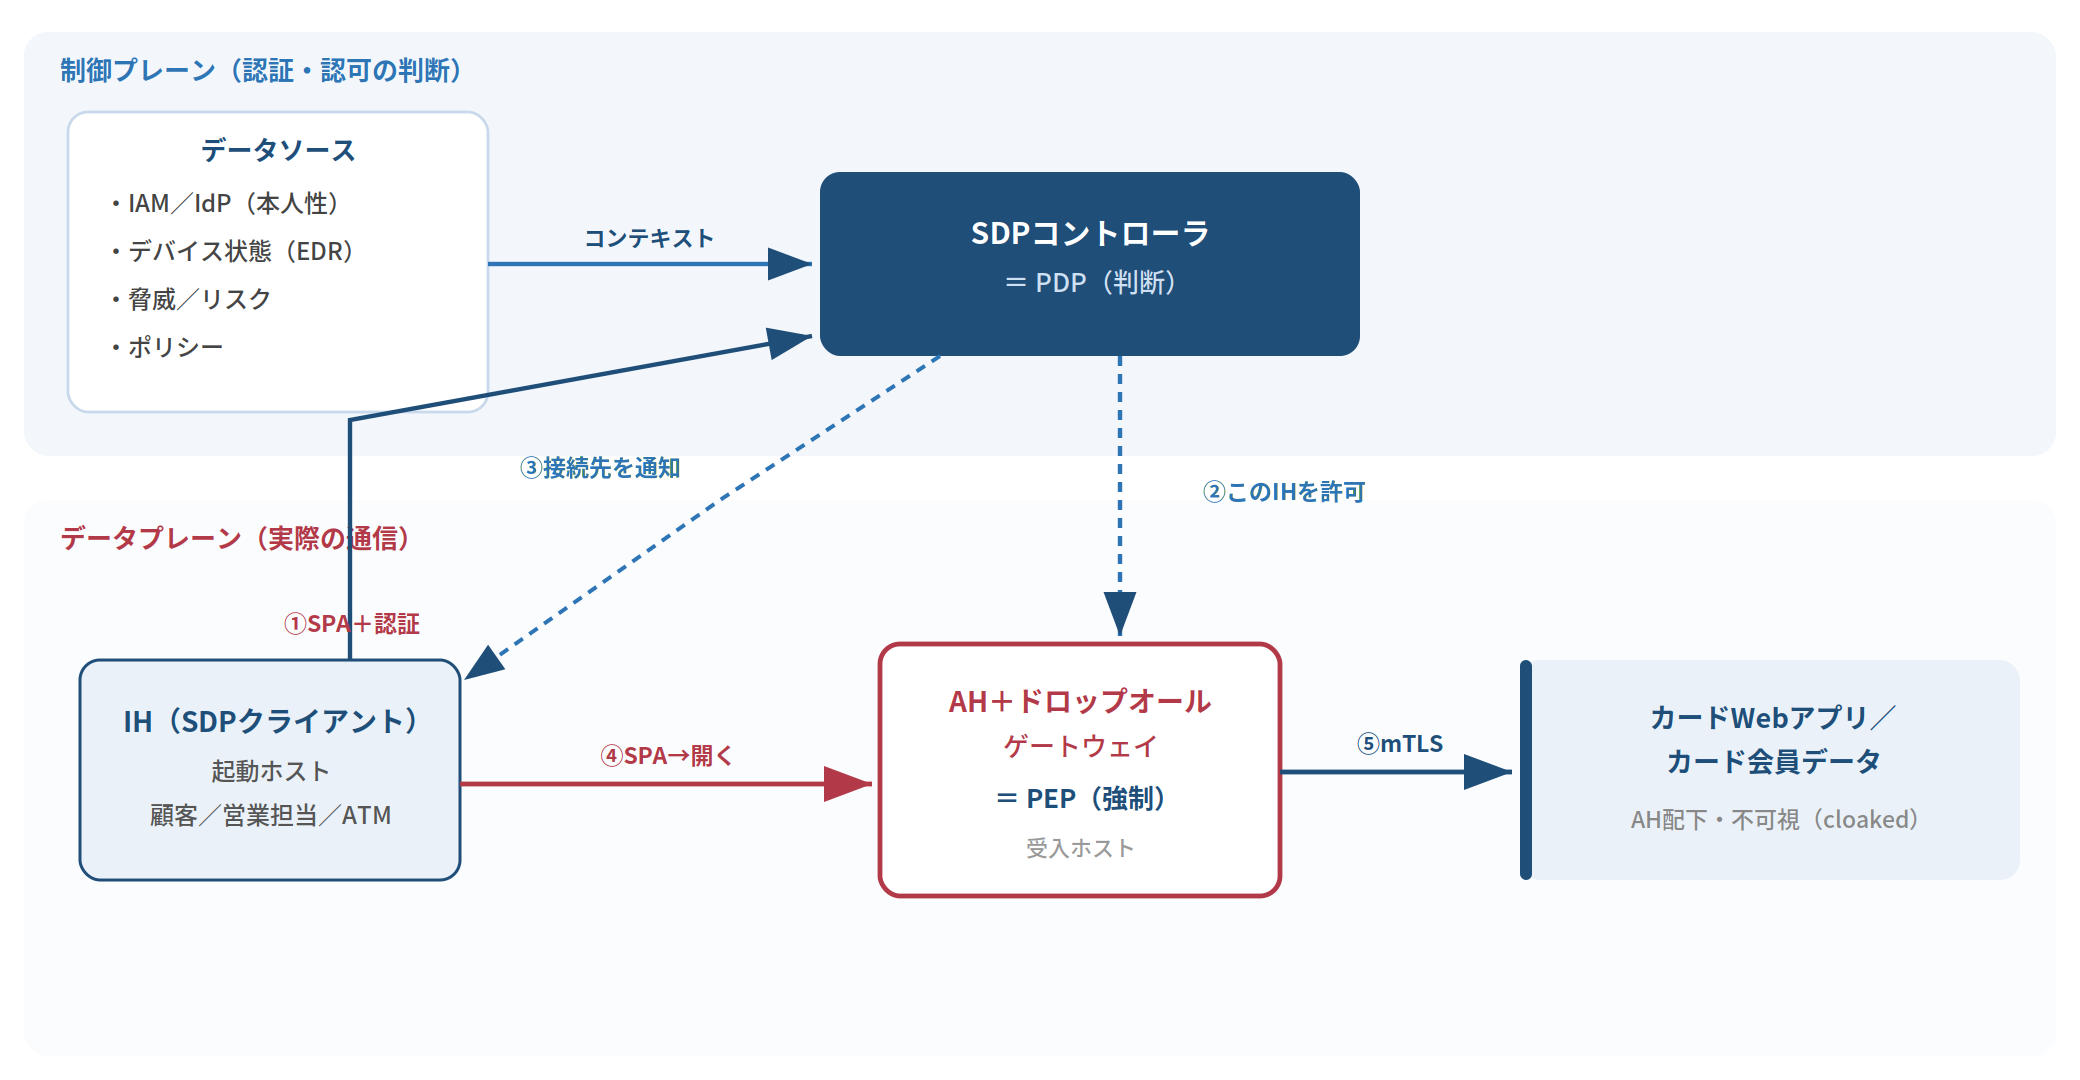
具体例:SDPによるベンダーニュートラルな実装

ここではSDPを使ってアーキテクチャの実装をもう少し具体化してみる。CSAのSDPは、特定製品に依存しない標準仕様として構成要素が定義されており、ベンダーニュートラルな実装例として分かりやすい。SDPは次の3つの要素からなる。

  • IH(起動ホスト):SDPクライアントを載せた接続元の端末(顧客・営業担当の端末、ATMなど)。暗号署名した接続要求を出す。
  • AH(受入ホスト)+ドロップオール・ゲートウェイ:守るサービスをホストする側。既定ですべての通信を落とし(ドロップオール)、認可されるまで外部から見えない(cloaked)。つまり、PEPの実体。
  • コントローラ:コントロールプレーンで認証・認可を判断する頭脳。IAMなどのデータソースを参照する。つまり、PDPの実体。

これらを、クレジットカードサービスのプロテクトサーフェスに当てはめると、次のような構成になる。

図5:SDPによるベンダーニュートラルな実装例

顧客がカードWebアプリにアクセスするのは、次の順でつながる。

  1. ① IH → コントローラ:SDPクライアントが単一パケット認可(SPA)と認証情報を送り、本人性・デバイス状態を検証してもらう。(SPAの解説はこちらのブログを参照)。
  2. ②③ コントローラ → AH/IH:判断の結果、このIHが接続してよいAH(カードWebアプリ)をAH側に許可し、IHには接続先を通知する。
  3. ④ IH → AH:IHがAHにSPAを送ると、それまで全拒否だったドロップオール・ゲートウェイが、そのIHのためだけに開く。
  4. ⑤ IH ⇄ AH:相互TLS(mTLS)で暗号化された接続を直接確立し、はじめてデータが流れる。

ポイントは、認証・認可がすべて“接続の前”にコントロールプレーンで済むこと、そして許可されるまでリソースが存在すら見えない(ドロップオールで不可視)ことである。これにより、正体不明のトラフィックはそもそもリソースに到達できず、アタックサーフェスが大きく縮小する。コントローラ=PDP、AH+ゲートウェイ=PEP、という役割対応も、この例で明確である。

なお、ここで挙げたIH・AH・コントローラ・SPA・mTLS・ドロップオールはいずれもSDP仕様の用語であって特定製品名ではない。実際には、SDP・ZTNA・BeyondCorpといった枠組み(コントローラ=PDP、ゲートウェイ/プロキシ=PEP)のいずれかを土台に選び、そこへIdPやEDRといったデータソースを接続して実装する。

PDPの中身:CBAC(コンテキストベースアクセス制御)をどう実装するか

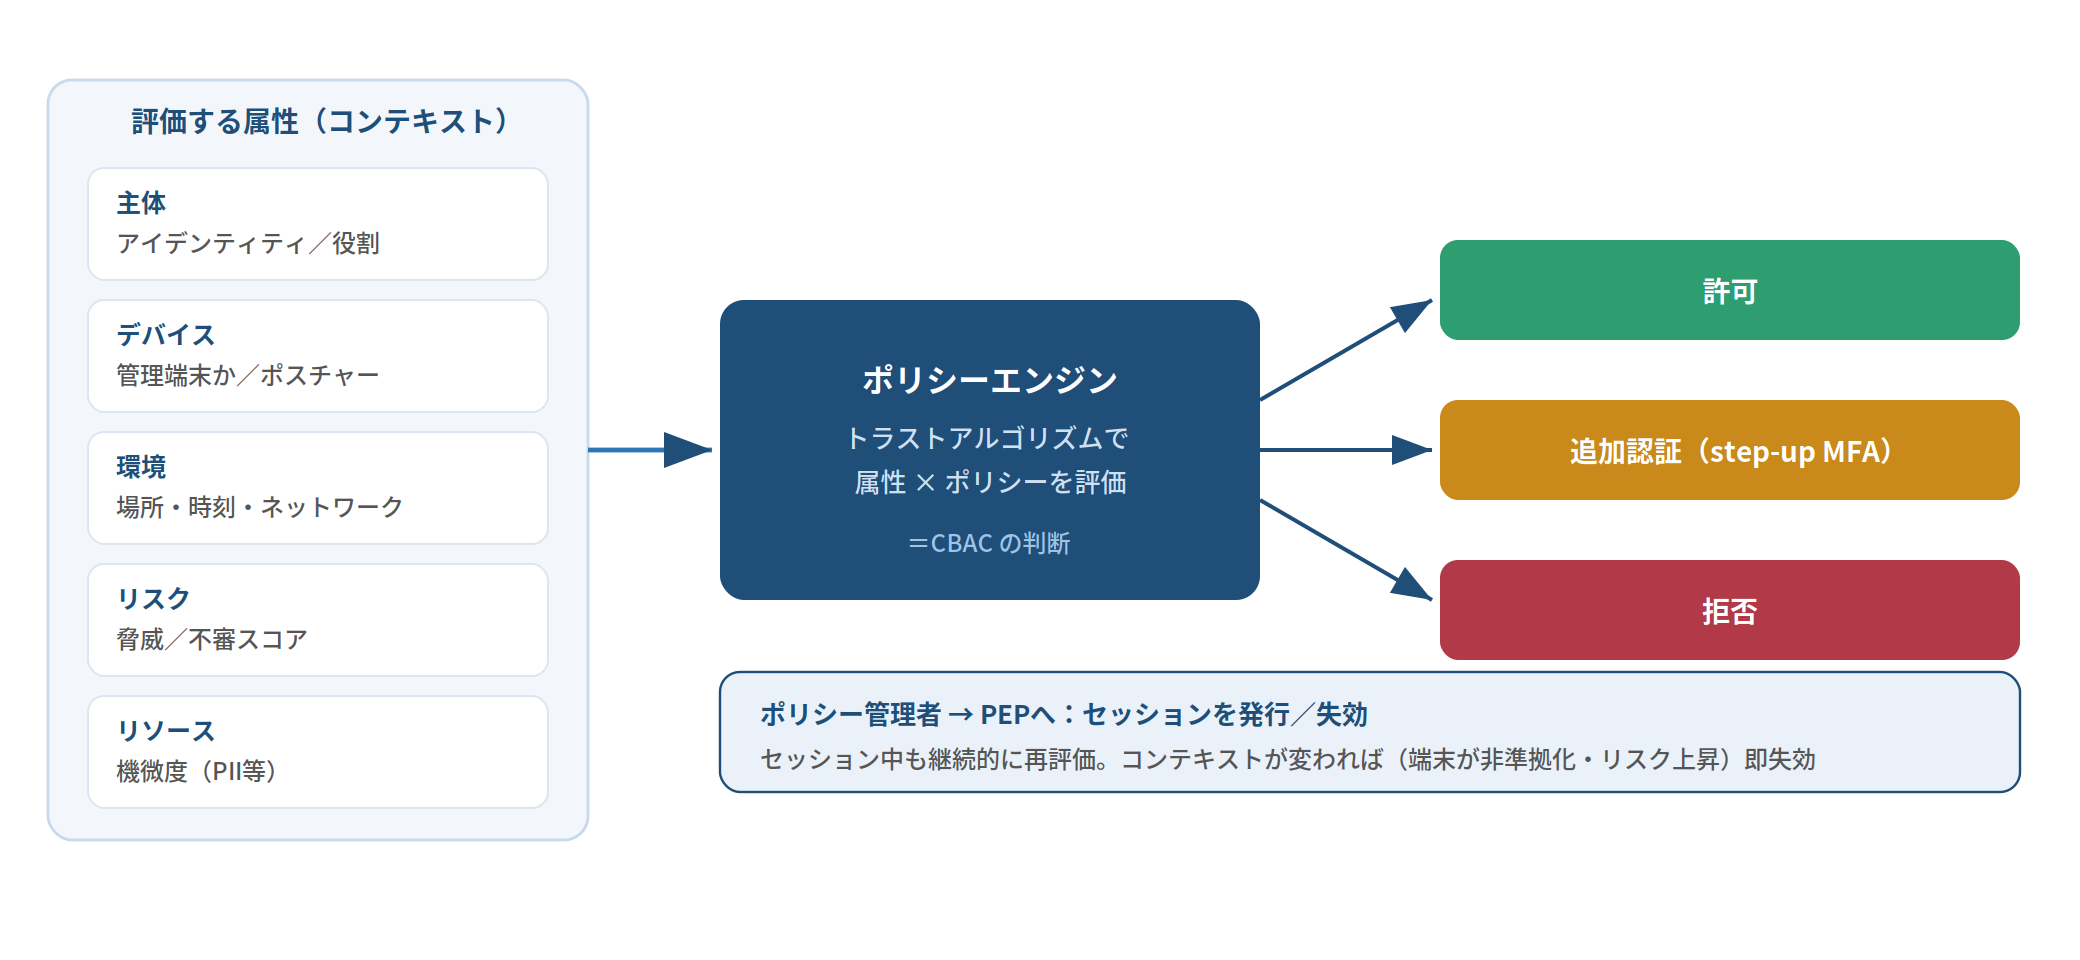
SDPの例では、AH+ゲートウェイ(PEP)が「どう強制するか」を具体化した。では、その判断を下すPDPの中身はどうなるのか。PDPはポリシーエンジン(PE)とポリシー管理者からなり、PEが「通す/通さない」を決め、ポリシー管理者がその判定をセッションとしてPEPに発行・失効させる。

PEの判断の核が、CBAC(コンテキストベースアクセス制御)である。従来のアクセス制御と並べると位置づけがはっきりする。

方式判断の基準特徴
RBAC(役割ベース)役割(ロール)だけで静的に許可を決めるシンプルだが状況を見ない
ABAC(属性ベース)主体・リソース・環境の属性を組み合わせて判断柔軟。ゼロトラストの土台
PBAC(ポリシーベース)属性を組み合わせたポリシー(ルール)で判断ルールとして表現・管理
★CBAC(コンテキストベース)PBACに加え、その場の状況(デバイス状態・場所・時刻・リスク)を入力として動的に評価アクセスのたびに評価し直す

表2:アクセス制御方式とCBACの位置づけ

CBACは、ABAC/PBACの一種と捉えられるが、環境・状況の属性(コンテキスト)を重視し、アクセスのたびに動的に評価し直す点が要である。PEは、集めた属性をポリシー(=トラストアルゴリズム)に照らし、「許可/追加認証(step-up)/拒否」を決める。

図6:PDPによるCBACの判断(NIST SP 800-207 のトラストアルゴリズムを基に作成)

クレジットカードの例で、引受担当者が引受審査アプリにアクセスする場面のポリシーを、擬似的に書くと次のようになる。

CBACポリシーの例(引受審査アプリへのアクセス)

  • もし〔役割=引受担当者〕かつ〔端末=管理端末で準拠〕かつ〔場所=社内/既知〕かつ〔MFA=通過〕かつ〔リスクスコア<しきい値〕ならば → 許可(セッションは短時間で失効。以後も再評価)
  • 端末が非準拠、または見知らぬ場所・時刻 → 追加認証(step-up)を要求
  • リスクスコアが高い、または権限外 → 拒否

重要なのは、この判断が一度きりではないことである。セッションの発行後も継続的に再評価し、途中で端末が非準拠になったり、リスクが上昇したりすれば、その場でアクセスを失効させる。これが「常に検証する」を実装レベルで成り立たせる仕組みであり、静的なRBACとの決定的な違いである。

なお、トラストアルゴリズムには、条件をすべて満たすかで判断する基準ベース(criteria-based)と、各属性に重みをつけてスコアで判断するスコアベース(score-based)がある。またリソースごとに独立して判断するか、主体の直近の行動履歴まで加味する(コンテキスト型)かでも設計が分かれる。組織のリスク許容度に応じて選ぶことになる。

CBACポリシーの具体例 — リソースごとに判断が変わる

CBACの勘所は、同じ人でも状況で結果が変わる/人間とワークロードで扱いが違うことにある。クレジットカードの例で、リソースごとにポリシーを並べると、その違いが具体的に見えてくる。

リソース状況(コンテキスト)判定備考
引受審査アプリ(内部・機微)引受担当者+管理端末(準拠)+社内/VPN+MFA+低リスク許可セッション短時間・再評価
引受審査アプリ同じ担当者だが私物端末・自宅からstep-up+読取のみ権限を状況で縮小
カード会員データ(最重要・PII)決済アプリのサービスアカウント+mTLS+想定経路許可(該当レコードのみ)正規ワークロード
カード会員データ人間ユーザーが直接クエリ/大量エクスポート拒否+アラートアプリ経由のみ許可
カード申込(外部・B2C)顧客+MFA+既知デバイス+低リスク許可—
カード申込新規デバイス/不可能移動(地理的に不自然)step-up(追加認証)—
ATM(非人間)登録済みATM+証明書+EMV認証+営業時間内許可(限度内)—
ATM証明書失効/未登録端末拒否—

表3:クレジットカードの各リソースに対するCBACポリシーの例

同じ「引受担当者」でも、管理端末・社内なら通し、私物・自宅なら追加認証のうえ読み取り拒否だけに絞る。カード会員データは、正規のワークロード(決済アプリ)からは許可するが、人間の直接アクセスや大量エクスポートは拒否する。誰か(役割)だけでなく、どこから・どの端末で・どんなパターンかまで見て判断するのがCBACである。

CBACをどんな技術で実装するか

では、こうしたポリシーを実際に動かすのは何か。CBACは単一の製品ではなく、次のような技術・仕組みの組み合わせで実装される。

  • ポリシー言語/ポリシーエンジン:ABAC/PBACを表現・評価する仕組み。標準としてはXACML、軽量なものではOPA(Open Policy Agent)/Regoなどのポリシーエンジンで、属性と条件からなるルールを評価する。
  • IdPの条件付きアクセス:多くのアイデンティティ基盤が、ログイン時に場所・デバイス状態・リスクを評価してMFAや拒否を出す「条件付きアクセス」機能を持つ。CBACの一部を担う。
  • リスクエンジン(継続的評価):UEBA(利用者・端末の挙動分析)やリスクスコアリングが、脅威・不審度をリアルタイムに算出してPEに供給する。
  • 属性・信号のソース:デバイスのポスチャーはEDR/MDMから、本人性はIdPから、機微度はデータ分類から。これらが判断材料(属性)になる。
  • 実施点(PEP):ZTNA/SDPゲートウェイ、APIゲートウェイ、サービスメッシュ、リバースプロキシなどが、PEの判定を実際に強制する。

実装の型としては、判定を毎回外部のポリシーエンジンに問い合わせる型(PEP↔PDP分離)と、各サービスにポリシーを配布して手元で評価する型(サイドカー等)がある。前者は一元管理しやすく、後者は低遅延で大規模な環境に向いている。いずれも「属性を集め、ポリシーで評価し、動的に判定し、継続的に再評価する」という流れは同じである。

なお、ここで挙げたXACML・OPA・条件付きアクセス・UEBAなどは実装手段の代表例であり、特定製品の推奨ではない。自組織の環境(クラウド/オンプレ、コンテナの有無など)に応じて選択、および組み合わせることになる。

既存環境からどう移行するか

ゼロトラストアーキテクチャは、既存の仕組みを一度に置き換える「入れ替え」ではなく、段階的な移行として進める。次のような考え方が必要である。

  • ギャップ分析:現状のアーキテクチャと、目指すゼロトラストの状態との差を洗い出す。
  • 既存アーキテクチャからの移行:一斉ではなく、プロテクトサーフェス単位で少しずつ移行する(重要資産=クラウンジュエルは、練習を積んでから)。
  • 情報セキュリティポリシーとの整合:既存のポリシーやガバナンス(ISMS等)と齟齬がないように揃える。
  • マネージドサービスか内製か:自組織の体制・スキルに応じて、外部サービスの活用と内製を選択する。

実装後は、トランザクションフローに照らしたアーキテクチャのレビュー、テスト、継続的改善を回していく。ここは次回のステップ4・5(ポリシー、監視と保守)にもつながる。

まとめ

第3回では、マッピングした流れを土台に、ゼロトラスト環境を設計するステップ3を扱った。要点は次のとおりである。

  • 中核はPDP(判断=ポリシーエンジン+ポリシー管理者)とPEP(強制=関所)。データソースが判断を支え、自動化が前提になる
  • 設計の柱はマイクロセグメンテーション・コンテキストベースのアクセス制御・最小特権・暗号化・監視/ログ
  • 実装パターンはSDP・ZTNA・BeyondCorp・NISTアプローチなど。用途に応じて選び、組み合わせる
  • 設計はプロテクトサーフェス単位でPEPを配置し、既存環境からは段階的に移行する

守る対象を定め(ステップ1)、流れを可視化し(ステップ2)、アーキテクチャを構築した(ステップ3)。次回(第4回)は、ステップ4「ゼロトラストポリシーの作成」を扱う。配置したPEPに、実際にどのようなルール(誰に・何を・どの条件で許すか)を持たせるか。アクセスポリシーを具体的に定義していく。

以上

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第2回:ステップ2 トランザクションフローのマッピング

2026年8月25日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回では、ゼロトラストの出発点である「プロテクトサーフェスの定義」を扱い、守るべき対象をDAAS(データ、アプリケーション、資産、サービス)として業務単位で束ねる考え方を扱った。守る対象が定まったら、次は何をするか。それが本編のステップ2「トランザクションフローのマッピング」である。

図1:ゼロトラスト導入の5ステップと、本稿が扱うステップ2(CSA文書を基に作成)

ステップ2のねらいを一言でいえば、プロテクトサーフェスの周りを、データやトランザクションがどこをどう流れているかを可視化・文書化することである。これにより、業務システムが実際にどう動くかを理解し、後続のステップ3(アーキテクチャ構築)とステップ4(ポリシー作成)でコントロールをどこに置くかを判断できるようになる。ここでは、CSAが公開した「ゼロトラストのためのトランザクションフローのマッピング」(以降、CSA文書と略称)の内容を元に説明する。

トランザクションフローとは何か

トランザクションとは、アプリケーションやサービスを通じたデータへのインターフェースであり、データの取得・処理・移動・永続化を含んでいる。ここでいうトランザクションフローは、金融取引や特定の機密情報だけを指すのではなく、あらゆる情報・データのフローを意図している。データは複数のプラットフォーム・サービスプロバイダ・地理的領域・ユーザーを横断して流れるため、その全体像を捉えるのは複雑な作業になる。

ステップ2で理解・文書化するのは、たとえば次のような事項である。

  • アプリ、データ、インフラにアクセスするリソース(ユーザー、API、Webサービスなど)
  • 各アプリケーションとそのデータの関係(取得、転送、移動、永続化を含む)
  • DAAS要素が、相互に、またプロテクトサーフェス外の資源とどう相互作用・通信するか
  • トラフィックがネットワークをどう通過し、異なるセグメントや境界を越えて流れるか
  • 各インタラクションやデータフローの背景にある業務上の文脈と根拠

なぜマッピングするのか — 何が分かるか

これらを可視化・文書化することで、組織は次のような知見を得られる。いずれも後続のステップに直接つながる。

  • 各プロテクトサーフェスを効果的に囲むネットワークセグメンテーションの方法
  • セキュリティコントロールとポリシー実施ポイント(PEP)を戦略的に配置すべき場所
  • ポリシーに基づき明示的に認可・拒否すべきトラフィックパターンと通信チャネル
  • DAAS要素の機能や相互作用に整合したZTアーキテクチャの設計方法
  • アイデンティティ・デバイス・ネットワークの要素を反映した、プロテクトサーフェスごとのアクセスポリシー

何を可視化するか — ステップ2の活動

CSA文書は、ステップ2の活動を次のように整理している。ステップ1で作った「守る対象の一覧」を、動きの面から検証・精緻化していくイメージである。

  • DAAS要素を検証し、そのメタデータを精緻化する
  • ユーザーと、使用するエンドポイント端末の種類を特定・文書化する
  • 依存関係(関連する業務システムや外部サービス)を特定する
  • DAAS要素間・ユーザー・他システム・外部サービスとのトランザクションを特定する
  • データフローをマッピングし、システムの動作を文書化する
  • 本番/バックアップ・災害復旧/単一障害点(SPOF)/開発・テストのどれに当たるかを見極める

マッピングの進め方 — 2つのアプローチ

DAAS要素の機能と相互作用を理解し文書化するには、大きく2つのアプローチがある。両者は互いに補い合う形になる。

① 包括的なシステム分析(既存アーティファクトの活用)

ネットワーク図、アプリケーションアーキテクチャ図、データフロー図、ユーザーインタラクション図、脅威モデル、事業継続/災害復旧計画といった既存の資料を持ち寄り、足りなければ新たに作成する。そのうえで、業務システムオーナーやネットワーク・アプリ・エンタープライズの各アーキテクト、データ管理者などのステークホルダーと連携し、システムの動作・目的・主要リスクを理解する。現代のアプリケーションはモノリシックから、マイクロサービス・コンテナ・サーバーレスといったモジュール化・分散化へと変化しているため、マルチティア(N層)構成での層内・層間のデータフローにも注意する。

② スキャン・モニタリングツールの活用

既存資料だけでは実態と食い違うことがあるため、実際のトラフィックを観測するツールを組み合わせる。これらは直接トランザクションをマッピングするわけではないが、収集情報を突き合わせることでフローの理解を深められる。

ツールの種類(例)取得できる主なデータ
アプリ可観測性(Jaeger、OpenTelemetry等)トレースデータ、パフォーマンス指標
ログ分析(Splunk、ELK等)ユーザー活動(認証・アクセス・データ変更)、各種ログ
APIモニタリング(Postman、Apigee等)API呼び出し・ステータス・利用状況(利用パターン、トラフィック)
ネットワーク(Wireshark、Nagios等)トラフィック(ヘッダー・ペイロード・プロトコル)、機器状態
コンテナ(Cilium、Calico等)コンテナのトレース、トラフィック種別、サービス定義・ラベル

表1:トランザクション把握に使うスキャン・モニタリングツールの例(CSA文書 を基に作成)

なお、暗号化はメタデータや内容を隠すためマッピングを難しくしてしまう。その場合は、パケットサイズ・タイミング・方向などのメタデータ分析(復号せず、通信の外形から推測)、管理された環境でのTLS検査(通信路で復号して直接見る)、あるいはアプリログ・テレメトリを用いたアプリケーション層の可視性(通信路ではなく、アプリの記録から見る)で補う必要がある。

具体例:クレジットカードサービスのトランザクションフロー

CSA文書は、第1回と同じ架空の金融サービス組織を例に用いている。ここでは重要な業務システムとしてクレジットカードサービスを取り上げ、そのトランザクションフローをたどる。まず、このプロテクトサーフェスを構成するDAAS要素を検証する。

DAAS要素クレジットカードサービスでの内容(例)
データカード会員データ、個人識別情報(PII)
アプリケーションクレジットカードWebアプリ、引受審査アプリ
資産アプリケーションとデータベースをホストするサーバー
サービスカード申請・決済取引・カード審査・カード照合・カード印刷・レポート生成、DNS、アイデンティティサービス

表2:クレジットカードサービスのDAAS要素(CSA文書 を基に作成)

次に、このシステムに関わる人間ユーザーと非人間ユーザー(APIや外部インターフェースのアイデンティティ)を特定する。人間ユーザーは、内部・外部の全関係者を、それぞれの情報源から洗い出す。

人間ユーザー例情報源
内部ユーザー従業員、契約社員、派遣社員、システム管理者、特権ユーザーIAM、従業員ディレクトリ、人事記録、アクセスログ
外部ユーザー顧客、パートナー、サプライヤー、ベンダー、第三者サービス、ゲスト顧客データベース、パートナーポータル、ベンダー管理システム

表3:プロテクトサーフェスの人間ユーザー(CSA文書を基に作成)

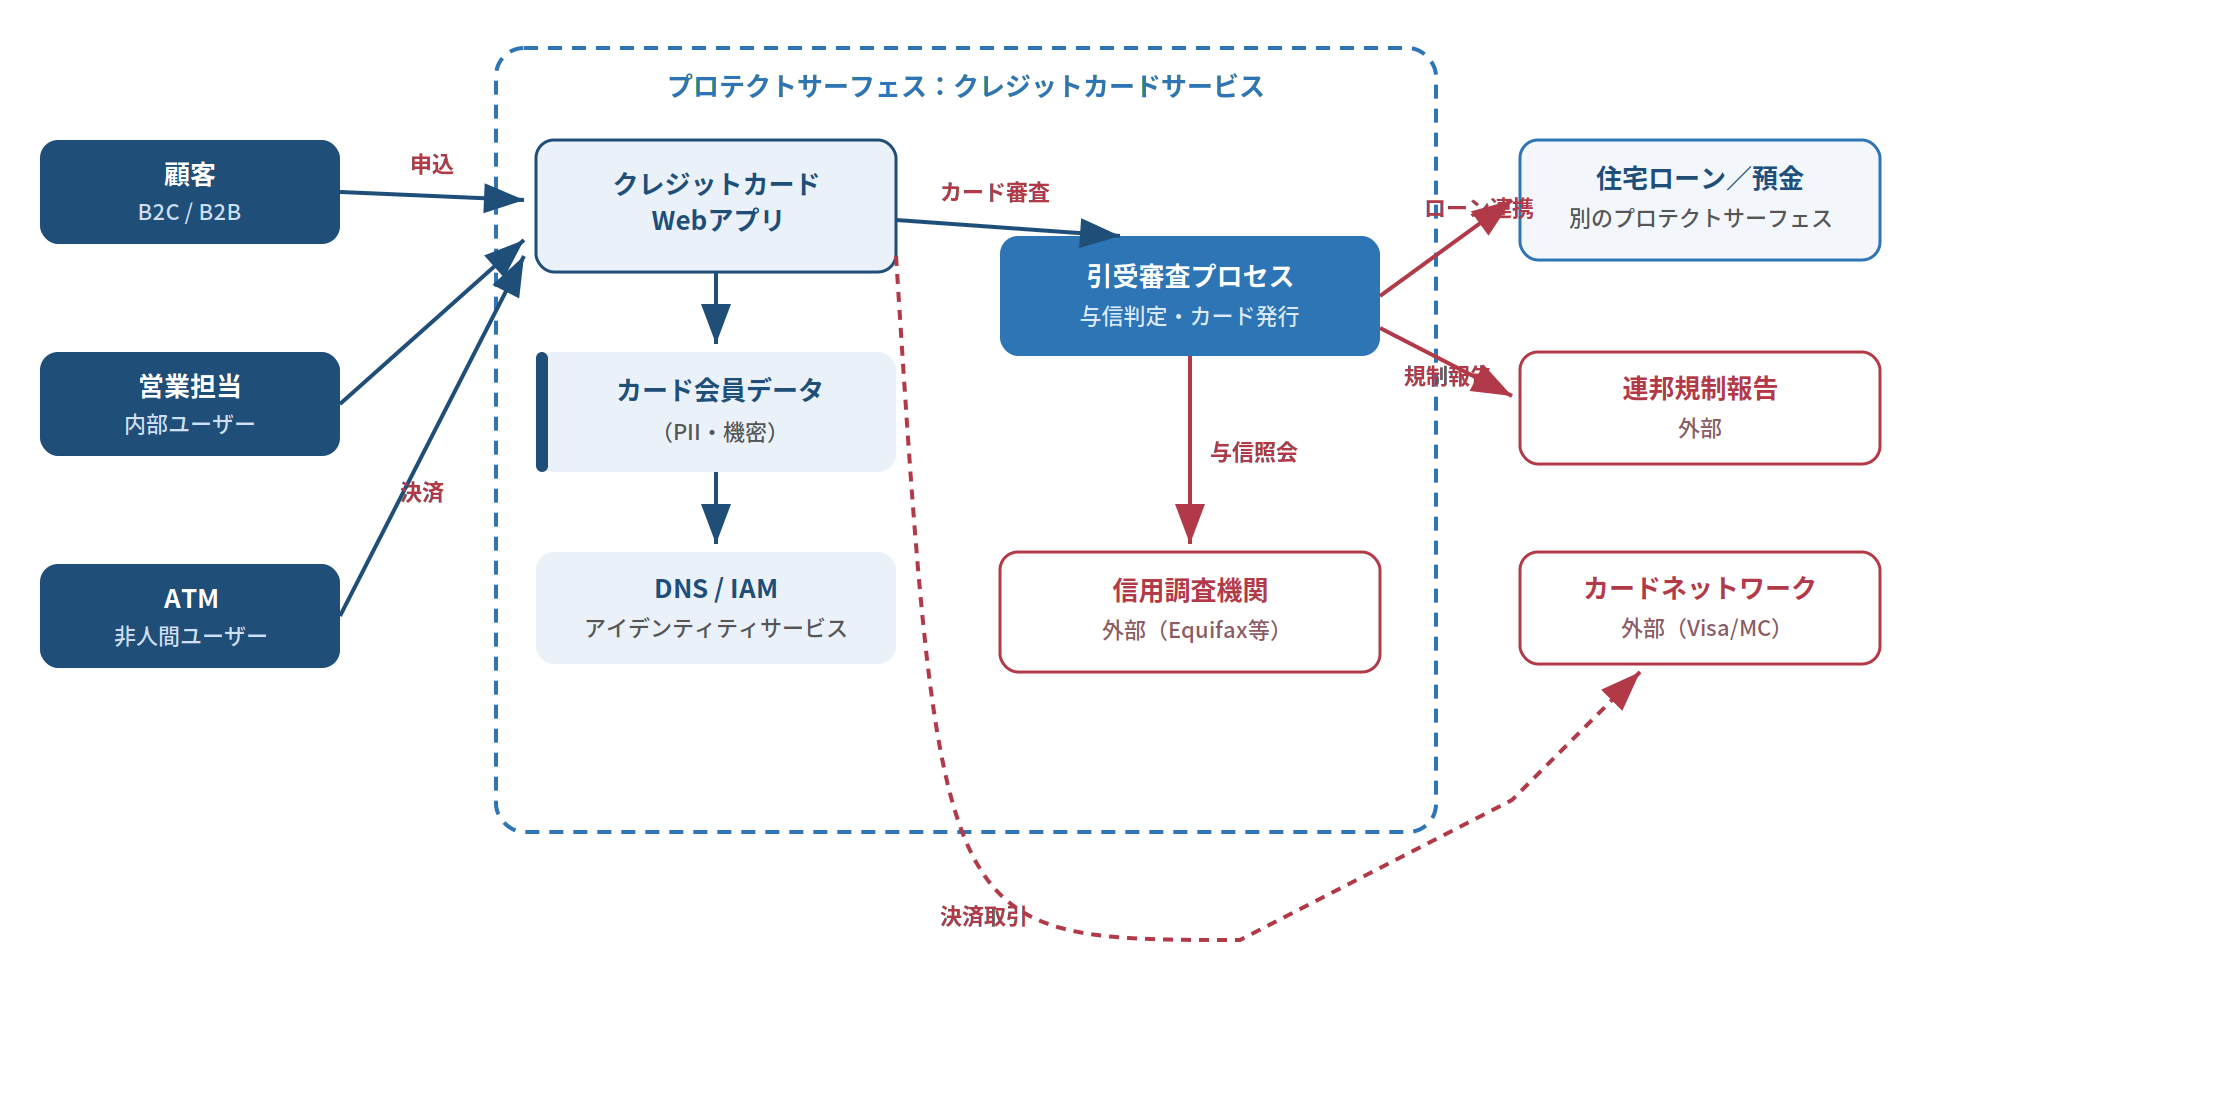
続いて依存関係を特定する。内部依存(他のプロテクトサーフェスやライブラリ)、プロセス依存(ワークフロー、バッチ処理)、外部依存(サードパーティ、外部データソース、規制・契約)を洗い出す。クレジットカードサービスでは、信用調査機関・連邦規制報告・ATMといった外部サービスや、Active Directory・住宅ローン/預金サービス・DNS・アイデンティティサービスといった他の保護対象が関わってくる。

これらを踏まえてトランザクションフローをマッピングすると、次のように可視化できる。

図2:取引をマッピングしたクレジットカード・プロテクトサーフェス(CSA文書を基に作成)

各トランザクションは、送信元・宛先・通信方法(プロトコル、暗号化)・認証・サービスといった属性まで具体的に文書化する。抜粋すると次のようになる。

送信元トランザクション通信(プロトコル等)宛先サービス
顧客新規申込(PIIを含む)HTTPS、JSON、TLSカードWebアプリカードの申し込み
ATM現金引き出し・カード情報XML/JSON、EMVチップ認証ATM決済取引
カードWebアプリ新規カード判定(PIIを含む)HTTPS、RESTful、OAuth2.0、TLS引受審査アプリカード審査
引受審査アプリ与信照会(顧客の詳細)HTTPS、RESTful、OAuth、JWT信用調査機関信用調査API
引受審査アプリ規制報告(PIIを含む)HTTPS、XML、TLS連邦政府規制報告
住宅ローンローン詳細の確認SOAP、JSON、JWT引受審査アプリローンサービス

表4:クレジットカード・プロテクトサーフェスの取引詳細(抜粋。CSA文書 基に作成)

環境ごとの違い — クラウドとOT/IoT

マッピングの進め方は、環境によって大きく異なる。クラウドでは、IaaSの仮想マシン、PaaSのFunction、コンテナ(K8s)ワークロード、SaaS APIで性質が違うため、資産の重要度と望ましいコントロールレベルを設定する。CSPが提供するモニタリング・分析ツール(CloudWatch、Azure Monitor等)やクラウド固有のログを活用して可視化する。

OT/IoTでは、産業用制御システム(ICS)、SCADA、ビル管理、PLCといった対象があり、センサー/アクチュエーター(エッジ)、IoTゲートウェイ、IoTプラットフォーム、クラウド/リモートサービスの相互作用を確実に含める。デジタル環境全体でトランザクションを統一的に把握するには、オンプレ・クラウド・OT/IoTのデータを統合した一元的なビューを作ることが鍵になる。

マッピングの成熟度モデル

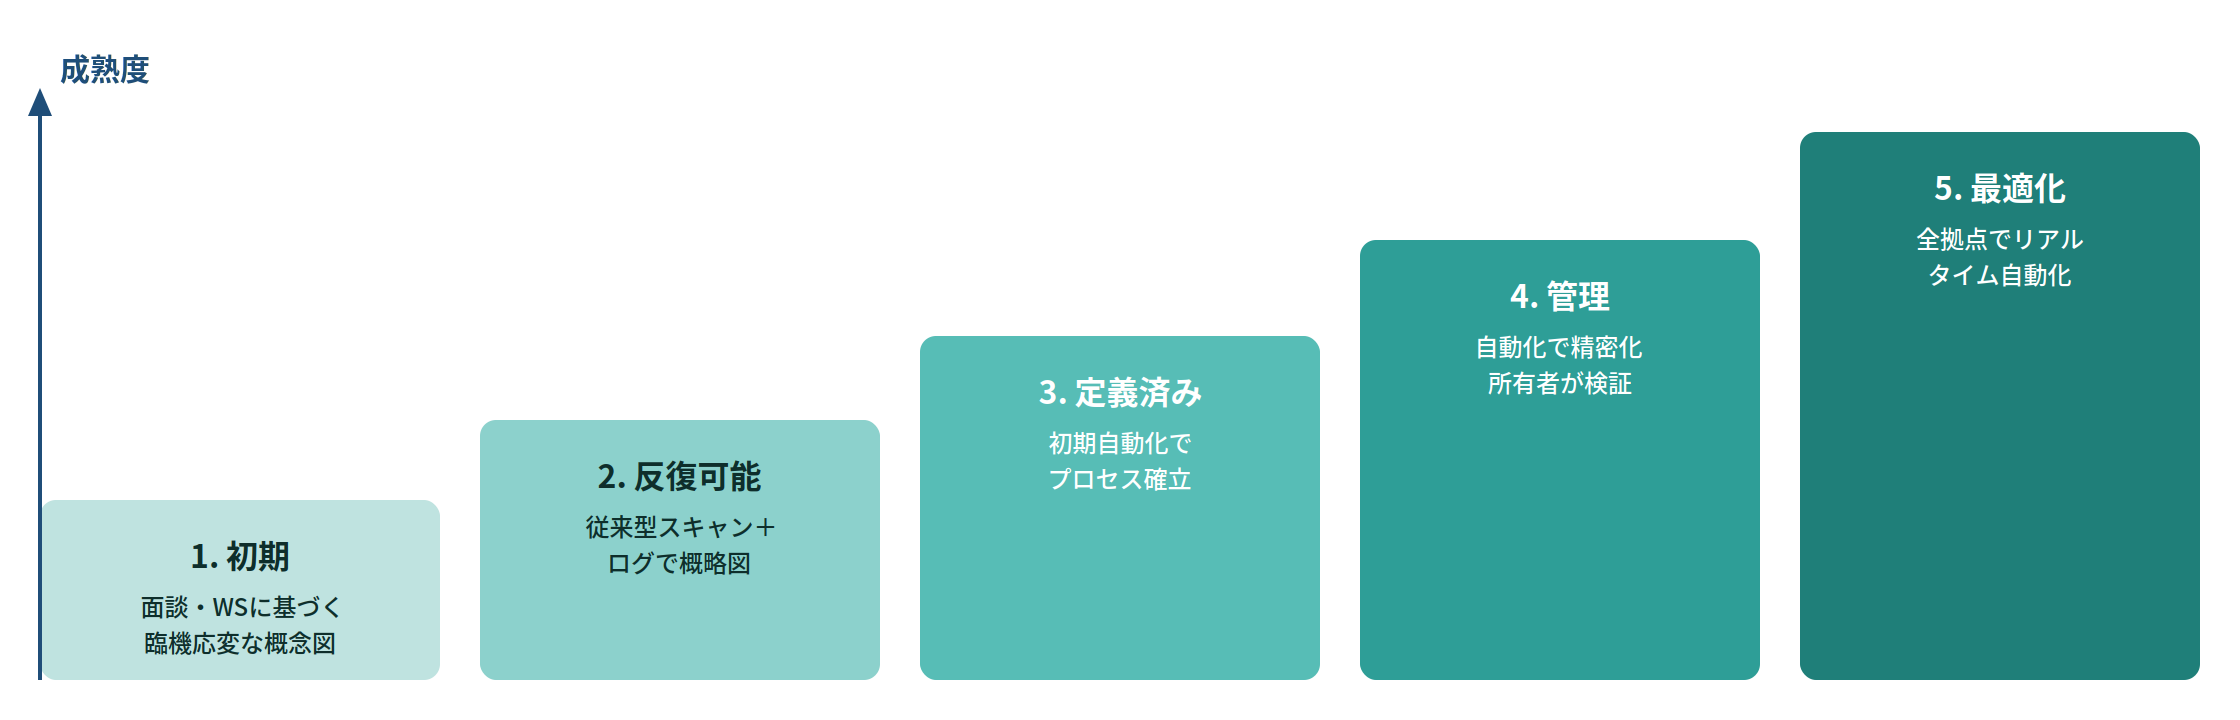
CSA文書は、トランザクションフローマッピングのプロセス成熟度を評価・改善するための5段階モデル(TFMPMM)を示している。臨機応変な段階から、自動化・リアルタイム化へと段階的に高めていく。

図3:トランザクションフローマッピングの成熟度モデル(CSA文書を基に作成)

マッピングでプロテクトサーフェスを精緻化する

トランザクションフローマッピングは、データフローの全体像を与え、すべてのユーザーとDAAS要素を特定できるようにする。その結果、理解されていない・冗長な・廃止された・業務に不可欠でなくなったフローを見つけ出せる。不要なDAAS要素を除去し、不足している要素を追加して、当初のプロテクトサーフェスを精緻化する。

注意:重要なサービスを止める前には、業務中断・セキュリティ課題・データ損失を避けるための備えが要る。関係部門(IT・セキュリティ・コンプライアンス・業務・アプリ所有者)と影響を確認し、依存関係をマッピングし、少なくとも1年分のログ・利用パターンを確認して利用頻度や役割を判断する。停止がセキュリティに与える影響も評価し、問題が起きたときに素早く戻せるロールバック計画を用意しておく。

こうして公開サービスを最小限に抑え、明確に定義され保護された境界を確立することで、アタックサーフェスを効果的に削減できる。精緻化を自動化すれば、削除・制限したサービスやプロトコルが再出現しても事前に検知・緩和でき、アタックサーフェスを長期にわたり最小に保つことができる。

まとめ

第2回では、守るべき対象(プロテクトサーフェス)の周りを、データとトランザクションがどう流れるかを可視化するステップ2を扱った。要点は次のとおりである。

  • 目的は、業務システムの動作を理解し、コントロールをどこに置くかを後続ステップに示すこと
  • 活動は、DAASの検証・ユーザーと依存関係の特定・トランザクションとデータフローのマッピング・本番/バックアップ等の区別
  • 進め方は、既存アーティファクトの分析とスキャン・モニタリングツールの組み合わせ(暗号化はメタデータ分析等で補う)
  • 成果として、プロテクトサーフェスを精緻化し、アタックサーフェスを削減できる

守る対象が定まり、その周りの流れが見えたら、次はいよいよ実装である。次回(第3回)は、ステップ3「ゼロトラストアーキテクチャの構築」を扱う。マッピングしたトランザクションフローを基盤に、ポリシー実施ポイント(PEP)を配置し、マイクロセグメンテーションやコンテキストベースのアクセス制御、最小特権を設計していく。

以上

ISO/IEC 27017:2026役割の位置付けと管理策の変更点

「ISO/IEC 27017:2026役割の位置付けと管理策の変更点」を公開しました(2026年8月18日)。本書は、2026年7月30日にガイダンスWGが公開した「ISO/IEC 27017:2026 における役割の位置付けと管理策の対応関係」V1.1に「管理策別 変更点一覧」を追加し、新たにV2.0として公開したものになります。

本書は、2026年7月27日に公開されたISO/IEC 27017:2026について、以下の2つを扱っています。第1に、CSU(クラウドサービスユーザー)、CSN(クラウドサービスパートナー)、およびシステムインテグレータ(SIer)の位置付けと、新設管理策5.39の内容を整理します。第2に、ISO/IEC 27017:2015からの変更点を、クラウドサービス固有の手引きについて管理策単位で示し、その背景を分類します。なお、本書はISO/IEC 27017:2026及びISO/IEC 27017:2015を参照して作成した独自の分析・要約文書であり、両規格の発行元とは無関係です。両規格本文の複製を目的とするものではなく、変更点の要約及び分析にとどめています。正確な文言及び規格の全体構成を要する場合は、正規の販売経路から購入し、使用許諾を得た規格書原本を参照してください。

資料はこちらからダウンロードしてください。

本資料の内容についてのコメントをこちらのブログに書き込んでください。

ゼロトラスト実装の5ステップ(NSTACモデル)入門 ~ 第1.5回:ゼロトラストの位置づけ — 情報セキュリティ全体の中でどこを担うのか

2026年8月11日
ゼロトラストWGリーダー 諸角昌宏

この回のねらい

第1回では、ゼロトラストの出発点である「プロテクトサーフェスの定義」を扱い、守るべき対象をDAAS(データ・アプリケーション・資産・サービス)として業務単位で束ねる考え方を見た。すると自然に、次のような疑問が湧いてくる。

「ゼロトラストは、組織の情報セキュリティ全体の中でどこを担うのか。ISMSやCSFといったリスク管理の枠組みがあれば、それで十分ではないのか。」

今回(第1.5回)では、この問いについて考える。ここでは、ゼロトラストを情報セキュリティリスクマネジメントの国際規格 ISO/IEC 27005(および ISO/IEC 27001)と突き合わせ、役割分担を明らかにすることとする。結論を先に言えば、ゼロトラストはリスク管理に取って代わるものではなく、その中で「技術的な情報資産への防御」を担う実装である。

結論:リスク管理の枠組みとゼロトラスト・アーキテクチャは役割が異なる

まず全体像を押さえる。ISMS(ISO/IEC 27001、27005)やCSFは、「何を・どこまで守るか」を決める“傘”(計画・統治)である。組織のあらゆる資産である情報・業務プロセス・ソフト・ハード・ネットワーク・要員・拠点・組織を洗い出し、リスクを評価し、対応方針(修正・保有・共有・回避)を決める。いわば防犯計画にあたる。

一方、ゼロトラストは、その計画に基づいて「情報資産へのアクセスを実際に守る」実装の一つである。防犯計画に対する「各部屋の鍵と、入るたびの本人確認」にあたる。計画書だけでは侵入者は止まらない。止めるのは実際の鍵であるゼロトラストのような具体策である。

図1:ISMS/CSFという「傘」(計画・統治)の下で、ゼロトラストが技術層を担う。物理・人・組織は別の層が担い、重ね合わせて全体を守る

重要なのは、両者は競合せず重ねて使うという点である。ISMS/CSFだけでは、計画はあっても実際に守る手段が空く。ゼロトラストだけでは、守る手段はあっても全体を見渡す計画がない。両方そろって初めて、計画に沿ってアクセスを確実に守れることになる。

前提の共有:ISO/IEC 27005 の資産分類

ISO/IEC 27005:2022 は、リスク特定の方法として資産ベース(asset-based)とイベントベース(event-based)の2つのアプローチを示している。両者は排他的なものではなく、リスクシナリオの構築において組み合わせて用いることができる。本ブログでは、ゼロトラストのプロテクトサーフェスとの関係を説明しやすい資産ベースの捉え方を軸に取り上げる。

ISO/IEC 27005 は、守るべき資産を2種類に分けて捉える。

  • 主要資産(primary assets) — 組織にとって価値の源泉。「情報」と「業務プロセス・活動」の2つからなる。
  • 支援資産(supporting assets) — 主要資産が依存する構成要素。ソフトウェア、ハードウェア、ネットワーク、要員、拠点、組織体制など。

ここで大切なのは、ISO/IEC 27005は、人・物理・組織まで含めた「すべての資産」を洗い出すことを前提にしている点である。何があるか分からなければリスクも評価できない、という建て付けであり、NIST CSFも最初の機能が「識別(Identify)」であるように、網羅はリスク管理の出発点になる。つまり、組織全体の「網羅」を担保するのは、この傘(ISMS)側の役割である。

補足:リスクの捉え方 — 資産ベースとイベントベース

ISO/IEC 27005:2022 は、リスクを特定する方法として、性格の異なる2つのアプローチを認めている。

アプローチ起点・向き特徴
資産ベース(asset-based)資産を起点に積み上げる(ボトムアップ)資産 → 脅威・脆弱性 → 影響、と評価する。網羅的だが、資産が多いと粒度が細かくなり工数がかかる
イベントベース(event-based)リスクシナリオを起点にする(トップダウン)脅威源・望ましくない事象 → 影響する資産、と評価する。重要シナリオや脅威インテリジェンス・インシデント事例を取り込みやすい

表1:ISO/IEC 27005:2022 の2つのリスク特定アプローチ

2022年版では、この2つは排他ではなく組み合わせて使える。本ブログが資産ベースに軸足を置くのは、恣意的な省略ではない。ゼロトラストのプロテクトサーフェス定義(DAASの洗い出し)が、まさに資産を起点に積み上げる資産ベースと対応するからである。一方、イベントベースの「どう攻撃されるか」というシナリオ視点は、ゼロトラストのアタックサーフェスやステップ2(トランザクションフローのマッピング)の発想と親和する。つまりゼロトラストは、資産ベースを土台にしつつ、イベントベース的な視点も部分的に取り込む、と整理できる。

ゼロトラストは「技術的に扱える情報資産」を守る

では、ゼロトラストのプロテクトサーフェス(DAAS)は、この資産のうちどこを守るのか。答えを一言でいうと、技術的に扱える情報資産である。ISO/IEC 27005 の各資産を、その観点で対応づけると次のようになる。

ISO/IEC 27005 の資産種別性質ゼロトラストでの扱い
情報主要資産技術資産データ(D)=守る対象の中核
業務プロセス・活動主要資産—束ねる基準・守る理由(DAASを括る軸)
ソフトウェア支援資産技術資産アプリケーション(A)
ハードウェア・ネットワーク支援資産技術資産資産(A)/通信経路
サービス(DNS・IAM等)支援資産技術資産サービス(S)=それ自体もプロテクトサーフェス
要員(人)支援資産非技術検証される主体(アイデンティティ)として扱う
拠点(サイト)支援資産技術+非技術機器は資産(A)/所在地はコンテキスト/建物は範囲外
組織(体制)支援資産非技術ガバナンスが担う(範囲外)

表2:ISO/IEC 27005 の資産と、ゼロトラスト(DAAS)での扱い。太字はプロテクトサーフェスに束ねて守る技術資産

この表から、2つのことが読み取れる。1つは、情報(データ)を中核に、ソフトウェア・ハードウェア/ネットワーク・サービスという技術系の支援資産が、DAASとしてプロテクトサーフェスに束ねられること。DNSやIAMのような基盤サービスも、それ自体が独立したプロテクトサーフェス(守る対象)として扱われる。ここは、ゼロトラストが漏れなく守る範囲である。

もう1つは、生身の人・純粋な物理(建物や環境そのもの)・組織や統治といった「非技術の領域」は、DAASには束ねられないこと。技術的なコントロール(検証・分離・暗号化・監視)で守る以上、守れる対象も技術的に扱える資産に限られるからである。これらはゼロトラストの範囲の外にあり、後述のとおり別の層が担う。 なお、この線引きは「技術資産か、非技術の領域か」で捉えるのが正確であると考える。たとえばIAMやDNSは、一見すると業務を下支えする補助的な存在に見えるが、技術的な実体をもつため、サービス(S)として守る対象に含まれる。見た目の役割ではなく、技術的に対象化できるかどうかが分かれ目になる。

業務プロセスは「束ねる軸」

2つある主要資産のうち、情報はプロテクトサーフェスに束ねられるが、もう一方の業務プロセスは、束ねられる中身ではなく、束ねる“軸”として働く。たとえば決済システムでは、カード会員データ(情報)は守る対象そのものだが、「支払いを処理する」という業務プロセスは、その周辺のデータ・アプリ・資産・サービスを1つのプロテクトサーフェスとしてまとめる基準になる。整理すると、業務プロセスを軸に、関連するDAASを束ねてプロテクトサーフェスを定義する、というのがいちばんシンプルな言い方になる。

図2:業務プロセスを軸に、関連するDAASを束ねてプロテクトサーフェスを定義する

非技術の領域は誰が守るのか — ISO/IEC 27002 の管理策

「ゼロトラストの範囲の外」と述べた人・物理・組織は、放置されるわけではない。ISO/IEC 27005 が参照する管理策の体系(ISO/IEC 27002:2022)は、管理策を4つのカテゴリに分けており、非技術の領域が、技術と並ぶ独立したカテゴリとして正面から扱われている。

ISO/IEC 27002:2022 の管理策扱う領域・例主な担い手
技術的管理策アクセス制御・暗号化・ネットワーク・ログ・監視ゼロトラスト(情報資産への防御)
物理的管理策入退管理・施設と装置の保護・電源・災害対策物理セキュリティ
人的管理策教育・訓練・審査・雇用/退職の手続き人事・教育(ZTでは人=検証主体)
組織的管理策方針・役割と責任・委託先管理・順守ガバナンス(ISO/IEC 27001/27014)

表3:ISO/IEC 27002:2022 の4つの管理策カテゴリと、主な担い手

つまり ISO/IEC 27005/27002/27001 は、組織・人・物理・技術の4領域すべてを、「資産の洗い出し」と「管理策」の両面からカバーする。ゼロトラストが担うのは、このうち技術的管理策、得に情報資産へのアクセス防御である。人は人的管理策(教育・審査)とアイデンティティ管理で、物理は物理的管理策(入退管理)で、組織・統治は組織的管理策とガバナンス(ISO/IEC 27001・27014)で、それぞれ受け持つ。

それでもゼロトラストをやる理由

ここまでを踏まえると、「ゼロトラストは一部しか守らない。ならばISMSやCSFだけでよいのでは」という疑問が生じるかもしれない。しかし、これは計画と実装を同じ土俵で比べてしまう誤解である。ISMS/CSFは「アクセスを技術的に守れ」と指示するが、その具体的な設計・実装は別に用意しなければならない。ゼロトラストは、その最も効果的な答えの一つである。

しかも、従来の「社内ネットは信頼する(城と堀)」というやり方には、一度侵入されると内部を自由に横移動されてしまうという致命的な弱点があった。ISMSやCSFという計画は、この弱点そのものは直してくれない。ゼロトラストは、まさにこの「内部の暗黙の信頼」を解消するために生まれた具体策であり、クラウド・リモート・コンテナといった境界が消えた現代の環境に適合する。

また、ゼロトラストは「思想」だけの存在ではない。5ステップの後半、ステップ3(アーキテクチャの構築)やステップ4(ポリシーの作成)で、マイクロセグメンテーションやポリシーといった具体的な対策まで実装する。

要するに、「焦点を絞る」というゼロトラストの原則は、守る対象を賢く定める話(技術資産は漏れなく守る)であって、守備範囲を狭めて一部を見捨てる話ではない。足りない領域は他の層が担い、多層で重ねて全体をカバーする。これが設計思想である。

最後に、この位置づけは、ゼロトラストを最も強く推進する米国政府の施策にも表れている。ゼロトラスト導入を義務づけた大統領令14028(2021年)は、その実装を、NISTが標準・ガイダンスで示す移行ステップに沿って進めるよう定めており、ゼロトラストをリスク管理の一環として位置づけている。CISAのゼロトラスト成熟度モデルも、OMB(行政管理予算局)のゼロトラスト戦略を補完する「複数のロードマップの一つ」とされ、ゼロトラストを唯一の完全解ではなく、段階的に進める枠組みの要素として扱っている。本シリーズが土台とするNSTAC報告書は、ゼロトラスト導入を連邦のリスク管理報告(FISMA)と整合させるよう明確に勧告している。つまり、ゼロトラストを強力に進める政府自身が、それを既存のリスク管理と整合させながら実装する前提に立っているのである。

補足:CISA ゼロトラスト成熟度モデルとの関係

米国CISAのゼロトラスト成熟度モデル(ZTMM)は、ゼロトラストを5つの柱(アイデンティティ、デバイス、ネットワーク、アプリケーションとワークロード、データ)と、それらを横断する機能(可視化と分析・自動化とオーケストレーション・ガバナンス)で表している。これは本ブログの整理とよく噛み合うと考えられる。なお、以下に示すDAASとの対応づけは、CISA ZTMMが定める公式な1対1の対応ではなく、概念上の整理である点に留意してほしい。

  • 5つの柱は、DAAS(守る対象)にほぼ対応する。データ→データ、アプリケーションとワークロード→アプリ、デバイス→資産、ネットワーク→通信経路、アイデンティティ→サービス(IAM)と人の扱い。
  • 「人=アイデンティティ」 は、人を守る資産ではなく“検証される主体”として扱うという、本ブログの整理を柱として明示したものである。
  • 横断機能のガバナンス が、ISMS/CSFという傘との接続点になる。純粋な物理や組織統制は、ここでも主対象ではない。
  • ZTMMは「成熟度モデル」 であり、各柱を段階的に高めていく。プロテクトサーフェスごとに成熟度を評価し、練習から本命へ反復的に進めるという第1回の考え方と同じ筋である。

まとめ

ゼロトラストは、組織の情報セキュリティ全体の中でどこを担うのか——この回の答えは次のとおりである。

  • ISMS(ISO/IEC 27001・27005)/CSFが「傘」として、全資産(組織・人・物理・技術)を網羅し、何を・どこまで守るかを決める(計画・統治)。
  • ゼロトラストは、その中の「技術的な情報資産への防御」を担う実装。DAASの範囲は漏れなく守り、ステップ3・4で具体的な対策まで実装する。
  • 人・物理・組織は、ゼロトラストの範囲外。ISO/IEC 27002の人的・物理的・組織的管理策や、アイデンティティ・ガバナンスが担う。
  • 両者は競合せず、重ねて使う。網羅はリスク管理(ISMS, CSF)が担保し、技術的な防御はゼロトラストが引き受ける、という補完関係である。

したがって、「ゼロトラストは何のためにやるのか」への答えは、ISMS/CSFが求める“アクセスを技術的に守る”を、現代の環境で最も効果的に実現する手段だから、となる。次回(第2回)は本編に戻り、ステップ2「トランザクションフローのマッピング」を扱う。守るべき対象が定まったら、次はそのデータやトランザクションがどこをどう流れているかを可視化していく。

以上